
Kitobni o'qish: «Революция разума: на подступах к Сингулярности. Как технологии изменят общество и сознание»
Copyright © 2024 by Ray Kurzweil
All rights reserved including the right of reproduction in whole or in part in any form. This edition published by arrangement with Viking, an imprint of Penguin Publishing Group, a division of Penguin Random House LLC.
© Алексеев А. А., перевод на русский язык, 2025
© Оформление. ООО «Издательство «Эксмо», 2025
* * *
Соне Розенвальд Курцвейл, которую я знаю – и люблю – вот уже пятьдесят лет!
Благодарности
Я хотел бы выразить благодарность моей жене Соне за ее любовь и поддержку в перипетиях творческого процесса и за то, что она делилась со мной идеями в течение пятидесяти лет.
Моим детям Итану и Эми, моей невестке Ребекке, моему зятю Джейкобу, моей сестре Энид и моим внукам Лео, Наоми и Куинси за их любовь, энтузиазм и блестящие идеи.
Моим покойным родителям, Ханне и Фредрику, которые во время прогулок по нью-йоркским лесам рассказывали мне о силе идей и давали мне свободу познавать мир, когда я был еще ребенком.
Джону-Кларку Левину за его тщательные исследования и вдумчивый анализ данных, которые легли в основу этой книги.
Моему давнему редактору в издательстве Viking Рику Коту за его решительность, мудрое руководство и профессиональную редактуру.
Нику Маллендору, моему литературному агенту, за его прозорливость и энтузиазм.
Аарону Клейнеру, моему давнему деловому партнеру (с 1973 года), за его преданность и поддержку на протяжении последних пятидесяти лет.
Нанде Баркер-Хук за ее квалифицированную помощь в написании текстов и организацию моих выступлений.
Саре Блэк за ее выдающиеся исследовательские гипотезы и систематизацию идей.
Селии Блэк-Брукс за ее поддержку и разработку обстоятельной стратегии по распространению моих идей по всему миру.
Дениз Скутелларо за умелое администрирование моей деловой активности.
Лаксману Фрэнку за превосходный графический дизайн и иллюстрации.
Эми Курцвейл и Ребекке Курцвейл за их советы по писательскому мастерству и за их собственные замечательные и очень успешные книги.
Мартине Ротблатт за ее преданную работу над всеми технологиями, о которых я пишу в этой книге, и за наше многолетнее сотрудничество в разработке выдающихся образцов этих технологий.
Моей команде, которая оказала огромную поддержку этому проекту в части исследований, написания текстов и логистики, включая Амару Анжелику, Аарона Клейнера, Боба Била, Нанду Баркер-Хук, Селию Блэк-Брукс, Джона-Кларка Левина, Дениз Скутелларо, Джоан Уолш, Мэрилу Соуза, Линдси Боффоли, Кена Линда, Лаксмана Фрэнка, Марию Эллис, Сару Блэк, Эмили Брэнган и Кэтрин Миронюк.
Опытной и преданной своему делу команде издательства Viking Penguin, включая Рика Кота, ответственного редактора; Эллисон Лоренцен, ответственного редактора; Камиллу Леблан, помощника редактора; Брайана Тарта, издателя; Кейт Старк, заместителя издателя; Кэролин Коулберн, директора по связям с общественностью; и Мэри Стоун, директора по маркетингу.
Питеру Джейкобсу из Агентства талантов (CAA) за его неоценимую поддержку в организации моих выступлений.
Командам Fortier Public Relations и Book Highlight за их исключительный опыт в области связей с общественностью и стратегическое руководство распространением этой книги по всему миру.
Коллегам и всем читателям, которые поделились со мной множеством интересных творческих идей.
И, наконец, всем людям, у которых хватает смелости подвергать сомнению устаревшие представления и использовать свое воображение, чтобы делать то, чего никто раньше не делал. Все вы меня вдохновляете.
Введение
В 2005 году в своей книге «Сингулярность уже близка» я выдвинул гипотезу, что экспоненциальное развитие технологий в ряде взаимосвязанных областей приведет человечество к фундаментальным переменам. Стремительный прогресс затрагивает несколько важнейших сфер человеческой деятельности: вычислительные мощности непрерывно дешевеют; биология человека все лучше поддается пониманию; технологические процессы в электронике становятся все более совершенными, и работа идет на все меньших масштабах. По мере роста способностей искусственного интеллекта и объемов доступных данных цифровые системы оказываются все плотнее интегрированы в работу нашего биологического разума. В конце концов, благодаря нанотехнологиям мы сможем напрямую подключить наш мозг к многослойным облачным нейросетям, что и станет кульминационной точкой в развитии информационных технологий. Мы станем едины с искусственным интеллектом, получив в свое распоряжение вычислительную мощь, в миллионы раз превосходящую ту, что подарила нам природа. Это расширит возможности нашего разума и раздвинет пределы сознания в такой степени, что пока мы даже не в состоянии этого представить. Именно это я имею в виду, когда говорю о достижении Сингулярности.
Термин «Сингулярность» возник в точных науках. В математике он используется для обозначения точки, значение функции в которой невозможно определить, например, из-за невозможности деления на нуль. В физике сингулярность – это точка в центре черной дыры, где плотность вещества стремится к бесконечности и обычные законы физики перестают действовать. Важно отметить, что в нашем контексте мы не будем использовать этот термин в его буквальном значении. Мое понимание технологической Сингулярности не предполагает, что прогресс на самом деле будет идти с бесконечной скоростью, как не означают ничего подобного ни экспоненциальный закон, ни физическая Сингулярность. Черная дыра обладает настолько сильной гравитацией, что даже свет не может ее преодолеть, но квантовая механика не располагает средствами, которыми можно было бы описать объекты в самом деле бесконечной массы. Говоря о Сингулярности, я подразумеваю, что масштаб предстоящих перемен непостижим на текущем уровне развития нашего интеллекта. После преодоления этого рубежа наши способности к познанию за короткий срок должным образом адаптируются.
В своей книге «Сингулярность уже близка» я подробно рассказывал о том, как наблюдаемые долгосрочные процессы могут привести к наступлению Сингулярности примерно в 2045 году, то есть через 40 лет – два поколения – после выхода книги в свет. Даже на таком расстоянии я уже мог делать прогнозы о том, какие силы приведут к этой фундаментальной трансформации, но для большинства читателей в 2005 году эти вопросы не казались достаточно насущными. Многие критики считали, что я слишком оптимистично оцениваю сроки наступления Сингулярности, а некоторые даже полагали, что она вообще невозможна.
С тех пор произошли удивительные события. Вопреки прогнозам скептиков, мы не наблюдаем замедления темпов прогресса. Смартфоны и социальные сети, которых в 2005 году еще практически не существовало, теперь стали неотъемлемой частью нашей повседневной жизни, позволяя большей части населения мира оставаться на связи без перебоев. Разработка новых алгоритмов и появление методов анализа больших объемов данных позволили машинному интеллекту достичь впечатляющих результатов даже быстрее, чем ожидали эксперты в области компьютерных технологий. Теперь ИИ может играть в «Джеопарди!» и го, водить машину, писать сочинения, сдавать экзамены на вступление в коллегию адвокатов и даже диагностировать рак. Мощные и гибкие языковые модели, такие как GPT-4 и Gemini, способны писать программный код на основе инструкций на естественном языке, что еще больше стирает границы между людьми и машинами. Когда вы будете читать эти строки, вполне вероятно, десятки миллионов людей уже смогут напрямую использовать возможности ИИ. Тем временем стоимость расшифровки генома человека снизилась на 99,997 %, а нейронные сети начали совершать открытия в медицине путем моделирования биологических процессов. Кроме того, в ближайшем будущем нам удастся подключить компьютеры непосредственно к мозгу.
В основе этих достижений лежит принцип, который я называю законом ускорения отдачи. Он гласит, что стоимость продуктов информационных технологий снижается в геометрической прогрессии, поскольку каждое новое открытие делает разработку следующих поколений таких инструментов более простой. В результате к моменту написания этой книги один доллар, потраченный на информационные технологии, обеспечивает в 11 200 раз больше вычислительной мощности (с учетом инфляции), чем в год выхода книги «Сингулярность уже близка».
На рисунке, который мы подробно обсудим в следующих главах, показан ключевой фактор, способствующий нашему техническому прогрессу. Это экспоненциальный рост вычислительной мощности, доступной за один доллар, который представлен прямой линией в логарифмических координатах на длительном временном интервале. Как известно, закон Мура гласит, что размер транзисторов постоянно уменьшается, что делает компьютеры все более быстрыми. Однако это лишь одно из проявлений закона ускорения отдачи, который действовал задолго до изобретения транзисторов и будет действовать даже после того, как дальнейшее развитие транзисторов станет физически невозможным и на смену им придут новые технологии. Закономерность, представленная на этом рисунке, сформировала современный облик нашего мира. Практически каждый прорыв в развитии, о котором мы расскажем в этой книге, прямо или косвенно связан с этим фактом.

Мы уверенно и неотвратимо движемся к Сингулярности. Эта книга актуальна, потому что изменения, которые мы переживаем, носят беспрецедентный характер. Закономерности, которые в начале века были едва заметны, теперь затрагивают судьбы миллиардов людей. В начале 2020-х годов мы оказались на крутом участке экспоненциальной кривой, и скорость внедрения инноваций, кажется, не имеет преград. Только представьте: день, когда вы читаете эти строки, гораздо ближе к созданию первого искусственного интеллекта, превосходящего человеческий разум, чем к выходу моей предыдущей книги «Эволюция разума» (2012). И, вероятно, ближе к Сингулярности, чем к публикации «Века духовных машин» (1999). Если говорить о человеческой жизни, то дети, рождающиеся сегодня, к моменту наступления Сингулярности будут как раз оканчивать обучение в колледже. Эта «близость» ощущается гораздо реальнее, чем представлялось в 2005 году.
Вот почему настало время для этой книги. Путь к Сингулярности занял у человечества тысячелетия, и сейчас мы приближаемся к финишу, переходя на быстрый бег. Как я уже говорил в предисловии к книге «Сингулярность уже близка», на момент ее выхода мы «находились на начальном этапе переходного процесса». Теперь же мы достигли его кульминации. Если тогда мы только пытались разглядеть линию горизонта, то сейчас готовы преодолеть последние несколько километров пути.
К счастью, дорога вперед теперь ясно видна. Хотя нам нужно преодолеть еще немало технических сложностей, прежде чем мы достигнем Сингулярности, тем не менее наши основные задачи в этой области стремительно переходят из разряда сугубо теоретических исследований в область практических экспериментов. В ближайшее десятилетие нам предстоит найти общий язык с ИИ, который будет удивительно похож на человеческий разум, а простейшие интерфейсы мозг-компьютер станут частью повседневной жизни, как смартфоны сегодня. Цифровая революция в медицине поможет справиться с множеством заболеваний и существенно продлить период здоровой и активной жизни. В то же время многие работники пострадают из-за экономических потрясений, и все мы в той или иной мере столкнемся с рисками, связанными со злоупотреблением новыми техническими возможностями. По ходу 2030-х годов искусственный интеллект, совершенствующий сам себя, и продвинутые нанотехнологии позволят нам соединиться с построенными нами же машинами, создав как новые возможности, так и неожиданные опасности. Если мы преодолеем технические трудности и решим этические, социальные и политические вопросы, которые встанут перед нами благодаря этим достижениям, то к 2045 году условия жизни на Земле значительно улучшатся. Если же мы потерпим неудачу, под угрозой окажется само существование человечества. В этой книге мы поговорим о последнем отрезке пути к Сингулярности – о наших надеждах и подстерегающих нас опасностях в последние годы существования мира, каким мы знали его до сих пор.
Прежде всего, мы рассмотрим, как именно наступит Сингулярность, и увидим, что это событие является результатом длительных усилий нашей цивилизации по созданию искусственного интеллекта, подобного нашему собственному. Создание искусственного разума, основанного на научных и технических достижениях, неизбежно влечет за собой глубокие философские вопросы. Нам предстоит осмыслить, как грядущие перемены отразятся на нашем восприятии самих себя и на понимании смысла нашего существования. Затем мы обратимся к практическим тенденциям, которые будут преобладать в ближайшие десятилетия. Мы увидим, как закон ускорения отдачи способствует экспоненциальному росту уровня жизни человека по самым различным показателям. Одним же из главных негативных последствий быстрого внедрения инноваций является рост безработицы, вызванный автоматизацией различных процессов. Однако, несмотря на эту проблему, долгосрочные прогнозы оптимистичны, и мы, по сути, не находимся в состоянии конкуренции с искусственным интеллектом.
По мере того как новые технологии будут открывать перед нами все новые горизонты материального изобилия, мы постепенно приблизимся к преодолению следующего препятствия на пути к полному процветанию: хрупкости нашего биологического тела. Следующим шагом станет создание средств, которые позволят нам совершенствовать нашу биологию. Сначала нам нужно будет остановить старение нашего организма, а затем найти способ расширить возможности мозга, что приблизит нас к Сингулярности. Однако такие открытия могут нести в себе и угрозу. Революционные достижения в области биотехнологий, нанотехнологий и искусственного интеллекта могут привести к экзистенциальным катастрофам, таким как разрушительные пандемии или цепные реакции самовоспроизводящихся опасных механизмов. В заключительной части книги мы оценим эти риски, избежать которых будет сложно без тщательного планирования. Однако, как я постараюсь показать, существуют многообещающие подходы к их нейтрализации.
Нам посчастливилось жить в самые интересные и важные времена за всю историю человечества. Никто не знает, какой будет жизнь после наступления Сингулярности. Однако, разобравшись в том, что происходит, и подготовившись к предстоящим переменам, мы можем надеяться, что наша цивилизация успешно преодолеет этот этап своего развития.
Глава 1. На какой из шести стадий мы находимся?
В книге «Сингулярность уже близка» я предложил рассматривать информацию как основу для возникновения сознания. С момента зарождения Вселенной я выделил шесть эр, или стадий, на каждой из которых с помощью доступных средств обработки информации создаются условия для перехода к следующей. Таким образом, на каждом этапе различные процессы прямо или косвенно способствуют эволюции разума.
Начало Первой эры было ознаменовано появлением законов физики и зарождением химии на их основе. Спустя несколько сотен тысяч лет после Большого взрыва начали формироваться атомы, состоящие из протонно-нейтронного ядра, окруженного электронами. Положительно заряженные протоны в ядре атома не должны находиться так близко друг к другу из-за взаимного отталкивания, возникающего в результате электромагнитного взаимодействия. Однако существует отдельное явление, называемое сильным ядерным взаимодействием, которое обеспечивает целостность ядра. Кто бы ни проектировал законы Вселенной, он позаботился о существовании этой силы, без которой атомы не смогли бы образоваться.
Спустя миллиарды лет из атомов сформировались сложные молекулы, содержащие уникальную информацию. Одним из ключевых элементов в этом процессе стал углерод, способный образовывать четыре связи вместо одной, двух или трех, как большинство других атомных ядер. Нам невероятно повезло, что в нашей Вселенной существует такая сложная химия. Если бы гравитация была немного слабее, сверхновые звезды стали бы невозможны, а вместе с ними и химические элементы, из которых состоит жизнь. А если бы гравитация была чуть сильнее, звезды бы выгорали раньше, чем успела бы развиться разумная жизнь. То есть даже одна гравитационная постоянная должна была попасть в очень узкий диапазон значений, чтобы мы могли появиться на свет. Мы живем в тщательно настроенной Вселенной, которая обеспечивает необходимый уровень порядка для успешной эволюции. Несколько миллиардов лет назад началась Вторая эра – эра жизни. Образовались сложные молекулы, способные хранить информацию о целом организме. Благодаря этому живые существа, каждое со своим уникальным набором ДНК, смогли эволюционировать и распространяться по планете.
Третья эра ознаменовалась появлением у живых организмов, созданных на основе ДНК, мозга, который, в свою очередь, может хранить и обрабатывать информацию. Наличие мозга оказалось огромным эволюционным преимуществом, поэтому на протяжении миллионов лет его устройство становилось все более сложным.
В ходе Четвертой эры животные научились использовать высокоуровневые когнитивные функции, а также большие пальцы передних конечностей для совершения сложных действий. Так появился человек. Как биологический вид мы сумели применить свои способности и создать средства для хранения, передачи и преобразования информации. Эти технологии, начиная с папируса и заканчивая накопителями на магнитных дисках, дополнили возможности нашего мозга по восприятию, извлечению из памяти и распознаванию образов. Это стало новым этапом эволюции, более значительным, чем предыдущие достижения. В то время как мозг увеличивался в размерах примерно на один кубический дюйм каждые 100 тысяч лет, цифровая революция обеспечивает двукратный прирост вычислительной мощности при той же стоимости каждые 16 месяцев.
При переходе к Пятой эре мы напрямую соединим наш разум с высокоскоростными цифровыми технологиями с помощью так называемого «интерфейса мозг-компьютер». Мозг человека обрабатывает информацию со скоростью несколько сотен циклов в секунду, в то время как электронный мозг – миллиарды циклов в секунду. Вдобавок к увеличению скорости мышления и объема памяти расширение нашего мозга с помощью компьютерных технологий позволит нам добавить к нашему неокортексу много новых иерархических слоев, что выведет наше абстрактное мышление на такой уровень сложности, который мы сейчас даже не можем себе вообразить.
По ходу Шестой эры наш разум распространится по всей Вселенной, превращая любое вещество в компьютрониум – особую форму материи, внутреннее устройство которой позволяет производить вычисления с максимальной эффективностью.
В своей книге «Век духовных машин», вышедшей в 1999 году, я высказал мнение, что искусственный интеллект сможет пройти тест Тьюринга – а именно: успешно притвориться человеком, общаясь с помощью текстовых сообщений – не позднее 2029 года. Я подтвердил свой прогноз в книге «Сингулярность уже близка», опубликованной в 2005 году. Прохождение теста Тьюринга будет означать, что ИИ освоил язык и способен рассуждать на уровне человека. Концепцию этого теста в 1950 году предложил Алан Тьюринг1. Однако он не уточнил, каким именно образом следует проводить экзамен. Мы с Митчем Капором заключили пари насчет моего прогноза, ориентируясь на разработанный нами вариант правил, намного более строгий, чем те, что обсуждались ранее в связи с этим вопросом.
Я отдавал себе отчет, что для успешного прохождения ИИ теста Тьюринга к 2029 году разработчикам нужно будет преодолеть немало технических сложностей уже к 2020-му. В самом деле, за последние десятилетия ИИ успешно справился с рядом сложных задач, поставленных перед ним человечеством: от игр, таких как «Джеопарди!» и го, до важнейших прикладных задач, таких как лучевая диагностика и разработка лекарств. Сегодня передовые нейронные сети, в частности Gemini и GPT-4, постоянно совершенствуют свои возможности, расширяя круг подвластных им областей деятельности и все сильнее приближая нас к созданию искусственного интеллекта общего назначения.
Строго говоря, чтобы пройти тест Тьюринга, ИИ придется притвориться существенно менее продвинутым во многих аспектах, иначе он быстро выдаст себя. Например, мгновенно решая любую математическую задачу, он провалит тест. Поэтому на стадии успешного прохождения теста Тьюринга ИИ будет обладать способностями, значительно превосходящими уровень мастерства лучших представителей человечества почти во всех областях.
Мы живем в последние годы Четвертой эры и уже сталкиваемся с трудностями в понимании результатов, которые получаем с помощью самых современных технологий. Мы активно работаем над устранением недостатков искусственного интеллекта, которые пока не позволяют ему пройти тест Тьюринга, и добились заметных успехов. Как только ИИ сможет успешно пройти тест Тьюринга, начнется Пятая эра обработки информации.
Ключевым событием в 2030-х годах будет установление прямой связи между новой корой головного мозга человека и облачной вычислительной платформой, что существенно расширит наши умственные способности. В этом смысле ИИ вместо конкурента станет дополнением человека. Когда это произойдет, электронные части нашего разума обеспечат нам в тысячи раз большую интеллектуальную мощь, чем мог бы биологический мозг.
Стремительное развитие технологий приведет к тому, что к 2045 году возможности нашего разума увеличатся в миллионы раз. Этот невообразимый масштаб грядущих перемен позволяет метафорически описать события, которые нас ждут в ближайшем будущем, как достижение сингулярности.
Глава 2. Изобретая разум заново
Что значит воссоздать разум?
Если рассматривать историю Вселенной как эволюцию способов обработки информации, то человек появляется во второй половине этого долгого и удивительного пути. Именно нам предстоит совершить переход от животных, мозг которых состоит из биологического материала, к трансцендентным существам, чья сила разума не ограничена возможностями, которые дает генетика. В 2020-х годах начнется заключительная фаза этого перехода: мы воссоздадим интеллект, который подарила нам природа, только на более совершенном цифровом носителе, а затем сделаем его частью себя. В этот момент Четвертая эра в истории Вселенной закончится и начнется Пятая.
Но каким конкретно образом это произойдет? Чтобы понять, что значит воссоздать мышление, для начала мы вспомним историю появления искусственного интеллекта и два различных подхода, которые возникли в связи с ним. Обратившись к нейробиологии, мы узнаем, как мозжечок и новая кора полушарий головного мозга создают наш разум, и разберемся, почему один из двух подходов оказался более подходящим. Затем мы рассмотрим технологию глубокого обучения, которая имитирует работу неокортекса, и увидим, какими еще способностями должен обладать ИИ, чтобы достичь человеческого уровня, и как мы сможем понять, что это произошло. Наконец, мы обсудим, как при поддержке сверхмощного ИИ нам удастся разработать устройства для подключения нашего мозга к компьютеру. Такие устройства позволят дополнить неокортекс новыми слоями электронных нейронов, что выведет наше мышление на принципиально новый уровень, увеличив скорость работы мозга в миллионы раз. Именно этот феномен я называю достижением Сингулярности.
Появление искусственного интеллекта
В 1950 году британский математик Алан Тьюринг (1912–1954) опубликовал в журнале Mind статью под названием «Вычислительные машины и разум»1. В ней Тьюринг поставил фундаментальный вопрос: может ли машина мыслить? Хотя идея о мыслящих машинах существует со времен древнегреческого мифа о бронзовом автомате Талосе 2, заслуга Тьюринга заключается в том, что он сумел свести эту концепцию к способности, которую можно проверить на опыте. Он предложил так называемую «игру в имитацию», также известную как «тест Тьюринга», в качестве способа определить, могут ли машинные вычисления решать те же когнитивные задачи, с которыми справляется наш мозг. В рамках теста арбитры, являющиеся людьми, общаются одновременно с искусственным интеллектом и участниками-статистами через обмен текстовыми сообщениями. При этом они не имеют никакой информации о своих собеседниках. Судьи могут задавать вопросы на любые темы по своему усмотрению. Если по истечении определенного времени судьи не могут с уверенностью определить, кто из собеседников был искусственным интеллектом, а кто – человеком, то можно считать, что ИИ успешно прошел тест.
Исследователей необычайно воодушевила новая научная формулировка давнего философского вопроса. В 1956 году математик Джон Маккарти (1927–2011) предложил провести двухмесячное исследование в Дартмутском колледже в Гановере, Нью-Гэпмшир, силами группы из десяти специалистов3. Вот как была сформулирована задача:
Исследование имеет своей целью проверить гипотезу, что способность к обучению или любое другое свойство интеллекта могут быть настолько тщательно формализованы, что машина сможет их имитировать. Будет предпринята попытка заставить компьютер пользоваться письменной речью, оперировать абстрактными понятиями, решать задачи, с которыми на данный момент может справиться только человек, а также научить программу совершенствовать саму себя4.
В преддверии конференции Маккарти предложил назвать новую область науки, благодаря которой впоследствии будут автоматизированы многие процессы, «искусственным интеллектом»5. Я не большой поклонник этого названия, поскольку из-за него создаваемый нами разум кажется как будто ненастоящим, но именно этот термин прижился в компьютерных науках.
Исследование провели, но цели, а именно: создать вычислительную машину, способную решить задачу, сформулированную на простом человеческом языке, конечно, за отведенные два месяца не достигли. Собственно, мы до сих пор занимаемся созданием такого компьютера, причем гораздо большими силами, чем десять исследователей. По данным китайского технологического гиганта Tencent, в 2017 году количество специалистов в области искусственного интеллекта во всем мире достигло 300 0006, а в 2019 году в «Обзоре специалистов в области ИИ по всему миру» его авторы Жан-Франсуа Ганье, Грейс Кизер и Йоан Манта насчитали 22 400 экспертов, публикующих статьи с оригинальными исследованиями в области ИИ, из которых 4000 были признаны весьма влиятельными7. По данным Стэнфордского института искусственного интеллекта, ориентированного на человека (Stanford HAI), в 2021 году разработчики ИИ опубликовали более 496 000 статей и подали более 141 000 заявок на патенты8. В 2022 году корпоративные инвестиции в ИИ по всему миру составили 189 миллиардов долларов, увеличившись в 13 раз за прошедшее десятилетие9. К моменту выхода этой книги суммы будут еще более внушительными.
Все это сложно было себе представить в 1956-м, когда участники Дартмутской конференции поставили перед собой задачу, которая не уступала по сложности созданию ИИ, способного пройти тест Тьюринга. Я уверен, что мы достигнем этого уже к 2029 году, и я не изменил своего прогноза, который опубликовал в 1999 году в книге «Век духовных машин»10. В те времена многие обозреватели сходились во мнении, что такого уровня технологий мы не достигнем никогда. Даже совсем недавно коллеги по отрасли считали мой прогноз чересчур оптимистичным. Например, опрос, проведенный в 2018 году, показал, что в среднем эксперты в сфере ИИ считают, что вычислительные машины не достигнут уровня человеческого интеллекта раньше 2060 года11. Однако в свете последних успехов в разработке больших языковых моделей многие ученые скорректировали свои ожидания. Когда я писал черновик этой книги, на сайте платформы для прогнозов Metaculus мнения относительно времени создания достаточно мощного ИИ колебались от 2040-х до 2050-х годов. Но темпы прогресса в последние два года вновь превзошли ожидания, и к маю 2022 года консенсус среди участников на Metaculus стал соответствовать обозначенной мной дате: 2029 год12. С тех пор высказывались и более смелые мнения, в частности, говорили о 2026 годе, так что технически мой изначальный прогноз теперь можно считать консервативным13.
Последнее время новые достижения в сфере ИИ поражают даже экспертов. Открытия не только происходят раньше, чем ожидалось, но главное, что они случаются внезапно, а не назревают в течение долгого времени. Например, в октябре 2014-го Томазо Поджио, эксперт по ИИ и когнитивной нейробиологии из Массачусетского технологического института, отвечая на вопрос журналиста, сказал: «Задача описать, что изображено на картинке, будет одной из самых сложных для искусственного интеллекта. Чтобы приблизиться к ее решению, нам потребуется провести еще множество фундаментальных исследований»14. Согласно оценке Поджио, этот рубеж должен был покориться нам лет через двадцать. Через месяц после этого интервью компания Google представила ИИ, умеющий решать ровно эту задачу – распознавать объекты на изображении. Когда обозреватель журнала New Yorker Раффи Хачадурян попросил Поджио прокомментировать это событие, тот в ответ высказал сомнение, что эта способность отражает наличие истинного интеллекта. Я пишу это не в качестве критики, а как пример общей тенденции. А именно: пока у ИИ не получается решить определенную задачу, нам кажется, что она необычайно сложна и под силу только человеку. Однако как только компьютер с ней справляется, мы склонны обесценивать это достижение. Иначе говоря, мы добились гораздо больших успехов, чем нам самим кажется задним числом. Это одна из причин, почему я не теряю веры в свой прогноз насчет 2029 года.
Почему эти открытия оказались столь неожиданными? Чтобы ответить на этот вопрос, нужно вспомнить одну дилемму, стоявшую перед теоретиками на заре развития отрасли. В 1964 году, еще будучи школьником, я познакомился с двумя выдающимися представителями направления ИИ: Марвином Минским (1927–2016), который был одним из организаторов той лаборатории по ИИ в Дартмутском колледже, и Фрэнком Розенблаттом (1928–1971). В 1965 году я поступил в МТИ, где моим научным руководителем стал Минский. В то время он занимался фундаментальными исследованиями, которые и заложили основы для резкого скачка в развитии нейросетей, произошедшего в последние годы. От него я узнал, что существуют два подхода к автоматизации решения задач: символьный и нейросетевой (так называемый «коннекционизм»).
Символьный подход опирается на перечисление правил, по которым человек, являющийся экспертом, решал бы поставленную задачу. Иногда такой подход себя оправдывает. Например, в 1959 году корпорация RAND представила «Универсальный решатель задач» – компьютерную программу, способную оперировать простыми математическими аксиомами и находить решение логических задач15. Герберт Саймон, Клиффорд Шоу и Аллен Ньюэлл разработали «Универсальный решатель», чтобы получить возможность решать любую задачу, которую можно сформулировать в терминах нормальных форм алгебры высказываний. Чтобы решить задачу, программа обрабатывала одну формулу (аксиому) на каждом этапе процесса, постепенно выстраивая с их помощью доказательство теоремы.
Даже если вы не знакомы с формальной логикой или теорией доказательств, понять этот принцип можно на примере алгебры. Если известно, что 2 + 7 = 9 и что к неизвестному числу прибавили 7 и получили 10, можно показать, что искомое число равно 3. Но таким путем можно получать и более сложные результаты. Когда мы задаемся вопросом, соответствует ли некий объект заданному определению, то руководствуемся такой же логикой, даже не отдавая себе в этом отчета. Допустим, мы знаем, что простое число не имеет делителей, кроме 1 и самого себя, а также, что число 11 делит число 22 пополам. Учитывая, что 1 не равно 11, мы можем заключить, что 22 не является простым числом. Имея в распоряжении самые простые и фундаментальные аксиомы, УРЗ может применить подобные рассуждения к существенно более сложным задачам. Математики, строго говоря, именно этим и занимаются, только компьютер в поисках ответа в состоянии (теоретически, по крайней мере) сопоставить аксиомы друг с другом всеми возможными способами.
Представим для наглядности, что у нас есть 10 аксиом, а для решения задачи нужно выбрать одну из них на каждом из 20 шагов. В таком случае существует 1020, то есть миллиард раз по 100 миллиардов возможных вариантов решения. В настоящее время мы можем работать с такими величинами, но у компьютеров 1959 года шансов справиться не было. Электронная вычислительная машина DEC PDP-1 могла выполнять 100 000 операций в секунду16. В 2023-м облачный сервер Cloud A3 компании Google способен совершать примерно 26 000 000 000 000 000 000 операций в секунду17. Сейчас один доллар обеспечит в 1,6 триллиона раз больше вычислительной мощности, чем во времена УРЗ18. На решение задач, с которыми современные домашние компьютеры справляются за несколько минут, у машин 1959 года ушли бы десятки тысяч лет. В попытке преодолеть вычислительные ограничения в УРЗ встроили эвристические алгоритмы, которые ранжировали возможные решения, отдавая приоритет наиболее перспективным. Иногда это срабатывало, и каждый успех вселял надежду, что рано или поздно компьютер сможет решить любую должным образом сформулированную задачу.
Еще одним примером может служить система МИЦИН, разработанная в 1970-х годах для диагностики инфекционных заболеваний и выдачи рекомендаций по лечению. В 1979 году группа экспертов сравнила результаты этой программы с назначениями докторов, и оказалось, что МИЦИН справилась с задачей как минимум не хуже, а иногда и более успешно, чем настоящий врач19.
Типичное «правило» в программе МИЦИН выглядело так:
ЕСЛИ:
1) Заболевание, требующее лечения, – это менингит, и
2) тип инфекции – грибковая, и
3) посев не выявил роста микроорганизмов, и
4) пациент не является ослабленным, и
5) пациент побывал в районе, эндемичном по кокцидиомикозам, и
6) пациент принадлежит к одной из следующих расовых групп: афроамериканцы, азиаты, индейцы, и
7) анализ ликвора на криптококковый антиген не был положительным,
ТОГДА:
Предположительно (с вероятностью 50 %) криптококк не является одним из организмов (помимо тех, которые обнаружились в посевах или мазках), вызвавших заболевание20.
К концу 1980-х годов так называемые «экспертные системы», подобные МИЦИН, начали использовать вероятностные модели и стали учитывать множество источников информации при принятии решений21. В сложных случаях одним правилом типа «если… то» не обойтись, но, скомбинировав тысячи таких логических утверждений, в рамках определенного класса задач система могла предложить достаточно надежное решение.
В рамках символьного подхода исследователи работали более полувека, но не нашли способа преодолеть «потолок сложности»22. Когда МИЦИН или подобные системы допускали ошибку, она поддавалась исправлению, но решение одной проблемы порождало три новые ошибки в других ситуациях. Усложнять экспертную систему удавалось лишь до определенного предела, из-за чего диапазон реальных задач, которые с таким подходом можно было решать, оказывался весьма узким.
Можно рассматривать сложность экспертных систем на основе правил с точки зрения точек отказа. Известно, что количество подмножеств у множества из n-элементов составляет 2n – 1 (не считая пустое множество). Если набор правил ИИ состоит из одного закона, то существует всего одна точка отказа: корректно это правило само по себе или нет. Если правила два, точек отказа будет уже три: две соответствуют каждому из правил в отдельности, а третья относится к их комбинации. С ростом количества правил число возможных точек отказа растет экспоненциально. Пять правил порождают 31 точку отказа, 10 правил – 1023; 100 правил – и точек отказа уже больше тысячи миллиардов умножить на миллиард и еще раз умножить на миллиард, а 1000 правил дают больше гугол умножить на гугол умножить на гугол точек отказа. Из этого, в частности, следует, что чем больше у вас в системе правил, тем больше возможных точек отказа добавит каждое дополнительное правило. Даже если ничтожно малая доля комбинаций из правил работает некорректно, рано или поздно наступит момент (когда конкретно, зависит от задачи), когда добавление нового правила, которое решает проблемную ситуацию, приведет к появлению более одной новой проблемы. Такую ситуацию и называют потолком сложности.
Вероятно, из подобных экспертных систем дольше всего разрабатывалась Cyc (от слова encyclopedic – «энциклопедический»), созданная Дугласом Ленатом и его коллегами по компании Cycorp в 1984 году23. Разработчики преследовали цель зафиксировать все соображения здравого смысла, которые известны людям, например, «брошенное на пол яйцо разобьется» или «ребенок, бегающий по кухне в грязной обуви, вызовет недовольство родителей». Миллионы соображений подобного рода нигде не зафиксированы, но при этом необходимы для понимания того, чем руководствуется среднестатистический человек. Однако, поскольку Cyc хранила эти знания в виде набора правил, она также оказалась подвержена проблеме потолка сложности.
В 1960-х годах мы с Минским обсуждали достоинства и недостатки символьного подхода к созданию ИИ, и в сравнении я начал осознавать преимущества сетевой парадигмы. Коннекционизм подразумевает использование сети простых узлов, которая приобретает функции интеллекта благодаря своей структуре, а не информации в отдельных узлах. Вместо сложных правил система опирается на узлы, которые сами по себе почти ничего не умеют, но, объединенные в большую сеть, способны извлекать информацию из поступающих данных. Благодаря этому такие сети способны находить закономерности, которые никогда не пришли бы в голову программистам, если бы те попытались применить символьный подход. Одним из основных преимуществ сетевого подхода является то, что с его помощью можно решать задачи, не имея готового метода. Ведь даже если бы мы в совершенстве владели навыком правильно формулировать и безошибочно переносить в программу необходимые для работы ИИ правила (а это большое «если»), нам бы все равно мешало отсутствие четкого понимания, какие из них стоит вносить в программу.
Нейронная сеть – это мощный инструмент для решения сложных задач, однако он не лишен недостатков. Построенный по такому принципу искусственный интеллект имеет обыкновение превращаться в «черный ящик». ИИ дает нам ответ, но не в состоянии пояснить, как он пришел именно к такому варианту24. Это свойство угрожает стать серьезной проблемой, поскольку людям хочется знать обоснование принятых решений по важным вопросам, таким как выбор метода лечения, обеспечение соблюдения норм правопорядка, гигиенический надзор, управление рисками. Вот почему в настоящее время ряд экспертов в области ИИ работает над повышением «прозрачности» результатов работы нейросетей (так называемой «механистической интерпретабельности»), иначе говоря, возможности раскрыть причинно-следственные связи, стоящие за их решениями25. Пока неясно, насколько эта цель достижима, учитывая, что многослойные нейросети становятся все более сложными и мощными.
Когда я начинал работать с нейронными сетями, их устройство было гораздо более простым. В основе технологии лежала идея создать компьютерную модель того, как работает центральная нервная система человека. Поначалу это было довольно туманное соображение, потому что моделирование началось еще до того, как ученые смогли более-менее подробно изучить, каким образом организованы сети нейронов в биологическом мозге.
Схема простой нейронной сети
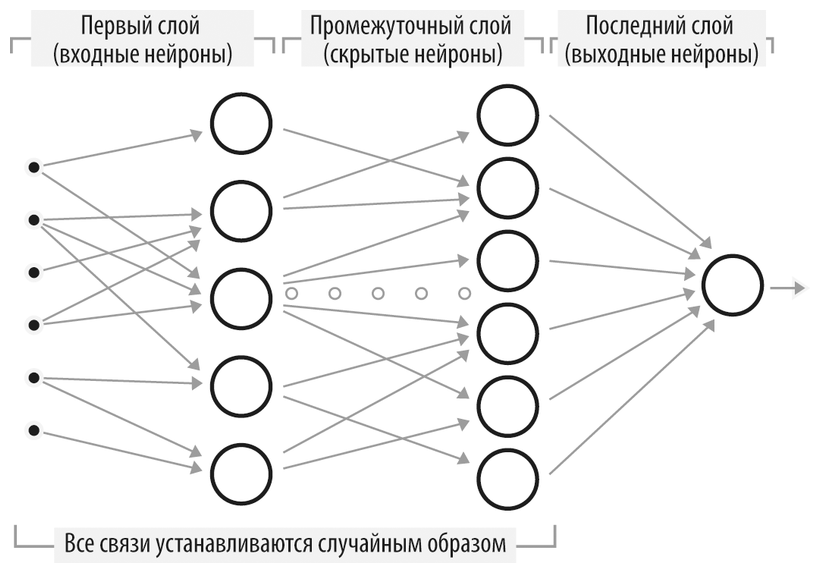
Приведем описание типичного алгоритма на основе нейронной сети. В зависимости от конкретной задачи этот алгоритм может принимать множество форм, но в любом случае при создании системы необходимо выбрать подходящие методы и установить значения ключевых параметров.
Чтобы создать решение на основе нейронной сети, нужно пройти через несколько этапов:
– Определить, какие данные будут использоваться в качестве входных.
– Разработать структуру нейронной сети (то есть задать количество и размеры слоев, а также связи между нейронами).
– Обучить нейросеть на данных с известными ответами.
– Использовать нейросеть для решения новых задач.
– Опубликовать результаты и открыть доступ к своему сервису.
Рассмотрим каждый из этих шагов (кроме последнего) подробнее.
Входные данные
Входные данные задачи, поступающие в нейронную сеть, состоят из ряда чисел. Нейросеть может обрабатывать:
– В задачах распознавания визуальных образов: изображения, представленные в виде двумерного массива чисел, соответствующих пикселям.
– В задачах обработки аудиосигнала (например, речи): звук, представленный в виде двумерного массива чисел, одно измерение в котором соответствует точкам на временной шкале, а второе – характеристикам звука (например, частотным составляющим).
– В задачах распознавания образов произвольной природы: многомерный массив чисел, характеризующих входной образ.
Определение структуры сети
Архитектура нейронной сети определяется связями каждого из нейронов:
– Каждое «входящее» соединение нейрона обычно связано с «исходящим» соединением другого нейрона либо с одним из входных значений набора данных.
– Как правило, единственное «исходящее» соединение служит для передачи результата работы данного нейрона другому, находящемуся в более высоком слое, либо сообщает результат работы всей нейронной сети.
Создание входного слоя нейронов
– Первый слой содержит N0 входных нейронов. Входящие соединения каждого из них связаны с «точками» (то есть числами) из массива входных данных. Количество и структура этих связей могут быть установлены произвольно либо определены с помощью генетического алгоритма (см. описание ниже).
– Для каждого соединения необходимо задать «силу синаптической связи». Начальные значения «весов» связей могут быть равны какому-то одному числу, или заданы случайным образом, или определены каким-либо еще способом.
Создание внутренних слоев нейронов
Необходимо создать M скрытых слоев. В каждом из внутренних слоев:
– Создается Ni нейронов (где i – номер слоя). Входящие соединения каждого из них связываются с исходящими соединениями нейронов в предыдущем слое (см. также раздел «Вариации»).
– Задаются начальные значения «весов» связей, равные какому-то одному числу, определенные случайным образом или другим способом (см. ниже).
– Выходные соединения нейронов в слое с номером M передают итоговый результат работы нейронной сети (см. раздел «Вариации»).
Процесс распознавания
Принцип работы нейрона
Каждый нейрон по ходу одного цикла работы нейросети совершает следующие операции:
– Умножает каждый входящий сигнал (то есть числовое значение, поступившее от нейрона в предыдущем слое либо из массива входных данных) на вес соответствующей синаптической связи.
– Суммирует все входящие взвешенные сигналы.
– Если полученная сумма больше порога активации данного нейрона, нейрон возбуждается и посылает исходящий сигнал, равный единице, иначе исходящий сигнал равен нулю (см. раздел «Вариации» ниже).
Получение результата работы нейросети
Во всех слоях от входного до выходного каждый нейрон выполняет следующие действия:
– Вычисляет взвешенную сумму входящих сигналов (то есть исходящих сигналов нейронов предыдущего слоя либо чисел из массива входных данных).
– Если взвешенная сумма входящих сигналов больше порогового значения для нейрона, исходящий сигнал принимается равным единице, иначе нулю.
Процесс обучения нейронной сети
– Раз за разом проводится процесс распознавания на примерах из обучающей выборки.
– После каждого цикла работы нейросети веса синаптических связей между всеми нейронами корректируются так, чтобы улучшить точность ответов нейросети на данной выборке примеров (о том, как это происходит, рассказано далее).
– Обучение продолжается до тех пор, пока точность работы нейросети на обучающей выборке не перестанет расти (то есть не приблизится к предельным для данных условий значениям).
Ключевые аспекты проектирования
Приведенная выше простая схема требует от разработчика принятия нескольких решений в самом начале работы:
– Каким аспектам задачи будут соответствовать числа, подаваемые на вход нейронной сети.
– Каким будет количество слоев.
– Сколько нейронов будет в каждом слое (это число может быть различным для разных слоев).
– Сколько входящих соединений будет у нейронов в каждом слое. Это количество тоже может отличаться от слоя к слою и даже от нейрона к нейрону внутри одного слоя.
– Какой будет сама структура связей. Для каждого нейрона необходимо составить список нейронов, исходящие соединения которых будут являться входящими для данного. Это одна из самых важных задач при проектировании. Ее можно решить разными путями:
1. Назначить соединения случайным образом.
2. Использовать генетический алгоритм (см. ниже) для определения оптимальной схемы.
3. Задать топологию на усмотрение разработчика.
– Какими будут начальные значения весов всех синаптических связей. Они могут быть определены разными способами:
1. Установлены равными какому-то одному значению.
2. Определены случайным образом.
3. Найдены с помощью генетического алгоритма.
4. Установлены согласно представлениям разработчика.
– Каков будет порог активации для каждого нейрона.
– В какой форме нейросеть будет давать ответ. Результатом ее работы может быть:
1. Массив сигналов нейронов выходного слоя.
2. Исходящий сигнал единственного нейрона, на вход которому подаются сигналы последнего слоя нейронов.
3. Результат вычисления определенной функции от исходящих сигналов нейронов последнего слоя, например, их сумма.
4. Результат вычисления определенной функции от исходящих сигналов нейронов нескольких слоев.
– Каким методом будут корректироваться синаптические веса в ходе обучения нейросети. Это один из ключевых моментов, которому посвящены многочисленные исследования и дискуссии. Отметим ряд важных моментов:
1. После каждого цикла работы нейросети можно поочередно увеличивать или уменьшать вес каждого соединения на малую величину и проверять, какое из этих изменений увеличивает точность работы. Это требует больших временных затрат, поэтому были разработаны способы предсказать сторону, в которую следует изменить вес конкретной связи.
2. Существуют специальные статистические методы коррекции весов после каждого цикла работы сети, позволяющие добиться того, чтобы сеть давала более точный ответ для текущего примера.
3. Заметим, что нейросеть может успешно обучаться даже при наличии ошибок в обучающей выборке примеров. Это позволяет использовать данные, собранные в реальном мире, в которых неизбежно присутствует доля ошибочно размеченных. Для достижения хотя бы удовлетворительных результатов обучения нейросети распознаванию образов очень важным условием является наличие большого количества тренировочных данных. Как и в случае с человеком, время, затраченное на обучение, имеет большое значение для качества итогового результата.
Вариации
Существует множество вариаций приведенной выше схемы:
– Топологию сети можно выбрать случайным образом или найти оптимальную схему связей между нейронами, применив генетический алгоритм, в котором используется подобие мутации и естественного отбора применительно к структуре сети.
– Веса можно устанавливать в соответствии с различными соображениями.
– Нейрон может получать сигналы не только с предыдущего уровня, но и от нейронов, находящихся на других уровнях, как выше, так и ниже его.
– Выходной сигнал нейросети может быть определен по-разному.
– В приведенном выше описании нейросети использована нелинейная функция активации нейрона, работающая по принципу «все или ничего». Существуют и другие варианты нелинейных функций активации. Обычно используется функция, при которой выходной сигнал также лежит в диапазоне от нуля до единицы, но его значение меняется немного плавнее, и, кроме того, он может принимать значения, отличные от 0 и 1.
– Разные методы корректировки весов в процессе обучения существенно влияют на работу нейросети.
Приведенная нами схема описывает функционирование «синхронной» нейронной сети. Каждый цикл ее работы состоит в последовательном вычислении сигналов нейронов, начиная с входного слоя и заканчивая выходным. В по-настоящему параллельных системах, в которых нейроны работают независимо друг от друга, работа идет в «асинхронном» режиме. При этом каждый нейрон непрерывно обрабатывает поступающие на вход сигналы, и как только их взвешенная сумма превысит пороговое значение (или будет выполнено другое заданное условие), срабатывает функция активации.
После того как мы спроектировали нейронную сеть, нам необходимо найти обучающую выборку, работая с которой нейронная сеть поймет, как решать задачу. Как правило, начальные значения весов и карта связей между нейронами задаются случайным образом. Поэтому ответы, которые дает эта необученная нейросеть, полностью бессистемны. Основная задача нейронных сетей – учиться работать с поступающей информацией. В этом смысле они похожи (хотя бы в первом приближении) на мозг млекопитающих, по аналогии с которым и разрабатывались. Сначала нейросеть абсолютно некомпетентна, единственное, на что она запрограммирована – добиваться максимального значения «функции вознаграждения». Ей на вход подаются обучающие данные, например, заранее отсортированные человеком фотографии, на которых есть корги, и те, на которых нет. Когда нейросеть дает верный ответ на вопрос, есть ли на изображении корги, она получает положительную обратную связь в виде более высоких значений функции вознаграждения. Исходя из этого нейросеть модифицирует силу взаимодействия между различными парами нейронов. Связи, которые способствовали получению верного ответа, становятся сильнее, а те, которые приводили к ошибкам, ослабляются.
Со временем нейросеть самоорганизуется таким образом, чтобы показывать хороший результат в тех примерах, где ответ заранее не известен. Эксперименты подтвердили, что нейросети успешно обучаются и в том случае, когда учитель не вполне надежен. Даже если данные в обучающей выборке размечены корректно только в 60 % случаев, нейросеть в состоянии адаптироваться и давать верный ответ с 90 %-ной точностью. А иногда даже меньшее количество точно размеченных данных может помочь ей найти нужные закономерности26.
На первый взгляд кажется, что невозможно научить тому, чего сам не умеешь. Разве может обучение на ненадежной выборке дать выдающиеся результаты? Однако ошибки имеют свойство компенсировать друг друга. Например, вы обучаете нейросеть распознавать восьмерку среди цифр от 0 до 9, написанных от руки. Допустим при этом, что треть меток перепутаны случайным образом: восьмерки обозначены как четверки, пятерки как восьмерки и т. д. Если выборка достаточно большая, эти неточности не будут систематически искажать обучение в каком-то одном направлении. Поэтому большая часть важной информации о том, как выглядит цифра 8, будет в наборе данных сохранена, что и позволит нейросети качественно обучиться.
Несмотря на ряд сильных сторон, ранние нейросетевые системы сталкивались с принципиальными ограничениями. Однослойные нейронные сети в силу законов математики были не способны решать определенные виды задач27. Во время моего визита в Корнелл в 1964 году профессор Фрэнк Розенблатт показал мне код однослойной нейросети под названием «Перцептрон». Она умела распознавать печатные буквы. Я поработал с ней, пробуя немного видоизменять входной сигнал. Программа демонстрировала автоассоциативность, то есть могла узнать частично прикрытую букву, однако инвариантность к преобразованию достигнута не была: при изменении начертания или размера букв нейросеть переставала их узнавать.
В 1969 году Марвин Минский не разделял энтузиазма по поводу нейронных сетей, несмотря на рост интереса к этой области и то, что он сам был в числе первых исследователей этого феномена еще в 1953-м. Вместе с Сеймуром Пейпертом они основали Лабораторию искусственного интеллекта в МТИ. В своей книге «Перцептроны» они показали, почему сеть, подобная перцептрону, была принципиально неспособна определить, является ли представленный ей рисунок связным. На обложке книги были представлены два рисунка (они приведены ниже). На верхнем рисунке черные линии не образуют единую неразрывную фигуру, в отличие от нижнего. Человек способен различить их, если присмотрится, как и простая компьютерная программа. Перцептрон, такой как «Марк 1», построенный Розенблаттом, не может достоверно это определить, поскольку представляет собой нейронную сеть с прямой связью – это значит, что соединения между нейронами в ней не образуют циклов.

Проще говоря, перцептроны с прямой связью не справляются с этой задачей, потому что для ее решения необходимо применить вычислительную функцию XOR (так называемое «исключающее или»). Именно она помогает распознать случай, когда отрезок является частью одной непрерывной фигуры, но не принадлежит при этом к другой. Один слой нейронов без обратной связи не в состоянии реализовать функцию XOR, потому что вынужден классифицировать все элементы за один проход, пользуясь линейным законом (например, если оба нейрона сработали, то ответ положительный), а XOR непременно должна содержать возвратный шаг («если один из этих нейронов сработал, но не оба одновременно, тогда ответ положительный»).
После того как Минский и Пейперт опубликовали свои результаты, финансирование исследований нейросетей почти прекратилось на несколько десятилетий. При том, что как мне объяснил Розенблатт еще в 1964 году, проблемы перцептрона в части инвариантности по отношению к входным данным происходили просто от недостаточного количества слоев. По его словам, если взять результат работы перцептрона и подать на вход еще одной нейросети такой же структуры, ее выводы будут более обобщенными. Повторив этот шаг достаточное количество раз, можно добиться инвариантности. Стоит создать нейросеть с достаточным количеством слоев и обзавестись большой обучающей выборкой, и та сможет решать невероятно сложные задачи. Я поинтересовался у Розенблатта, пробовал ли он свой подход на практике, и он сказал, что пока нет, но это одна из его приоритетных задач. Задумка была превосходной, но, к сожалению, Розенблатт скончался всего семь лет спустя, в 1971 году, так и не успев воплотить свои идеи. Пройдет еще 10 лет, прежде чем многослойные нейросети начнут активно использоваться, и даже в то время они требовали настолько больших вычислительных мощностей и объемов данных для обучения, что были непригодны для практического применения. Впечатляющий прогресс ИИ в последние годы случился как раз благодаря многослойным нейросетям – через 50 лет после того, как Розенблатт выдвинул идею их использования.
Таким образом, коннекционистский подход к ИИ не получал должного внимания вплоть до середины 2010-х годов, когда современные технологии наконец-то позволили реализовать его потенциал благодаря доступности вычислительных мощностей и больших объемов данных. За время, прошедшее с момента публикации «Перцептронов» в 1969 году и до смерти Минского в 2016-м соотношение цена / производительность вычислительной техники (с учетом инфляции) улучшилось в 2,8 миллиарда раз28. Это коренным образом изменило представление о том, какие методы можно применять на практике в области искусственного интеллекта. В разговоре со мной незадолго до своей смерти Минский выразил сожаление, что «Перцептроны» оказали такое влияние на состояние дел в области ИИ, ведь с тех пор именно нейросетевой подход позволил нам достичь невероятных успехов.
Таким образом, коннекционизм можно сравнить с изобретениями наподобие летающей машины Леонардо да Винчи – прекрасная идея, воплотить которую было невозможно до создания новых легких и прочных материалов29. Как только электроника наверстала отставание от теории, стало возможным использование нейросетей глубиной в сотни слоев. В результате оказались решены многие задачи, к которым прежде было не подступиться. Именно эта парадигма лежит в основе многих впечатляющих достижений последних нескольких лет.
Мозжечок и его модульная структура
Чтобы разобраться в том, как связаны друг с другом компьютерные нейросети и интеллект человека, предлагаю сделать небольшое отступление и вернуться к моменту зарождения Вселенной. Поначалу процесс перехода материи к более организованным формам шел очень медленно, поскольку не было разума, который мог бы им управлять. (В разделе главы 3 под названием «Ваше существование – редчайшая удача» мы обсудим, насколько в принципе маловероятным было появление Вселенной, в которой может существовать информация.) На то, чтобы образовались новые структуры, ушли сотни миллионов, а то и миллиарды лет30.
По крайней мере, не меньше нескольких миллиардов лет понадобилось на то, чтобы появилась молекула, способная хранить закодированные инструкции по созданию живого организма. Есть некоторые разногласия относительно времени появления жизни на Земле, однако большинство ученых сходятся во мнении, что это произошло от 3,5 до 4 миллиардов лет назад31. Возраст Вселенной оценивается в 13,8 миллиарда лет (точнее сказать, столько времени прошло с момента Большого взрыва), а наша планета образовалась 4,5 миллиарда лет назад32. Таким образом, между формированием первых атомов и появлением (по крайней мере здесь, на Земле) первых молекул, способных самовоспроизводиться, прошло около 10 миллиардов лет. Такая задержка отчасти может объясняться случайностью этого процесса – мы не знаем, насколько маловероятным было столкновение нужных молекул в «первичном бульоне» на Земле. Возможно, жизнь могла зародиться немного раньше, а скорее всего, значительно позже, чем это произошло в действительности. В любом случае, прежде чем появилась такая возможность, многие звезды должны были завершить свой жизненный цикл, превратив водород в более тяжелые элементы, из которых и состоят живые организмы.
По оценкам ученых, с момента зарождения жизни на Земле до возникновения первых многоклеточных организмов прошло примерно 2,9 миллиарда лет33. Еще 500 миллионов лет понадобилось, чтобы животные вышли на сушу, а затем 200 миллионов – для появления первых млекопитающих34. Что касается эволюции мозга, промежуток времени от появления первых примитивных нервных путей до возникновения подобия централизованного трехчастного мозга составил около 100 миллионов лет35. Простые варианты новой коры стали формироваться спустя еще 350–400 миллионов лет, а результатом последующих 200 миллионов лет развития стало появление современного мозга человека36.
В процессе эволюции всякий раз более совершенный мозг давал своему обладателю решающее преимущество. В схватке за ресурсы побеждали самые сообразительные представители животного мира37. Развитие разума произошло гораздо быстрее, чем эволюция центральной нервной системы на предыдущих этапах – всего лишь за миллионы лет. Очевидно, прогресс ускорился. Со времен первых млекопитающих самым значительным изменениям подвергся мозжечок. У современного человека мозжечок содержит больше нейронов, чем новая кора, которая отвечает за высшую умственную деятельность38. Мозжечок хранит и задействует множество шаблонов движений, например, то, как ваша рука ставит автограф. В обиходе эти шаблоны иногда называют «мышечной памятью». Но это свойство именно мозжечка, а не мышц как таковых. По мере того как мы снова и снова повторяем какое-то действие, мозг адаптируется таким образом, чтобы оно требовало все меньших усилий и доходило до автоматизма – примерно так колеса раз за разом накатывают колею39.
Чтобы поймать брошенный мяч, можно решить систему дифференциальных уравнений, которые описывают траекторию его полета, а также движения вашей руки, и занять положение в пространстве, соответствующее полученным решениям. К сожалению, наш мозг не предназначен для решения задач по дифференциальному и интегральному исчислению, так что приходится выбирать способ попроще: надо сообразить, как наиболее оптимально расположить перчатку между своим телом и мячом. Мозжечок предполагает, что в каждом броске ваша рука и мяч должны занять примерно одно и то же положение относительно друг друга. Так что, если мяч летит чересчур быстро, а рука движется слишком медленно, мозжечок заставит вашу руку ускориться, чтобы она успела занять знакомое положение поблизости от мяча.
Мозжечок пользуется простым приемом отображения сенсорной информации на мускульные движения, что соответствует математическому принципу «базовых функций» и позволяет нам ловить мяч, не решая сложных уравнений40. С помощью этого отдела мозга мы также можем представить, какие последствия будут иметь наши действия, не совершая их в действительности. Например, мозжечок подскажет вам, что у вас есть шансы поймать мяч, но, скорее всего, вы столкнетесь с другим игроком, поэтому, возможно, пытаться не стоит. Все это происходит неосознанно.
Аналогичным образом во время танца мозжечок управляет вашими движениями, над которыми вы даже не задумываетесь. Если же из-за травмы или болезни мозжечок оказался поврежден, человек все еще может совершать целенаправленные действия с помощью неокортекса, но для этого ему нужно сосредоточиться. При этом у него может наблюдаться нарушение координации, которое называют атаксией41.
В освоении любого навыка ключевую роль играет регулярное повторение составляющих его действий. Если выполнять их достаточно часто, будет формироваться соответствующая «мышечная память». Движения, которые поначалу требуют сосредоточенности и внимания, со временем доводятся до автоматизма. Это явление объясняется передачей управления от моторной коры к мозжечку. Неважно, что вы делаете – бросаете мяч, собираете кубик Рубика, играете на пианино, – чем меньше вам нужно обдумывать свои действия, тем лучше вы их выполняете. Ваши движения станут быстрыми и плавными, а внимание будет направлено на другие факторы, которые способствуют успеху. Когда музыканты достигают такого уровня владея инструментом, они могут воспроизвести любую ноту с такой же легкостью и точностью, как люди, поющие «С днем рождения тебя». Если бы вас спросили, как вы настраиваете свои голосовые связки, чтобы получилась именно нужная нота, а не какая-либо другая, вряд ли вы смогли бы описать этот процесс словами. Психологи и тренеры называют этот феномен «бессознательной компетентностью». Это означает, что вы «овладели навыком на более глубоком уровне, чем тот, на котором работает сознание»42.
Такие возможности мозжечка обусловлены вовсе не сложностью его архитектуры. Хотя большая часть нейронов головного мозга взрослого человека, а также особей других видов, содержится именно в мозжечке, в геноме хранится не так уж много информации об устройстве этого отдела мозга – он состоит в основном из небольших простых модулей43. Хотя ученым еще предстоит раскрыть все секреты функционирования мозжечка, уже достоверно известно, что тысячи маленьких обрабатывающих модулей в нем собраны в однонаправленные структуры44. Это уже наводит на размышления о том, как должна быть организована нейронная сеть, выполняющая аналогичные функции. Будущие открытия наверняка подскажут разработчикам ИИ еще много полезного.
Большинство модулей в мозжечке имеют узкую специализацию. Те, что отвечают за движения одного из пальцев при игре на пианино, не участвуют в управлении ногами во время ходьбы. Хотя мозжечок оставался главным отделом мозга на протяжении сотен миллионов лет, современный человек полагается на него все меньше и меньше, поскольку более гибкая новая кора стала играть лидирующую роль для выживания в современном обществе45.
У животных, не относящихся к млекопитающим, отсутствует новая кора головного мозга, что лишает их ряда преимуществ. Однако в их мозжечке записаны точные шаблоны повадок, необходимых им для выживания. Эти управляемые мозжечком действия называются фиксированными моделями поведения. Они записаны в мозгу каждого представителя вида, в отличие от выученных вариантов действий, основанных на наблюдении и повторении. Даже у млекопитающих встречается довольно сложное рефлексоподобное поведение. Например, белоногие хомячки роют неглубокие норы, а береговые хомячки – длинные норы с выходным тоннелем46. Когда грызуны, выросшие в лабораторных условиях, оказались на природе, каждый из них вырыл нору, соответствовавшую его виду, хотя до этого не видел ни одной.
В основном рефлексы, хранящиеся в мозжечке, такие как способность лягушки поймать летящую муху языком, остаются у вида до тех пор, пока часть популяции с улучшенной версией не вытеснит всех остальных путем естественного отбора. Когда поведение определяется генетикой, а не обучением, адаптация к новым условиям происходит на несколько порядков медленнее. Способность к обучению позволяет живым существам целенаправленно менять свой образ действий в течение жизни одного поколения, в то время как врожденные рефлексы претерпевают постепенную модификацию в процессе смены многих поколений. В этой связи интересно, что разработчики компьютерных программ иногда используют имитацию эволюционного подхода – так называемые генетические алгоритмы 47. При этом они создают ряд версий программы со случайными значениями параметров, а затем оценивают, насколько хорошо каждая из них справляется с поставленной задачей. У тех, которые показали наилучшие результаты, берут некоторые значения параметров и комбинируют с другими, в точности как при половом размножении. Также можно вносить случайные «мутации», чтобы проверить, не приведут ли они к улучшению производительности. За много поколений таким образом можно найти оптимальный набор значений параметров, до которого программисты сами никогда бы не додумались.
В реальном мире этот процесс длится миллионы лет. Может показаться, что это слишком медленно, но стоит вспомнить о том, что до возникновения жизни эволюция в некотором виде шла сотни миллионов лет – столько, например, могло уйти на формирование химических элементов, необходимых для зарождения жизни, – и мозжечок в сравнении с этим покажется довольно гибкой структурой.
Неокортекс: пластичная иерархическая структура
Чтобы ускорить прогресс, мозгу в ходе эволюции пришлось найти способ создавать новые модели поведения, не дожидаясь, пока генетика модифицирует мозжечок. Этим способом стала новая кора. Она появилась 200 миллионов лет назад у нового класса животных – млекопитающих, и представляет собой буквально «внешнюю кожуру» мозга48. Первые млекопитающие, которые были похожи на грызунов, обладали новой корой размером с почтовую марку и такой же тонкой; она была обернута вокруг их мозга размером с лесной орех49. Внутренняя организация новой коры существенно отличалась от устройства мозжечка. Вместо набора разрозненных модулей, управлявших различными движениями, неокортекс работал как единая скоординированная система и мог поддерживать новый тип мышления, благодаря которому новые модели поведения появлялись в течение нескольких дней или даже часов. Мозгу стал доступен мощный инструмент – обучение.
Более 200 миллионов лет назад низкая скорость адаптации животных, не являвшихся млекопитающими, не составляла большой проблемы, поскольку окружающая среда менялась крайне медленно. Изменения в условиях жизни, требующие соответствующих модификаций в мозжечке, происходили в течение тысяч лет.
Для того чтобы неокортекс вышел на передний план в живом мире, требовалось потрясение. Катастрофа, которую мы сейчас называем мел-палеогеновым вымиранием, произошла 65 миллионов лет назад, через 135 миллионов лет после появления новой коры. Причиной послужило столкновение с астероидом и, вероятно, вулканическая активность. В результате условия обитания на всей планете изменились настолько резко, что 75 % видов растений и животных, в том числе динозавры, вымерли. (Хотя животные, которых мы называем динозаврами, исчезли в результате событий того времени, некоторые ученые считают птиц потомками одной из ветвей динозавров50.)
Именно тогда важнейшую роль стала играть новая кора, способная быстро находить новые решения. Млекопитающие увеличились в размерах, а их мозг рос опережающими темпами. Новая кора стремительно развивалась, в ней появились складки, позволившие увеличить площадь поверхности.
Если развернуть новую кору мозга человека, она будет иметь размеры и толщину, как большая столовая салфетка51. Благодаря ее невероятно сложной структуре в ней заключено 80 % массы всего человеческого мозга52.
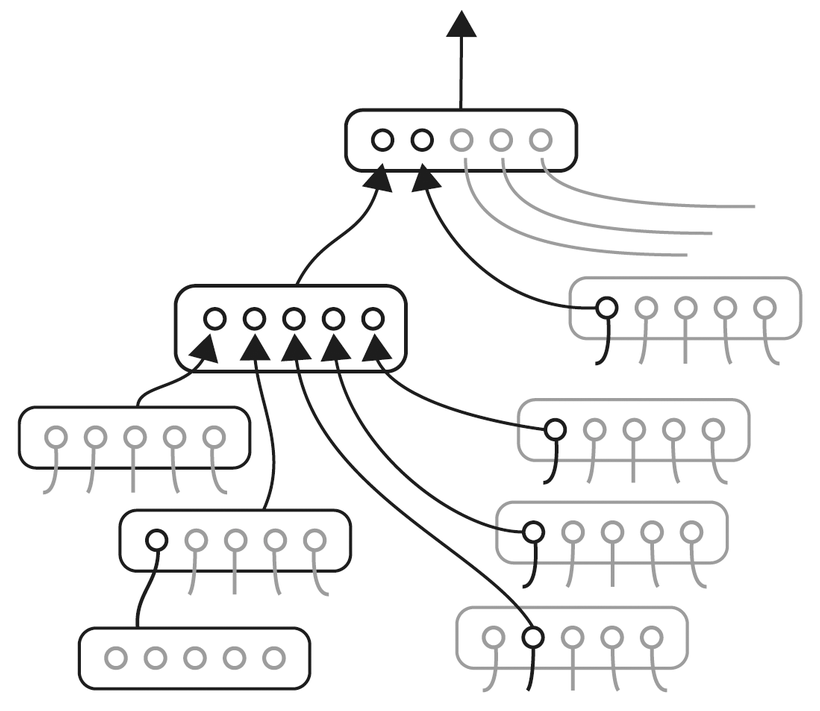
В своей книге «Эволюция разума», вышедшей в 2012 году (на русском языке вышла в 2018-м), я подробно описал работу новой коры головного мозга. Здесь же мы вкратце остановимся на основных моментах. Неокортекс представляет собой систему, состоящую из простых повторяющихся модулей, каждый из которых включает около ста нейронов. Эти модули способны запоминать, распознавать и воспроизводить образы. В процессе обучения они организуются в иерархическую структуру, при этом модули на более высоких уровнях отвечают за более сложные концепции. Подобные повторяющиеся отделы получили название «миниколонок кортекса»53.
По современным оценкам в коре головного мозга содержатся от 21 до 26 миллиардов нейронов, и 90 % из них – в среднем 21 миллиард – в новой коре54. Это значит, что мы располагаем примерно 200 миллионами миниколонок по 100 нейронов каждая55. Исследования показывают, что, в отличие от компьютеров, которые обрабатывают данные в основном последовательно, распознающие модули неокортекса по максимуму используют параллелизм 56. Огромное количество операций происходит одновременно. Это делает мозг очень динамичной системой, которую сложно моделировать на компьютере.
Ученым еще предстоит выяснить множество деталей, но известные нам принципы организации и взаимодействия миниколонок уже помогают понять, как они работают. Подобно искусственным нейронным сетям, работающим на кремниевых процессорах, сети нейронов в мозге имеют иерархическую структуру, в которой одни слои принимают входные данные (например, сигналы от наших органов чувств), а другие отвечают за выдачу результатов (например, демонстрируемое человеком поведение). Промежуточные слои обрабатывают данные на различных уровнях абстракции, обеспечивая своим функционированием те тонкие формы мышления, которые мы воспринимаем как свойственные именно человеку.
Модуль самого нижнего уровня, который получает сигналы непосредственно от органов чувств, может быть обучен распознавать определенную форму линии. Более высокие уровни обрабатывают информацию, поступающую от низших, учитывая контекст и повышая уровень абстрагирования. Таким образом, модули, расположенные все дальше от органов чувств, узнают в изогнутой линии часть буквы, воспринимают ее как часть слова и связывают это слово с определенным понятием. На самом высоком уровне обрабатываются максимально абстрактные концепции, например, было ли высказывание забавной шуткой или же в нем содержался сарказм.
Хотя «этаж», на котором находится модуль, определяет его степень абстрагирования относительно сигналов, поступающих от органов чувств, процесс их обработки не является однонаправленным. Шесть основных уровней неокортекса постоянно общаются друг с другом в обоих направлениях, поэтому нельзя утверждать, что абстрактное мышление происходит исключительно на высших уровнях57. Скорее многоуровневая структура коры в целом дает нам как биологическому виду больше способностей к абстрактному мышлению, чем позволяет иметь другим животным их более простая кора. Следовательно, когда мы подключим наш неокортекс напрямую к облачным вычислительным ресурсам, это откроет нам возможность мыслить на более высоких уровнях абстракции, чем может обеспечить биологический мозг сам по себе.
Неврологические основы абстрактного мышления были открыты совсем недавно. В конце 1990-х годов нейрохирург Ицхак Фрид проводил операцию на мозге шестнадцатилетней пациентки, страдавшей эпилепсией. Девушка оставалась в сознании, так как врачам было важно отслеживать ее реакции на их действия58. Такие операции возможны благодаря отсутствию болевых рецепторов в мозге59. Каждый раз, когда хирург затрагивал определенную область коры ее мозга, девушка начинала смеяться. Фрид и его команда быстро разобрались, что такое вмешательство вызывало в ней ощущение комичности ситуации. Она не просто рефлекторно смеялась – происходящее на самом деле казалось ей смешным, хотя ничего забавного в операционной не происходило. Когда доктора спрашивали ее, почему она смеется, то не получали ответа в духе «просто так» или «потому что вы тыкаете мне в мозг». Вместо этого она мгновенно находила объяснение, например, такое: «Вы, ребята, очень смешно стоите вокруг»60.
Возможность найти и простимулировать область новой коры, которая вызывает чувство, что обнаружено нечто забавное, позволяет сделать вывод, что эта зона отвечает за восприятие концепций юмора или иронии. Это открытие подтверждено и неинвазивными методами. Например, при чтении ироничных сообщений увеличивается активность в области мозга, ответственной за так называемую «модель психического состояния»61. Именно способность новой коры оперировать абстрактными понятиями стоит за изобретением языка, музыки, юмора, науки, искусства и инженерии62.
Ни один другой вид живых существ не создал ничего подобного, вопреки множеству публикаций в желтой прессе. Ни одно животное не способно отбивать заданный ритм, шутить, произносить речи, написать (или хотя бы прочитать) книгу, подобную этой. Хотя шимпанзе, например, могут использовать примитивные орудия труда, их инструменты недостаточно сложны, чтобы заставить их пользователей развиваться63. Некоторые виды животных имеют возможность общаться, но не в состоянии передавать друг другу абстрактную информацию, которую можно выразить на нашем языке64. Мы неплохо справлялись в животном мире и без фронтальной коры, но, получив новые модули и вместе с ними способность мыслить сложными категориями о мире и своем существовании, мы превратились из просто продвинутых животных в философствующих существ.
При этом нужно помнить, что развитый мозг стал лишь одним из двух факторов, определивших наш триумф как биологического вида. При всей мощи новой коры наука и искусство были бы невозможны без еще одного чрезвычайно важного новшества: наших больших пальцев 65. Животные с такой же или большей по размеру (в абсолютных величинах) новой корой, в частности киты, дельфины и слоны, не имеют ничего похожего на противостоящий палец, который позволил бы им хватать предметы и превращать их в орудия труда. Поэтому мы можем считать, что выиграли в эволюционной лотерее.
Нам также на руку, что неокортекс не просто состоит из слоев, но что эти слои соединены друг с другом необычным и очень продуктивным способом. Иерархическая организация модулей встречается не только в неокортексе, мозжечок тоже имеет похожую структуру66. Однако новая кора отличается тремя особенностями, которым млекопитающие, в особенности люди, обязаны своей креативностью: (1) распознанные образы могут распространятся по всей структуре коры, а не только в пределах участка, в котором возникли; (2) конкретный образ может быть связан с похожими явлениями в других понятийных областях, а связанные друг с другом концепции представлены схожими образами; (3) одновременно в коре могут возникать миллионы образов67, и их взаимодействие друг с другом может быть весьма нетривиальным68.
В частности, сеть сложных связей внутри новой коры способствует богатой ассоциативной памяти 69. Каждое воспоминание в мозгу сродни странице «Википедии» – к нему ведут ссылки из самых разных мест, а само оно подвержено изменениям. Как и статья в «Википедии», воспоминание может содержать мультимедийную информацию и, с другой стороны, само может быть вызвано любым ощущением – запахом, вкусом, услышанным звуком или другим сигналом от органов чувств.
Схожесть представления образов в коре позволяет нам проводить аналогии. Активность нейронов, соответствующая опусканию руки, будет напоминать процессы, протекающие в коре при понижении тона голоса, а также будет похожа на образы, связанные с метафорами: падение температуры, приход империи в упадок. Таким образом, мы можем сформировать образ, изучая явление в одной области, и перенести его в совершенно другой контекст.
Способность новой коры проводить аналогии между несвязанными явлениями помогла свершиться многим научным открытиям в нашей истории. Например, Чарлза Дарвина (1809–1882) на теорию эволюции натолкнули исследования геологических процессов. Прежде естествоиспытатели в основном были убеждены, что Бог создал каждый вид живых существ независимо друг от друга. Существовало несколько квазиэволюционных гипотез, самой известной из которых была теория Жана-Баптиста Ламарка (1744–1829), который считал, что животные постепенно развиваются и превращаются в более сложные организмы, а потомство может унаследовать черты родителей, приобретенные ими в процессе жизнедеятельности70. Но ни одна из подобных теорий не содержала подробного и достоверного описания механизма работы эволюции.
Однако Дарвину в работах Чарлза Лайеля (1797–1875) попалась на глаза идея, которая на первый взгляд не имела отношения к эволюции. Шотландский геолог высказал смелую догадку о происхождении глубоких каньонов на земной поверхности71. Большинство натуралистов в те времена сходились во мнении, что каньоны были созданы Богом, а реки под действием гравитации устремлялись к их дну и там спокойно текли. Лайелю пришла в голову мысль, что сначала возникли реки, и только спустя время – каньоны. Эта теория встретила большое сопротивление и не сразу стала общепринятой, но ученые достаточно быстро разобрались, что даже небольшой ручеек, промывая себе путь в течение миллионов лет, и в самом деле может сформировать Большой каньон. Теория Лайеля оказала большое влияние на работу его соотечественника, шотландского геолога Джеймса Хаттона (1726–1797), который впервые изложил принципы униформизма в геологии72. Суть их идеи состоит в том, что облик земной поверхности сформировался не в результате библейского катаклизма, а постепенно под воздействием обычных природных сил, действовавших на протяжении долгого времени.
В мире естествознания предположение Дарвина прозвучало гораздо более дерзко. Биология невероятно сложна, но Дарвину удалось заметить связь между исследованиями Лайеля и своими собственными изысканиями, о чем он написал в предисловии к своей книге «Происхождение видов», вышедшей в 1859 году. Дарвин провел аналогию между идеей Лайеля о том, как река постепенно разрушает горную породу, и небольшими генетическими изменениями, происходящими из поколения в поколение. Отстаивая свою теорию, он ссылается на диспут в смежной области науки: «Современная геология почти полностью отвергла возможность прорытия глубокой долины одной делювиальной волной; точно так же, если теория естественного отбора получит подтверждение, она развеет веру в постоянное творение новых органических существ или в реальность какой-либо большой и внезапной перемены в их строении»73. Этим трудом он вошел в историю как автор, возможно, главного революционного открытия в нашей науке. Кстати, идеи других претендентов на этот титул, Ньютона, который открыл закон всемирного тяготения, и Эйнштейна, выдвинувшего теорию относительности, также были основаны на соображениях аналогии.
Глубокое обучение: попытка воссоздать силу неокортекса
Итак, нам нужно добиться от электронного мозга такой же гибкости и умения мыслить абстрактными категориями. Но каким образом? Мы уже обсудили, что системы, основанные на списках правил, слишком жестко запрограммированы и не могут имитировать мышление человека. Коннекционизм долгое время оставался непрактичным подходом, поскольку решения на его основе требовали огромных компьютерных мощностей. Однако стоимость вычислительных ресурсов радикально снизилась. Почему же это произошло?
В 1965 году Гордон Мур (1929–2023), сооснователь компании Intel, сформулировал знаменитый закон, названный его именем. Этот закон выразил важнейшую тенденцию в развитии информационных технологий74. В наиболее известной формулировке он гласит, что количество транзисторов, которые можно разместить на кристалле интегральной схемы, удваивается каждые 24 месяца благодаря миниатюризации электронных компонентов. Скептики неоднократно отмечали, что период экспоненциального роста числа транзисторов неизбежно закончится, как только будет достигнут физический предел плотности размещения электронных компонентов. Однако они упускают из виду важное обстоятельство. Закон Мура – это лишь одно из проявлений более глубокого явления, которое я называю законом ускорения отдачи. Его суть заключается в том, что прогресс в информационных технологиях способствует более быстрому появлению инноваций. К моменту, когда Мур обнародовал свои наблюдения, экспоненциальный рост вычислительной мощности уже прошел через четыре технические парадигмы: электромеханическую, релейную, ламповую и транзисторную. Когда интегральные схемы исчерпают свой потенциал, им на смену придут наноматериалы или трехмерная архитектура процессора75.
Описанная тенденция понемногу толкала прогресс вперед примерно с 1888 года (задолго до рождения Мура)76. К 2010-му технологии наконец-то достигли уровня, который позволил раскрыть потенциал нейросетевого подхода к моделированию многоуровневых процессов, происходящих в новой коре. Разработчики начали активно применять методику, известную как глубокое обучение. Именно этот подход обеспечил внезапный прорыв в сфере ИИ, который произошел со времени публикации книги «Сингулярность уже близка».
Наглядным примером того, на что способна технология глубокого обучения, стало успешное освоение искусственным интеллектом настольной игры го. В этой игре намного больше возможных вариантов хода, чем в шахматах, к тому же гораздо сложнее определить, будет ли конкретный выбор удачным. Так что подход, который помог машине победить шахматных гроссмейстеров, оказался неэффективным в случае с го. По самым оптимистичным прогнозам, эта проблема должна была оставаться нерешенной по крайней мере до 2020-х годов. Например, в 2012 году Ник Бостром, один из ведущих футурологов и визионеров в области ИИ, высказал мнение, что компьютер сможет уверенно играть в го не раньше 2022-го77. Однако в 2015–2016 годах дочерняя компания DeepMind холдинга Alphabet представила проект AlphaGo, созданный с использованием метода глубокого обучения с подкреплением. Эта система представляла собой большую нейросеть, способную анализировать сыгранные ей самой партии и учиться на своих успехах и ошибках78. Вначале ее обучили на обширной базе игровых ходов, совершенных людьми, затем она провела множество матчей сама с собой. В результате версия AlphaGo Master достигла такого уровня, что смогла победить Кэ Цзе – чемпиона мира по игре в го79.
Несколько месяцев спустя появилась существенно более продвинутая система под названием AlphaGo Zero. Когда в 1997 году компания IBM со своим суперкомьютером Deep Blue победила чемпиона мира по шахматам Гарри Каспарова, им пришлось снабдить программу всеми доступными знаниями о шахматах, которые программисты смогли почерпнуть у шахматных экспертов80. Суперкомпьютер стал шахматистом, никаких других функций у него не было. В AlphaGo Zero не загружали вручную никакой информации о игре го, кроме правил самой игры, тем не менее за три дня игры с самой собой она прошла путь от выполнения случайных ходов к уровню мастерства, который обеспечил ей легкую победу над прошлой версией AlphaGo, которую тренировали люди, со счетом 100:081. (В 2016-м AlphaGo в четырех играх из пяти обыграла Ли Седоля, который на тот момент занимал вторую строчку в неофициальном рейтинге игроков в го по количеству титулов.) Нейросеть AlphaGo Zero использовала новый формат обучения с подкреплением, став своим собственным тренером. Через 21 день AlphaGo Zero достигла уровня AlphaGo Master – нейросети, которая в 2017-м нанесла поражение 60 лучшим мастерам при игре онлайн, в том числе чемпиону мира Кэ Цзе, выиграв у того три партии из трех82. Через 40 дней обучения AlphaGo Zero превзошла в мастерстве все предыдущие версии AlphaGo и стала лучшим игроком в го среди людей и компьютеров83. Этого результата удалось добиться без предоставления ей записей игр людей и еще какого-либо вмешательства со стороны операторов.
Но главное достижение команды DeepMind было еще впереди. Нейросеть следующего поколения, получившая название AlphaZero, продемонстрировала способность переносить навыки, полученные при игре в го, на другие игры, в частности шахматы84. Эта программа сумела одолеть не только всех игроков из числа людей, но и все другие шахматные программы, проведя всего лишь четыре часа тренировок и не имея никакой специфической информации, кроме правил игры. Такого же успеха она добилась и в игре сёги. Последняя версия нейросети на момент написания книги называлась MuZero. Она повторила все достижения своей предшественницы, не зная заранее даже правил игры85! Обладая способностью к «переносу навыков», MuZero может освоить любую настольную игру, в которой не фигурирует случайность, многозначность или скрытая информация, а также любую детерминированную видеоигру, например, «Понг» от компании Atari. Умение применять знания и опыт, полученные в одной области, для решения задач в другой – это ключевая особенность человеческого разума.
Однако область применения нейросетей глубокого обучения не ограничивается подобными играми. Системы искусственного интеллекта, специализирующиеся на играх StarCraft II и покер, в которых много неопределенности и требуется понимание стратегии соперников, недавно тоже превзошли живых игроков86. Единственным исключением (пока что) остаются игры, требующие совершенного владения речью. Хорошим примером может служить «Дипломатия». Цель игрока в ней – захватить мир, причем это невозможно сделать, полагаясь только на удачу или навыки, приходится договариваться с соперниками87. Чтобы выиграть, вам нужно заставить других игроков сделать выгодные вам ходы, убедив их, что им эти действия также на руку. Так что ИИ, способный выиграть в эту игру, скорее всего, будет искусным обманщиком и отличным переговорщиком. Но даже в «Дипломатии» нейросетям удалось в 2022-м добиться впечатляющих результатов, особенно программе под названием CICERO, которая смогла одолеть многих игроков-людей88. Подобные успехи теперь случаются чуть ли не каждую неделю.
С помощью глубокого обучения можно научить ИИ не только мастерски играть в игры, но и действовать в сложных жизненных ситуациях. Для этого, по сути, требуется только симулятор, способный воссоздать обстановку, в которой ИИ должен научиться ориентироваться. Примером может служить вождение автомобиля. За рулем вы можете столкнуться с рядом опасных ситуаций, таких как неожиданная остановка другой машины, ребенок, выбежавший за мячом на дорогу, и так далее; в каждом из этих случаев у водителя есть несколько вариантов действий. Waymo, дочерняя компания Alphabet, разработала систему автономного вождения. Первые поездки автопилота проходили в сопровождении оператора89. Каждая деталь маршрута была тщательно задокументирована, а затем на основе этих записей был создан полноценный симулятор. К настоящему времени автономные автомобили Waymo проехали более 20 миллионов километров90, к тому же автопилот набирался опыта на миллиардах километров реалистичных виртуальных дорог91. С таким пробегом за плечами беспилотный автомобиль рано или поздно начнет передвигаться намного эффективнее управляемого живым водителем. Еще одним примером использования современных методов моделирования является задача определения трехмерной структуры белка, о которой мы подробно поговорим в главе 6. Это одна из самых сложных задач в биологии, и ее решение позволит создать беспрецедентно эффективные лекарства.
Притом что система MuZero великолепно играет во множество игр, ее успехи в целом пока скромнее, чем может показаться: ей не под силу написать сонет или найти слова, чтобы утешить больного. Чтобы в полной мере воспроизвести невероятные возможности неокортекса человеческого мозга, ИИ необходимо в совершенстве овладеть языком. Именно развитая речь позволяет нам проводить аналогии между абсолютно разными областями знаний и помогает эффективно передавать друг другу единицы смысла. Благодаря способности говорить и воспринимать речь мы не связаны необходимостью учиться на миллионах примеров. Иногда нам достаточно прочесть всего одно предложение, чтобы получить нужные сведения.
Наибольшего прогресса в работе с естественными языками пока удалось добиться с помощью глубоких нейронных сетей, которые строят карту значений слов в пространстве с очень большим числом измерений. Для этого существует несколько математических методов, которые позволяют ИИ определить смысл выражения, не обращаясь к заранее заготовленному набору языковых правил, как требовал бы символьный подход. Например, мы можем построить многослойную нейронную сеть прямого распространения и обучить ее на выборке из миллиардов (или даже триллионов) предложений. Такой объем данных можно собрать из открытых источников во Всемирной сети. Нейросеть свяжет каждое предложение с точкой в 500-мерном пространстве, иначе говоря, со списком из 500 чисел (число 500 выбрано мной произвольно, размерность может быть другой, но достаточно большой). Сначала все эти числа для каждого предложения задаются случайным образом. В ходе обучения нейросеть корректирует положение, занимаемое каждым предложением в 500-мерном пространстве, таким образом, чтобы близкие по значению фразы оказались рядом друг с другом, а непохожие, наоборот, на удалении. Если провести обучение на огромном количестве текстов, то соответствующая каждому предложению точка в 500-мерном пространстве позволит по соседним высказываниям определить, о чем в нем говорится.
Работая в таком ключе, ИИ изучает смысл слов не по словарям и грамматическим справочникам, а из контекста, в котором эти слова употребляются. Например, он сообразит, что у слова «джем» есть омонимы, потому что иногда люди его едят, а в других случаях берут электрогитары и устраивают «джем», хотя никто не говорит, что гитары съедобны. Мы сами пополняем свой словарный запас таким же образом, за исключением небольшого количества слов, которые проходим в школе или специально ищем в словаре. Между тем нейросети уже распространили свое ассоциативное мышление на другие виды информации, помимо текста. В 2012 году компания OpenAI представила проект CLIP. Эту нейросеть обучили устанавливать связи между картинкой и ее описанием. В результате узлы этой нейросети «реагируют на одну и ту же идею, фигурирует ли она во входящем потоке информации в виде текста, изображения или ассоциации»92. Например, один и тот же нейрон может сработать при виде фотографии паука, рисунка Спайдермена или слова «паук». Именно так мозг человека воспринимает концепции, абстрагируясь от деталей. Для ИИ это огромный рывок вперед.
В качестве развития этого метода можно построить 500-мерное пространство, в котором содержатся предложения на всех языках. В таком случае, если требуется перевести фразу с одного языка на другой, остается просто найти предложение на нужном языке, которое в этом многомерном пространстве расположено ближе всего к исходному. Можно заодно отыскать другие близкие по значению высказывания, рассмотрев соседние точки. Еще один вариант: построить пару 500-мерных пространств, одно из которых будет содержать вопросы, а второе – ответы на них. Для этого потребуется собрать миллиарды пар предложений, сгруппированных по принципу вопрос-ответ. Развивая этот подход, моя команда в Google разработала «Универсальный кодировщик предложений»93, создав базу данных, в которой каждому предложению соответствуют его характеристики, например, «ироничное», «забавное» или «позитивное». Нейросеть, обученная на таком расширенном наборе данных, способна не только подражать тому, как люди используют язык, но также улавливать более тонкие семантические особенности, которые могут быть неочевидны за буквальным значением слов. Такое метазнание способствует более полному пониманию текста.
Используя эти принципы, мы в компании Google создали ряд приложений, работающих с языком повседневного общения. Особый интерес из них представляет функция почтового сервиса Gmail под названием Smart Reply94. Если вы пользуетесь Gmail, то могли заметить, что сервис предлагает вам три варианта ответа на каждое письмо. Эти подсказки формируются с учетом не только последнего письма, но и всех предыдущих писем в цепочке, а также темы переписки и других данных, указывающих на то, с кем вы общаетесь. Чтобы проанализировать все эти элементы, мы используем многомерное представление, описанное выше. В работе сервиса задействована многослойная нейросеть прямого распределения вместе с иерархическим представлением текстового содержимого переписки. Поначалу многим пользователям эта функция показалась непривычной, но они достаточно быстро к ней адаптировались. Теперь Gmail Smart Reply генерирует небольшую, но все-таки заметную долю почтового трафика.
Еще одним проектом Google, основанным на описанном выше подходе, стал экспериментальный сервис «Поговори с книгой». (Он был доступен с 2018 по 2023 год.) Когда вы задавали вопрос, программа в течение полусекунды сканировала каждое из 500 миллионов предложений в библиотеке из более чем 100 000 книг и находила наиболее подходящий ответ. Этот процесс отличался от обычного поиска Google, который предлагает вам ссылки на основе комбинации параметров, таких как ключевые слова в запросе, частота обращений пользователей к странице и так далее. Вместо этого система «Поговори с книгой» сопоставляла смысл вашего вопроса со значением каждого предложения из своей базы данных.
Одним из самых многообещающих приложений многомерного подхода к обработке языка являются так называемые трансформеры – класс систем искусственного интеллекта. В этих моделях глубокого обучения применяется механизм внимания, который позволяет перераспределять вычислительные ресурсы, направляя их на наиболее значимые части входных данных. Этот механизм напоминает работу новой коры головного мозга человека, которая позволяет нам сосредоточиться на той части информации, которая имеет наибольшее значение для формирования суждения. Трансформеры обучаются на огромных объемах текста, разбивая его на токены: слова, сочетания частей слов и целые строки. Затем каждый из этих токенов оценивается по огромному числу параметров (в настоящее время используются миллиарды или триллионы таких параметров). Эти параметры можно рассматривать как факторы, на основе которых строятся прогнозы.
Рассмотрим простой пример. Если бы мне нужно было определить, является ли животное слоном, используя только один параметр, я бы выбрал признак «хобот». В таких условиях, если узел нейросети, выявляющий наличие хобота, посылает сигнал, трансформер отнесет животное к слонам. Но даже если узел, отвечающий за определение хобота, никогда не ошибается, однопараметрическая модель все равно может неверно классифицировать животное, потому что хобот есть не только у слонов. Чтобы повысить точность, можно добавить другие параметры, например «шерсть». Теперь, если оба узла сработают (будут замечены шерсть и хобот), я могу догадаться, что передо мной, вероятно, не слон, а шерстистый мамонт. Чем больше параметров я использую, тем больше мелких деталей смогу зафиксировать и тем точнее будут мои прогнозы.
В трансформерах такие параметры хранятся в виде весов синаптических связей между узлами. Хотя иногда их и можно связать с концепциями, понятными людям, такими как «наличие шерсти» или «хобот», на практике они чаще всего отражают более абстрактные статистические закономерности, обнаруженные нейросетью в обучающих данных. Используя эти закономерности, большие языковые модели (LLM) на основе трансформеров могут предсказывать, какие токены должны с большой вероятностью следовать за словами из запроса, отправленного пользователем. Затем эти токены преобразуются обратно в текст, изображение, звук или видео, доступные для восприятия человеком. Этот механизм был разработан специалистами Google в 2017 году, и именно ему мы обязаны многими впечатляющими достижениями искусственного интеллекта в последние годы95.
Важно понимать, что для достижения высокой точности решений трансформеры нуждаются в огромном количестве параметров. Как следствие, они требуют значительных вычислительных ресурсов как на стадии обучения, так и в процессе использования. Модель GPT-2, разработанная компанией OpenAI в 2019 году, содержала 1,5 миллиарда параметров96. Несмотря на отдельные успехи, она не показала блестящих результатов. Но как только количество параметров достигло 100 миллиардов, трансформеры сделали резкий рывок вперед. Они стали «понимать» естественные языки и давать осмысленные и подробные ответы на вопросы. Созданная в 2020 году GPT-3 использовала 175 миллиардов параметров97, а годом спустя компания DeepMind представила еще более эффективную нейросеть Gopher, содержавшую 280 миллиардов коэффициентов98. Также в 2021-м компания Google выпустила трансформер под названием Switch, который содержал 1,6 триллиона параметров. Его исходный код был открыт, чтобы другие команды могли свободно его применять и модифицировать99. У всех на слуху было рекордное количество параметров в Switch, но самым инновационным в этом проекте было решение встроить в программу своего рода «коллегию экспертов». Такой подход позволил трансформеру каждый раз использовать наиболее подходящую для решения конкретной задачи часть нейросети. Это важный шаг, который позволяет удержать под контролем вычислительную сложность моделей по мере того, как они становятся все более обширными.
Почему размер нейросети так важен? Проще говоря, чем больше модель, тем больше мелких деталей в обучающей выборке она может проанализировать. Нейросети с малым числом параметров сравнительно хорошо справляются с узкими задачами, такими как прогнозирование температуры по историческим данным. Однако научиться понимать язык гораздо сложнее. Существует практически бесконечное количество способов начать предложение, поэтому, даже если трансформер обучен на сотнях миллиардов текстовых токенов, он просто не в состоянии запомнить точные цитаты, чтобы затем их воспроизвести. Вместо этого, опираясь на миллиарды параметров, он может обработать слова из входящего запроса на уровне ассоциаций и затем с учетом контекста составить продолжение, которое никто никогда раньше не видел. Поскольку обучающие тексты принадлежат к разным жанрам, таким как интервью, обзорная статья или театральная пьеса, трансформер в состоянии оценить язык запроса и подготовить ответ в подходящем стиле. Скептики списывают эти умения на хитроумные статистические трюки, но, учитывая, что статистика формируется на основе оригинальных текстов миллионов людей, нельзя отказать ИИ в проявлении своего рода собственной креативности.
Первым коммерчески доступным ИИ, который поразил пользователей своим уровнем креативности, стал GPT-3 100. Исследователь Аманда Аскелл задала ему вопрос о знаменитом мысленном эксперименте философа Джона Сёрла, известном как «китайская комната»101. Речь идет о том, что если не знающий китайского языка человек станет вручную переводить текст, следуя компьютерному алгоритму, то не поймет, о чем в нем говорится. Возникает вопрос: как тогда можно утверждать, что ИИ, действуя по тому же алгоритму, осознает, что пишет? GPT-3 ответил: «Очевидно, что я не понимаю ни слова из рассказов» – и пояснил, что система машинного перевода – это формальная инструкция, которая «имеет не больше отношения к пониманию, чем кулинарная книга к готовому блюду». Эта метафора ранее нигде не встречалась и, по-видимому, является новым вариантом высказывания философа Дэвида Чалмерса о том, что рецепт не объясняет всех свойств пирога. Именно такая способность проводить аналогии помогла Дарвину открыть происхождение видов.
Еще одним замечательным свойством GPT-3 является способность подражать различным стилям письма. Модель обладала внушительным набором параметров, которые позволили ей глубоко изучить огромный массив данных, поэтому можно с уверенностью сказать, что она знакома с литературными произведениями всех жанров. Пользователи могли попросить ее высказаться на любую тему в любой манере: языком научной статьи или детских книжек, в стихах или в виде сценария комедийного сериала. ИИ даже мог притвориться конкретным писателем, от классиков до современных авторов. Когда программист Маккей Ригли задал GPT-3 вопрос: «Как стать более креативным?» – и попросил ответить от имени известного психолога Скотта Барри Кауфмана, нейросеть привела оригинальное высказывание, о котором сам Кауфман отозвался как об «очень похожем на то, что говорю я»102.
В 2021 году компания Google представила нейросеть LaMDA, созданную для ведения живых и непрерывных разговоров103. Если бы LaMDA попросили вести беседу от лица, к примеру, тюленя Уэдделла, она бы выдавала связные остроумные реплики, обращенные к охотнику, например: «Ха-ха, удачи! Надеюсь, не продрогнешь до костей, пока не поймаешь на мушку хотя бы одного из нас!»104 Такое понимание контекста ранее было недоступно ни одному искусственному интеллекту.
Другим впечатляющим новшеством 2021 года стала мультимодальность. Ранее системы искусственного интеллекта в основном работали с одним конкретным типом данных: некоторые распознавали изображения, другие анализировали аудиофайлы, третьи, а именно, большие языковые модели, вели диалог. Следующим шагом стало объединение нескольких типов данных в одной модели. Компания OpenAI представила нейросеть DALL-E, название которой отсылает к художнику-сюрреалисту Сальвадору Дали и анимационному фильму WALL-E от Pixar105. Эта нейросеть-трансформер обучена выявлять связи между текстами и изображениями. С ее помощью можно создавать концептуально новые изображения, используя только текстовое описание, например, «кресло в форме авокадо». В 2022 году вышла ее новая версия, DALL-E 2106, а также нейросеть Imagen компании Google и ряд других интереснейших проектов, в частности Midjourney и Stable Diffusion. Нейронные сети нового поколения значительно расширили свои возможности, вплоть до создания реалистичных фотографий107. На основе короткого описания, например «панда, сидящая на мотоцикле на вершине горы, одетая в черную кожаную куртку и ковбойскую шляпу», ИИ может нарисовать правдоподобную картинку108. Такие способности могут серьезно повлиять на творческие процессы, которые ранее считались прерогативой исключительно людей.
Мультимодальные нейросети, вдобавок к умению создавать красивейшие изображения, обладают еще одним принципиальным достоинством. Такие модели, как GPT-3, оказались способны к «быстрому дообучению». Будучи уже натренированными, они могут обработать небольшой текстовый фрагмент и убедительно его дописать. Аналогично нейросети, предназначенные для создания картинок, начинают узнавать или даже сами рисовать незнакомые объекты, например единорогов, изучив всего лишь пять примеров вместо пяти тысяч или пяти миллионов, как требовали прошлые поколения ИИ. Но нейросети DALL-E и Imagen сделали еще один значительный шаг вперед. Они способны «дообучаться без примеров», комбинируя уже знакомые им концепции для создания новых изображений, совершенно не похожих ни на что из «увиденного» ими прежде. К примеру, по запросу «иллюстрация, на которой детеныш японской редьки в пачке выгуливает собаку» DALL-E рисует милые мультяшные изображения именно с таким сюжетом. Справляется она и с запросом «улитка в форме арфы» и даже «профессионально нарисованный эмодзи влюбленной чашки бабл-ти». В последнем случае нейросеть рисует на чашке плавающие шарики из тапиоки и над ними глаза в виде сердечек.
Обучение без примеров составляет саму суть мышления, основанного на аналогиях, и интеллекта в целом. Это свойство показывает, что ИИ не просто как попугай повторяет то, чему его обучили, а действительно усваивает идеи и способен применять их в новом контексте. В 2020-х годах одной из ключевых задач в сфере ИИ станет развитие этих навыков и расширение сферы их применения.
Помимо способности обучаться без примеров при решении определенных задач, нейросети также быстро учатся выходить за рамки изначально заданных им областей. Спустя 17 месяцев после того, как MuZero продемонстрировала выдающееся мастерство в нескольких играх, команда DeepMind представила Gato – единую нейросеть, способную справиться с самыми разными задачами. Она может проходить видеоигры, вести беседы в чате, описывать изображения и управлять роботизированной рукой109. По отдельности все эти функции уже были под силу ИИ, но их объединение в одной системе, подобной мозгу, стало значительным шагом на пути к созданию общего интеллекта, подобного человеческому. Как я предсказывал в своей книге «Сингулярность уже близка», нам предстоит объединить тысячи различных навыков в одном ИИ, прежде чем он сможет пройти тест Тьюринга. И теперь мы ожидаем стремительного прогресса в этом направлении.
Одним из основных средств для проявления человеческого интеллекта стало программирование. В конце концов, именно так мы создали ИИ. В 2021 году компания OpenAI представила сервис Codex, который по инструкции, заданной пользователем на естественном языке, создает работающий код на нескольких языках программирования, в частности, Python, JavaScript или Ruby110. Теперь любой человек, даже без опыта разработки, может описать, что должна делать его программа, и всего за несколько минут получить простое приложение или игру. В 2022 году компания DeepMind выпустила нейросеть под названием AlphaCode 111, обладающую еще более продвинутыми возможностями. К моменту выхода этой книги, вероятно, появятся еще более совершенные ИИ для создания приложений. В течение нескольких лет такие сервисы откроют перед многими людьми огромные возможности для творчества, поскольку умение программировать перестанет быть обязательным навыком для воплощения своих идей в реальных приложениях.
Несмотря на все достижения моделей, о которых мы только что говорили, у каждой из них возникают трудности при решении комплексных задач в отсутствие направляющей руки человека. Даже если им под силу выполнить все части задания по отдельности, они не в состоянии разобраться, как нужно комбинировать полученные решения. Однако в апреле 2022-го компании Google добилась значительного прогресса в этом направлении с помощью новой модели PaLM, содержащей 540 миллиардов параметров. Стоит особо отметить успехи этой нейросети в освоении двух фундаментальных проявлений человеческого интеллекта: юмора и логических рассуждений112.
Юмор кажется прерогативой исключительно людей, потому что он невероятно многогранен. Чтобы шутка показалась человеку смешной, он должен обладать жизненным опытом и знать, что такое игра слов или ирония. Порой комический эффект достигается сложными сочетаниями этих элементов. Неслучайно шутки очень трудно переводить на другие языки и объяснять представителям других культур. Тем не менее нейросеть PaLM оказалась в состоянии прочесть шутку и подробно рассказать, что именно в ней вызывает смех. Например, ей предложили такой мем: «Я должен был сесть за написание статьи в 17:00, но решил 10 минут поиграть с новой крутой языковой моделью. Через 10 минут я взглянул на часы, а уже 21:30!»113 PaLM идеально все растолковала:
В этой шутке говорится о том, как быстро летит время, когда вы развлекаетесь. Субъект должен был начать писать статью в 17:00, но вместо этого решил поиграть с языковой моделью. Ему казалось, что он занят игрой всего 10 минут, но в действительности прошло 4,5 часа114.
Еще важнее, что нейросеть могла объяснить, каким образом она пришла к своим выводам, приведя цепочку рассуждений, хоть и не с такой глубокой аргументацией (по крайней мере пока, в 2023-м), какая была бы у человека. Именно этого ожидают преподаватели, когда дают задание написать сочинение. Нужно не просто пересказать известный ответ, а продемонстрировать глубокое понимание явления, шаг за шагом построив логические связи. Большие языковые модели порой напоминают черный ящик: никто не может понять, каким образом они приходят к тем или иным выводам. Поясняя свои умозаключения, PaLM добивается большего доверия к своим ответам и помогает разработчикам находить конкретные проблемы, из-за которых она допускает ошибки. Кроме того, оказалось, что разбивка сложной проблемы на маленькие подзадачи позволяет PaLM удачно справляться даже с такими вопросами, на которые не каждый живой специалист смог бы дать ответ115:
Запрос: «Майкл находится во всемирно известном музее Франции и смотрит на самую знаменитую картину из коллекции музея. Художник, создавший это полотно, напоминает Майклу о его любимом с детства мультипликационном персонаже. В какой стране изобрели вещь, которую этот персонаж обычно держит в руках?»
Ответ ИИ: «Самая известная картина Лувра – это “Мона Лиза”. Ее написал художник по имени Леонардо да Винчи. Главного героя мультсериала “Черепашки-ниндзя” также зовут Леонардо да Винчи. Художник Леонардо да Винчи – итальянец. Обычно Леонардо да Винчи держит в руке катану. Катану изобрели в Японии. Ответ: “Япония”».
(Черепашку звали просто Леонардо, но нейросеть ответила «Леонардо да Винчи».)
В ноябре 2022 года компания OpenAI открыла доступ к интерфейсу нейросети GPT-3.5, назвав его ChatGPT116. Это позволило широкой публике в первый раз попробовать работу с большой языковой моделью. В течение двух месяцев этой возможностью воспользовались 100 миллионов человек, включая, вероятно, и вас117. Поскольку система умела генерировать оригинальные и разнообразные ответы на заданные вопросы, она произвела переполох в образовательной системе: школьники и студенты пользовались ChatGPT при написании сочинений, а у преподавателей не было надежного способа выявить обманщиков (хотя сейчас уже есть многообещающие разработки)118.
В марте 2024 года заработал интерфейс ChatGPT к нейросети GPT-4. Эта модель показала выдающиеся результаты на материалах целого ряда экзаменов, включая стандартизованный тест для приема в вузы в США (SAT), вступительный тест для юридических вузов (LSAT), школьные экзамены повышенной сложности (AP) и квалификационный экзамен для адвокатов119. Но самой главной особенностью новой нейросети стала ее способность рассуждать о гипотетических ситуациях, опираясь на понимание взаимосвязей между объектами и действиями. Это означает, что ИИ научился моделировать явления реального мира.
Таким образом, GPT-4 способна не просто решать сложные задачи по физике, но и точно предсказывать, что произошло бы, если бы законы природы изменились определенным образом. Кроме того, нейросеть может рассмотреть предложенную ситуацию с разных точек зрения. Например, ей понятно, что люди, смотрящие на цифры на витрине, стоя по разные стороны стекла, будут видеть их зеркально отраженными. Комментируя изображение воздушных шаров с грузом, GPT-4 отмечает, что, если перерезать ленты, шар улетит120. Она в состоянии даже отслеживать положение объектов с течением времени, как это было продемонстрировано в диалоге с инженером Дэниелом Фельдманом:
Запрос: «Я нахожусь у себя дома. На стуле в гостиной стоит кофейная чашка. В чашке лежит наперсток. Он не закреплен плотно внутри чашки. В наперстке находится алмаз. Я переношу стул в спальню. Затем ставлю кофейную чашку на кровать и опрокидываю ее, а после беру и ставлю ее на кухонный стол. Где мой алмаз?»
Ответ: «Когда вы опрокинули кофейную чашку на кровать, алмаз, который лежал в наперстке, вероятно, вывалился на кровать. Алмаз теперь лежит у вас на кровати»121.
В середине 2023 года, когда я заканчивал работу над книгой, последней новинкой была система PaLM – E, разработанная компанией Google. Она представляет собой роботизированный механизм, управляемый нейросетью уровня PaLM122. Робот получает инструкции на естественном языке и выполняет их, находясь в сложных условиях реального мира. Например, получив просьбу «принести пачку рисовых чипсов из ящика», PaLM-E перемещается по кухне, находит чипсы, берет их и доставляет. С такими навыками ИИ скоро станет неотъемлемой частью нашей повседневной жизни.
Прогресс в области ИИ движется с невероятной скоростью, и бумажная книга в этом плане не лучший источник новостей. Верстка и печать занимают около года, поэтому, даже если вы купите эту книгу сразу после ее появления на полках, наверняка успеют появиться впечатляющие новшества. Скорее всего, ИИ уже будет играть заметную роль в вашей жизни. Господствовавшая последние 25 лет парадигма поиска в интернете на основе страниц со ссылками, соответствующими вашему запросу, быстро сменяется ИИ-помощниками. Среди них стоит отметить Bard от компании Google – сервис на основе нейросети Gemini (более мощной, чем GPT-4), запущенный, когда эта книга была на стадии верстки. Другой пример – Bing от Microsoft, который использует одну из версий GPT-4123. Тем временем мощные инструменты ИИ начали встраивать в пакеты приложений, такие как Google Workspace и Microsoft Office. Это делает решение многих задач более простым и быстрым124.
Двигателем прогресса в сфере ИИ является стремление расширять нейросетевые модели до тех пор, пока их сложность не станет сравнима с человеческим мозгом. Я всегда придерживался мнения, что разумность в работе ИИ определяется количеством проведенных вычислений. До недавнего времени мало кто разделял это убеждение, а средств, чтобы убедительно его доказать, не существовало. Около трех десятилетий назад, в 1993 году, мы с моим наставником Марвином Минским провели открытую дискуссию. Я утверждал, что для симуляции человеческого интеллекта потребуется минимум 1014 операций в секунду. Минский со своей стороны доказывал, что количество операций в секунду не играет большой роли и что мы могли бы написать программу, имитирующую разум, для Pentium – центрального процессора в передовых компьютерах того времени. Дебаты состоялись в конференц-зале МТИ (аудитория 10-250) в присутствии нескольких сот студентов. Итогом стала ничья, поскольку я не располагал необходимыми для демонстрации машинного интеллекта вычислительными мощностями, а мой оппонент – нужными алгоритмами.
Однако выдающиеся успехи, достигнутые в рамках нейросетевого подхода в 2020–2023 годах, подтвердили, что скорость вычислений действительно играет ключевую роль при разработке достаточно умного ИИ. Я работаю в этой сфере с 1963-го. Прошло 60 лет, и теперь нам удалось выйти на показатели быстродействия компьютеров, достаточные для обучения эффективных нейросетей. Количество вычислений, используемых при обучении передовых моделей ИИ, каждый год увеличивается в 4 раза – с соответствующим результатом125.
Чего еще предстоит добиться ИИ?
Достижения последних лет показывают, что мы уже далеко продвинулись по пути создания нейросетей, возможности которых сравнимы с мощью новой коры головного мозга. На сегодняшний день ИИ не хватает способностей учитывать контекст, использовать здравый смысл и участвовать в социальном взаимодействии.
Контекстная память – это способность отслеживать, каким образом меняются связи между мыслями, которые мы выражаем в ходе разговора или переписки. Количество возможных связей между идеями растет экспоненциально с увеличением длины контекста, который мы учитываем. В начале этой главы мы рассуждали о потолке сложности – те же закономерности работают и здесь. Поэтому задача расширения контекста, учитываемого языковой моделью, невероятно трудна с вычислительной точки зрения126. Если в предложении содержится 10 идей, каждую из которых можно обозначить словом (то есть токеном), то количество возможных взаимосвязей между ними равно числу подмножеств множества из 10 элементов и составляет 210–1, то есть 1,023. А если в одном параграфе будет 50 таких идей, это даст 1,12 квадриллиона возможных контекстных связей между токенами! Хотя большинство из этих гипотетических связей не имеют под собой оснований, тем не менее перебрать их все и запомнить контекст для главы или целой книги становится непосильной задачей. Именно поэтому GPT-4 постепенно забывает сказанное вами по ходу разговора. По этой же причине чат-бот пока не может написать роман со связным и логичным сюжетом.
Есть две хорошие новости: во-первых, разработчики успешно решают задачу по проектированию ИИ, который будет в состоянии сосредоточиться только на важных элементах контекста, а во-вторых, экспоненциальный рост вычислительной мощности, скорее всего, приведет к снижению стоимости вычислительных ресурсов на 99 % за следующие 10 лет127. Более того, совершенствование алгоритмов и разработка специализированного оборудования для задач ИИ приведут к тому, что соотношение цена/производительность для систем, на которых работают языковые модели, улучшится еще сильнее128. Например, только с августа 2022 по март 2023 года стоимость обработки одних и тех же токенов через API GPT-3.5 снизилась на 96,7 %129! Эта тенденция еще усилится благодаря тому, что ИИ будет активно участвовать в проектировании чипов, что уже начинает происходить130.
Еще одним важным аспектом, с которым пока не может справиться искусственный интеллект, является способность рассуждать, опираясь на здравый смысл. Речь идет об умении вообразить различные обстоятельства или предвидеть последствия своих действий в реальном мире. Например, вы, возможно, никогда не задумывались, что произойдет, если в вашей комнате внезапно «выключится» гравитация, однако вы легко нарисуете у себя в голове эту картину и к чему этот случай приведет. Мы задействуем этот тип мышления при установлении причинно-следственных связей. Если у вас есть собака, а по возвращении домой вы обнаружите разбитую вазу, вам не составит труда догадаться, что произошло. Несмотря на то что периодически у ИИ случаются подобные озарения, в целом он испытывает большие трудности с такими умозаключениями. Все потому, что у него пока нет полной модели реального мира, а обучающие данные редко содержат такие скрытые знания.
Наконец, в текстовых базах данных не всегда можно найти достаточно информации о тонкостях общения, таких как ирония в голосе. А ведь именно на текстовых данных в основном и обучается искусственный интеллект. Без такого рода знаний сложно создать «модель психики человека», то есть научиться понимать, что другие имеют взгляды и знания, отличающиеся от ваших; ставить себя на их место; делать предположения об их намерениях. Однако ИИ быстро развивается в этом направлении. В 2021 году Блез Агиера-и-Аркас, почетный сотрудник исследовательского центра компании Google, представил доклад о том, как нейросеть LaMDA справилась с классическим тестом на понимание чужого сознания из области детской психологии131. В рассмотренном сценарии Алиса забывает очки в тумбочке и выходит из комнаты. Пока ее нет, Боб достает очки из тумбочки и прячет их под подушку. Вопрос: где Алиса будет искать очки, когда вернется? LaMDA дала верный ответ: в тумбочке. За последние два года модели PaLM и GPT-4 значительно улучшили свои способности давать правильные ответы на вопросы, связанные с пониманием работы разума и психики. Развитие этой функции позволит ИИ обрести гибкость мышления, которой ему пока не хватает. Например, человек, играющий в го, способен не только демонстрировать высокий уровень игры, но и обращать внимание на происходящее за соседними столами, отпускать шутки в подходящий момент, а также прервать игру, если кому-то из окружающих понадобится медицинская помощь.
Мой оптимизм в отношении будущего искусственного интеллекта основывается на трех стремительно развивающихся тенденциях: во-первых, снижение стоимости вычислений делает процесс обучения глубоких нейронных сетей более доступным; во-вторых, благодаря накоплению обширных и подробных наборов тренировочных данных обучение становится более конструктивным; в-третьих, развитие алгоритмов позволяет ИИ учиться и делать выводы более эффективно132. Хотя с 2000 года стоимость вычислительных ресурсов падает вдвое примерно каждые 1,4 года, фактически после 2010-го нам удается удваивать количество операций, используемых при обучении передовых нейросетей, всего за 5,7 месяца, то есть за весь период это число выросло в 10 миллиардов раз133. Для сравнения: до появления нейросетей глубокого обучения, а именно с 1952 года (когда появилась первая система машинного обучения, за шесть лет до разработки знаменитого перцептрона) по 2010 год (когда начался расцвет эпохи больших данных), количество операций, используемых для обучения ИИ, удваивалось каждые два года. Это примерно соответствует закону Мура 134.

Если бы тенденция, наблюдавшаяся с 1952 по 2010 год, сохранилась до 2021 года, то за эти 11 лет вычислительная сложность обучения нейронной сети увеличилась бы менее чем в 75 раз вместо 10 миллиардов. Такой значительный скачок нельзя объяснить только уменьшением стоимости вычислений, поэтому дело не в революционном развитии аппаратного обеспечения. Основную роль сыграли два фактора. Во-первых, программисты разработали новые методы параллельных вычислений, что позволило задействовать больше чипов при работе над одной задачей машинного обучения. Во-вторых, благодаря большим объемам данных глубокое обучение стало более эффективным. В результате инвесторы по всему миру начали вкладывать больше средств в эту отрасль, надеясь на появление прорывных технологий.
Расходы на обучение искусственного интеллекта растут параллельно с увеличением объема полезных данных. За последние несколько лет стало окончательно ясно, что любая задача, для которой можно четко определить критерии успеха, может быть решена с помощью модели глубокого обучения на уровне, значительно превышающем человеческий.
Люди обладают множеством навыков, весьма неоднородных в том, что касается доступности данных для обучения. Для некоторых умений можно привести количественную оценку, и собрать обучающую выборку тоже не составит труда. Например, при игре в шахматы существуют три возможных исхода: победа, поражение или ничья, а система рейтинга Эло предоставляет удобный способ ранжировать оппонентов в соответствии с уровнем мастерства. Данные для тренировки тоже удобно строить, поскольку игра состоит из дискретных ходов и протокол партии можно представить в виде математической последовательности. Некоторые навыки в принципе измеримы, но сбор и анализ данных по ним существенно затруднены. Представление интересов в суде имеет однозначный итог: победа или проигрыш. Однако достоверно выделить вклад юриста в исход дела по сравнению с тем, насколько сильны были позиции сторон изначально и как сказался настрой присяжных, уже гораздо труднее. А каким образом можно оценить способности писать стихи или держать в напряжении читателей мистического романа? Но даже в этих случаях можно выработать вспомогательные методики для обучения ИИ. К примеру, читатели могли бы давать оценку поэтичности стихотворения по стобалльной шкале. Другим вариантом может быть использование данных функциональной магнитно-резонансной томографии (фМРТ) для оценки активности определенных зон мозга. Частота сердечных сокращений или уровень кортизола могут дать представление о степени вовлеченности читателя. Таким образом, даже если данных для обучения недостаточно, можно использовать косвенные и не вполне точные показатели, чтобы помочь ИИ совершенствоваться. Другое дело, что поиск таких метрик потребует изобретательности и готовности экспериментировать.
Новая кора человеческого мозга может составить некоторое представление о тренировочном наборе данных, но грамотно спроектированная нейронная сеть способна находить такие закономерности, которые биологическому мозгу попросту недоступны. Достаточный набор данных обеспечит сверхчеловеческий уровень анализа в самых разных задачах: поиск игровой стратегии, вождение автомобиля, постановка диагноза на основе снимков, моделирование структуры белковых молекул. Таким образом, тщательный сбор данных, на который ранее исследователи предпочитали не тратить ресурсы, теперь становится экономически оправданным.
В каком-то смысле данные – новая нефть, месторождения которой существенно отличаются в плане доступности136. Где-то нефть бьет из-под земли, остается только очистить и переработать без больших затрат. В других случаях требуется расходовать средства на бурение, гидроразрыв пласта или нагрев скалы для извлечения нефти из сланца. Когда цена на сырье падает, нефтяные компании начинают разработку только простых и дешевых месторождений. Однако по мере роста цен становится экономически выгодным добывать нефть из более труднодоступных запасов.
Аналогичным образом, когда анализ больших объемов данных не давал ощутимой выгоды, компании собирали информацию только в тех областях, где это не требовало больших затрат. Но по мере развития методов машинного обучения и удешевления оборудования экономическая (а заодно и социальная) значимость труднодоступных данных будет только возрастать. В самом деле, буквально за последний год или два наши возможности по сбору, хранению, сортировке и анализу информации, касающейся человеческих навыков, значительно расширились137. В Кремниевой долине все только и говорят о больших данных, и не зря: фундаментальное преимущество этой технологии в том, что благодаря ей методы машинного обучения начинают приносить практическую пользу, что было невозможно при использовании малых объемов данных. В течение 2020-х годов этот процесс затронет практически все человеческие навыки.
Говоря о прогрессе ИИ в освоении отдельных навыков, стоит упомянуть любопытный факт. Мы привыкли думать о человеческом интеллекте как о некоей цельной сущности, которой ИИ либо обладает, либо нет. Но гораздо точнее и полезнее с практической точки зрения рассматривать человеческий разум как хитросплетение множества различных когнитивных навыков. Частью из них, например способностью узнавать себя в зеркале, обладают даже высокоразвитые животные, такие как слоны или шимпанзе. Другие, такие как умение сочинять музыку, доступны исключительно людям, и то не всем в равной степени. Умственные способности могут различаться не только от человека к человеку; в рамках одной личности навыки тоже бывают выражены в очень разной степени. Кто-то может быть математическим гением, но ужасно играть в шахматы; или обладать эйдетической (фотографической) памятью, но совершенно не уметь общаться с людьми. Прекрасным примером является герой Дастина Хоффмана в кинофильме «Человек дождя».
Когда разработчики ИИ говорят об интеллекте уровня человеческого, они обычно имеют в виду возможности лучших представителей нашего вида в конкретной области. В каких-то задачах даже очень талантливый человек ненамного превосходит среднестатистического, например, в распознавании букв родного алфавита. В то же время в других областях, таких как исследования по теоретической физике, разница между обычным человеком и мастером своего дела поистине огромна. В последнем случае может пройти ощутимо больше времени между тем, когда ИИ научится выполнять работу на уровне обычного человека и сумеет превзойти мастеров. Пока сложно сказать, какие именно навыки машинам будет труднее всего освоить. Возможно, в 2034 году ИИ будет легко писать музыкальные хиты и завоевывать премии «Грэмми», но не сможет сочинить сценарий, достойный премии «Оскар»; решит математические «Задачи тысячелетия», но не предложит новых философских концепций. Таким образом, переходный период после того, как ИИ пройдет тест Тьюринга и превзойдет человека почти во всех областях, но все еще будет уступать гениям в некоторых особых навыках, может оказаться достаточно долгим.
Применительно к достижению Сингулярности главное – это умение программировать вычислительную технику, а также владение сопутствующими дисциплинами, таками как теоретические компьютерные исследования. Это ключевое умение, которое позволит создать сверхмощный ИИ. Как только мы разработаем ИИ, способный обучать себя программированию (самостоятельно либо с помощью программиста-ассистента), запустится цикл положительной обратной связи. Ирвинг Джон Гуд, коллега Алана Тьюринга, еще в 1965 году предвидел, что такой механизм приведет к «взрывному росту интеллекта»138. Компьютеры работают быстрее людей, поэтому, исключив программистов из процесса разработки ИИ, можно добиться невероятного прогресса. Теоретики в сфере ИИ в шутку называют этот феномен «ФУУУМ», как будто график результатов ИИ выходит за пределы шкалы, сопровождаемый звуковым эффектом из комиксов139.
Часть исследователей, например Элиезер Юдковский, считает, что этот переход произойдет крайне быстро, сродни вертикальному взлету, и займет считаные месяцы, если вообще не минуты. Другие, в частности Робин Хэнсон, уверены, что процесс будет идти постепенно, аналогично плавному «набору высоты», на протяжении нескольких лет140. Я придерживаюсь промежуточной позиции. На мой взгляд, физические ограничения, такие как недостаточная мощность аппаратного обеспечения, а также нехватка ресурсов и актуальных данных, не дадут «ФУУУМу» произойти мгновенно. Однако нам необходимо продумать план действий на случай, если вертикальный взлет пойдет не по выгодному для нас сценарию. Важно помнить, что взрывной рост способностей позволит ИИ быстро овладеть и другими навыками, более сложными для него, чем самопрограммирование.
Машинное обучение становится все более экономичным, поэтому маловероятно, что именно вычислительная мощность станет сдерживающим фактором в создании разума уровня человеческого. Суперкомпьютеры уже с большим запасом укладываются в требования, которые ставит перед ними задача симуляции мозга человека. В 2023 году самый мощный суперкомпьютер Frontier, построенный Национальной лабораторией Ок-Риджа, уже способен выполнять порядка 1018 вычислений в секунду141, что превосходит предполагаемую максимальную производительность человеческого мозга (1014 операций в секунду) в 10 000 раз142.
В книге «Сингулярность уже близка» я приводил оценку вычислительной мощности мозга: 1016 операций в секунду. Эта величина получилась с учетом того, что в мозгу содержится порядка 1011 нейронов, от каждого из которых отходит по 103 синапсов, способных посылать 102 сигналов в секунду143. Однако, как я тогда же отметил, мне нужна была верхняя оценка. На самом деле, как показывают исследования, мозг выполняет намного меньшее количество операций каждую секунду. Нейроны активируются гораздо реже, чем мы предполагали: не двести раз в секунду, как это могло бы быть теоретически, а примерно один раз в секунду144. Более того, исследователи в проекте AI Impacts, проанализировав потребление энергии мозгом, предположили, что каждый нейрон в среднем возбуждается 0,29 раза в секунду145. Это означает, что общее количество операций за секунду может составлять всего лишь 1013. Ханс Моравец, используя другой метод, получил такую же оценку, опубликованную в его книге «Дети разума: перспективы интеллекта роботов и людей»146.
Мы все еще рассуждаем в предположении, что для функционирования разума необходимы все нейроны мозга, хотя уже знаем, что это не так. Параллелизм операций в мозгу еще плохо изучен, но известно, что отдельные нейроны и целые модули выполняют дублирующие функции или операции, которые хотя бы в теории могли бы осуществляться в другой области. Подтверждением тому служат истории полного восстановления работоспособности людей после инсультов или травм, затрагивающих часть мозга147. Так что объем вычислений, необходимый для моделирования нейронных структур, имеющих отношение к разуму, будет еще скромнее, чем приведенные выше оценки. Поэтому величина 1014 операций в секунду кажется надежной верхней границей. По состоянию на 2023 год такое быстродействие может обеспечить электроника стоимостью всего в тысячу долларов148. Даже если в итоге потребуется 1016 операций в секунду, к 2032 году мы сможем уложиться в ту же сумму149.
Все эти оценки основываются на моем убеждении, что система, имитирующая активацию нейронов, станет полноценной моделью мозга. Может оказаться, что для возникновения субъективного сознания потребуется более подробная симуляция. Это философский вопрос, ответ на который нельзя найти с помощью научного метода. Тем не менее не исключено, что потребуется смоделировать отдельные ионные каналы внутри нейронов или взаимодействие молекул тысяч различных веществ, участвующих в обменных процессах в клетке. По оценкам Андерса Сандберга и Ника Бострома из оксфордского Института будущего человечества, описанные уровни абстракции потребуют выполнения 1022 или 1025 операций в секунду соответственно150. Но даже в последнем случае, согласно их расчетам, суперкомпьютер стоимостью в 1 миллиард долларов (в ценах 2008 года) сможет обеспечить необходимую вычислительную мощность к 2030 году. А к 2034 году такой компьютер и вовсе будет в состоянии смоделировать каждую молекулу белка каждого нейрона151. Со временем, конечно же, экспоненциальный рост эффективности вычислений значительно сократит эти затраты.
Я хотел бы еще раз подчеркнуть: даже при существенном изменении требований к симуляции мой основной прогноз остается в силе – компьютерное моделирование человеческого мозга в любой интересующей нас форме станет реальностью в ближайшие пару десятилетий, а не через сто лет. Так что именно нам, а не нашим внукам, предстоит разбираться с последствиями. Уже с 2020-х годов продолжительность жизни будет увеличиваться быстрыми темпами. Если вам сейчас меньше 80 лет и вы относительно здоровы, вы, вероятно, увидите это событие своими глазами. Тест Тьюринга будет пройден, когда дети, родившиеся в наше время, пойдут в начальную школу. А функциональная модель мозга будет создана, когда они будут учиться в колледже. И последняя точка отсчета: я заканчиваю писать эту книгу в 2023 году. Похоже, мы уже ближе к созданию полной модели мозга, чем к моменту выхода моей первой книги «Век духовных машин» в 1999 году, когда я впервые озвучил свои прогнозы.
Прохождение теста Тьюринга
Каждый месяц ИИ овладевает все более сложными навыками, а стоимость вычислений, необходимых для его работы, неуклонно снижается. Траектория развития ясна. Но как мы поймем, что ИИ достиг уровня человеческого мозга? Тест Тьюринга дает нам возможность подойти к этому вопросу с научной точки зрения. Однако сам Тьюринг не обозначил всех условий эксперимента, например, он не уточнил, сколько времени должна продолжаться беседа машины и человека и какими качествами должен обладать судья. Девятого апреля 2002 года я и Митч Капор, один из первых разработчиков программ для персональных компьютеров, заключили пари в проекте фонда Long Now. Мы поспорили о том, будет ли пройден тест Тьюринга к 2029 году152. В ходе обсуждения возникло множество новых вопросов, в частности, о допустимом уровне усовершенствования мышления человека, при котором он все еще может быть судьей или участником.
Подробно описанная методика проведения теста крайне важна, поскольку, как мы уже упоминали ранее, люди склонны в ретроспективе недооценивать сложность задач, решенных ИИ. Это явление получило название «синдром искусственного интеллекта»153. За семь десятилетий, прошедших со дня описания Аланом Тьюрингом его игры в имитацию, компьютеры постепенно превзошли людей в ряде специфических аспектов интеллекта. Однако чего машинам всегда недоставало, так это гибкости и широты охвата человеческой мысли. После победы суперкомпьютера Deep Blue фирмы IBM над чемпионом мира по шахматам Гарри Каспаровым в 1997 году многие комментаторы не сочли это достижение значимым в том, что касается моделирования общего интеллекта154. Игру в шахматы легко описать математически, потому что расположение и свойства фигур на доске определяются однозначно, количество допустимых ходов сравнительно невелико. Так что победу над Каспаровым можно отнести на счет хитроумных вычислений. При этом ряд наблюдателей уверенно заявлял, что машины никогда не добьются успеха в многогранных задачах, связанных с обработкой фраз на естественном языке, таких как разгадывание кроссвордов или телевизионная игра «Джеопарди!»155. С кроссвордами машины справились через два года156, а менее чем двенадцать лет спустя суперкомпьютер Watson, разработанный компанией IBM, сыграл в «Джеопарди!» и победил двух самых успешных игроков за всю историю этой игры – Кена Дженнигса и Брэда Руттера 157.
Эти викторины выявили очень интересную особенность ИИ. Наблюдая, как ловко Watson вникает в игровые подсказки, ищет информацию и уверенно озвучивает правильные ответы роботизированным голосом, легко было поддаться иллюзии, что компьютер размышляет примерно так же, как Кен или Брэд. Однако у зрителей была дополнительная информация. В нижней части экрана отображались три лучшие версии, полученные суперкомпьютером, в порядке убывания вероятности. Хотя в первой строчке почти всегда содержался верный ответ, две другие догадки были не просто неверными, они были смехотворно неподходящими. Таких нелепых ошибок не допустил бы даже самый слабый из игроков-людей. Например, на вопрос «Члены этого органа избираются каждые 5 лет, сейчас в нем заседают 736 человек из 7 фракций»158 из категории «ЕС, Европейский союз» Watson дал верный ответ «Европейский парламент», присвоив ему вероятность 66 %. Вторым вариантом было «ДЕП» (депутаты Европарламента, 14 %), а третьим с вероятностью 10 % шло «всеобщее избирательное право»159. Даже тот, кто никогда не слышал о Европарламенте, не мог бы предположить, что варианты 2 или 3 являются верными, хотя бы исходя из формулировки вопроса. Таким образом, хотя стиль игры Watson был похож на человеческий, «под капотом» явно происходили процессы, не свойственные мышлению человека.
В последние годы нам удалось научить ИИ гораздо лучше понимать и использовать естественные языки. В 2018 году компания Google представила сервис Duplex – роботизированного помощника, умеющего настолько хорошо общаться по телефону, что ничего не подозревавшие собеседники были уверены, что говорят с человеком. В том же году компания IBM разработала систему Project Debater, способную вести осмысленные споры160. А к 2023 году большие языковые модели уже научились писать сочинения так же хорошо, как люди.
Однако, несмотря на все свои достижения, даже GPT-4 время от времени оказывается подвержен «галлюцинациям»: ИИ уверенно выдает утверждения, не имеющие ничего общего с реальностью161. Например, если попросить его кратко пересказать несуществующие новости, он может сочинить весьма правдоподобную сводку. А в ответ на просьбу указать источники достоверного научного факта нейросеть может перечислить несуществующие статьи. Сейчас ведется активная работа над устранением этой проблемы162, но пока неясно, насколько сложной она окажется в итоге. Появление таких ошибок лишний раз свидетельствует о том, что, как и в случае с Watson, современные мощные системы ИИ находят ответы путем сложных математических и статистических вычислений, что сильно отличается от привычного нам мышления.
Интуитивно нам это не нравится. Кажется, что Watson «должен» рассуждать, как человек. Но, на мой взгляд, это предрассудки. На самом деле нам важно, как разумное существо действует. Если к выдающемуся научному открытию или душещипательному сюжету его приведут иные мыслительные процессы, то что с того? А в случае, когда ИИ будет утверждать, что обладает сознанием, какие у нас будут основания настаивать, что только биологическая система, подобная нашей, может считаться по-настоящему разумным организмом? В этом смысле эмпирический тест Тьюринга предоставляет нам верные ориентиры.
Хотя тест Тьюринга может стать отличным инструментом для оценки прогресса ИИ, его прохождение не стоит считать единственно возможным критерием развитого интеллекта. Как показывают системы PaLM 2 и GPT-4, машины могут превосходить людей в решении сложных задач, при этом не научившись убедительно имитировать действия человека во всех возможных ситуациях. По моим прогнозам, в промежутке между 2023 и 2029 годами, когда будет пройден тест Тьюринга, компьютеры уже превзойдут людей в самых разных областях деятельности. Более того, не исключено, что ИИ научится самосовершенствоваться раньше, чем учитывать нюансы человеческого общения, необходимые для прохождения теста. Уверенности в этом нет, но сама возможность заставляет нас более тщательно рассмотреть определение «интеллект уровня человеческого». В этом определении немалую роль сыграет тест Тьюринга, но нам также необходимо разработать более сложные методы, чтобы понять, в чем разница между человеческим и машинным интеллектом и в чем они схожи.
Хотя не все согласны, что тест Тьюринга – это надежный способ определить, обладает ли машина интеллектом, сравнимым с человеческим, я убежден, что его успешное прохождение убедит наблюдателей и широкую публику в том, что они имеют дело с настоящим разумом, а не просто с имитацией. Как писал Тьюринг в 1950 году: «Разве не может внутри машины происходить процесс, не похожий на тот, что идет в голове человека, и который тем не менее иначе как мышлением не назовешь? <…> Но если при этом машина способна показать удовлетворительный результат в игре в имитацию, значит, аргумент о несхожести внутренних процессов мышления не должен нас беспокоить»163.

На этом рисунке представлены задачи, с которыми искусственному интеллекту еще предстоит справиться. Листки на полу символизируют уже освоенные ИИ навыки, а над теми, что пока висят на стене, очерченные пунктирными линиями, ведется активная работа. (Только человек может играть в бейсбол. Только у людей есть здравый смысл. Только человек может написать рецензию на фильм. Только люди проводят пресс-конференции. Только человек может навести порядок в доме. Человеческая раса. Только человек может написать книгу о компьютере. Только человек может переводить речь. Только люди могут мастерски играть в го. Только человек может поставить диагноз по ЭКГ. Прочие новости Мы все еще удерживаем Берлин. Только человек может сочинять музыку, подражая Баху. Только люди могут играть в настольный теннис. Только люди могут узнавать лица. Человек может управлять ракетой. Только люди могут импровизировать в джазе. Только люди могут мастерски играть в шахматы. Только люди могут инвестировать. Только человек может водить машину. Только люди могут понимать непрерывную речь. Только люди могут понимать естественный язык. Только люди могут доказать важные теоремы. Только люди могут…)
Важно отметить, что, если искусственный интеллект успешно пройдет строгий тест Тьюринга, это будет означать, что он способен продемонстрировать более высокие результаты, чем человек, на любом экзамене, проводимом на естественном языке164. Независимо от того, в какой области ИИ проявляет свои слабые стороны, письменный тест способен их обнаружить. Конечно, это возможно только при условии, что судьи и собеседники сами достаточно компетентны и внимательны. Не составит труда притвориться выпившим, сонным или не владеющим языком человеком165. Кроме того, ИИ, который сумеет обмануть судей, не знакомых с методикой тестирования его способностей, не будет считаться прошедшим тест.
Тьюринг считал, что такой тест подходит для оценки способностей ИИ в «любой из областей человеческой деятельности по нашему усмотрению». Находчивый экзаменатор может попросить ИИ объяснить сложную ситуацию в общении между людьми, сделать выводы на основе представленных научных данных, предложить смешную сцену для комедии. Таким образом, тест Тьюринга проверяет не просто понимание естественного языка, а наличие умственных способностей, которые мы проявляем посредством речи. Конечно, успешный ИИ не должен производить впечатление сверхчеловека. Если экзаменуемый будет мгновенно отвечать на все энциклопедические вопросы, быстро проверять числа на простоту и бегло говорить на сотне языков, станет ясно, что с нами общается не человек.
Кроме того, искусственный интеллект, который достигнет такого уровня, будет обладать способностями, значительно превосходящими человеческие, начиная с объема памяти и заканчивая скоростью мышления. Вообразите себе систему, умеющую читать на уровне человека и обладающую банком данных со всеми статьями из «Википедии» и полным архивом научных публикаций за всю историю. Пока что именно недостаточно глубокое понимание нашего языка не позволяет ИИ эффективно наращивать свой объем знаний. Прогресс людей же сдерживается низкой скоростью чтения, скромным объемом памяти и в целом слишком короткой жизнью. Компьютеры уже в состоянии обрабатывать данные с потрясающей скоростью: если человеку на чтение одной книги требуется в среднем около шести часов, сервис Talk to Books компании Google справляется с этой задачей в пять миллиардов раз быстрее166. Кроме того, объем памяти компьютеров практически не ограничен.
Смена парадигм обработки информации в процессе эволюции

Когда ИИ овладеет языком на уровне человека, ему не просто станет легче постепенно пополнять свои знания, скорее это приведет к взрывному росту его эрудиции. Чтобы пройти затем тест Тьюринга, ему буквально придется прикидываться дураком! В тех же задачах, где не будет нужды имитировать человеческое поведение, например в области медицины, химии, инженерии, ИИ уровня Тьюринга сможет достичь небывалых успехов.
К чему это приведет, мы обсудили в предыдущей главе, когда говорили о шести информационных эрах. В таблице «Смена парадигм обработки информации в процессе эволюции» кратко изложены основные моменты.
Расширение новой коры с помощью облачных сервисов
К сожалению, пока что наши возможности в области прямого обмена сигналами с мозгом с использованием электроники, будь то снаружи или внутри черепа, остаются ограниченными. Неинвазивные методы не позволяют достичь одновременно высокого пространственного и временного разрешения, поэтому в чем-то приходится жертвовать точностью измерения. Функциональная магнитно-резонансная томография (фМРТ) позволяет измерять объем кровотока в мозге, что служит индикатором возбуждения нейронов167. Чем активнее определенный участок мозга, тем больше глюкозы и кислорода ему требуется, что приводит к притоку артериальной крови. В объеме мозга этот приток можно обнаружить с точностью до воксела (кубик со стороной 0,7–0,8 мм), что достаточно для получения важных выводов168. Однако, поскольку кровь поступает к активному участку мозга с задержкой, наши приборы могут обнаружить активность лишь спустя несколько секунд, а в редких случаях – от 400 до 800 миллисекунд169.
Электроэнцефалограмма (ЭЭГ) подвержена другой проблеме. Этот метод позволяет измерить электрическую активность мозга, так что сигнал регистрируется с точностью до миллисекунды170. Однако, поскольку сигналы считываются с поверхности головы, невозможно точно определить, какая часть мозга их генерирует. Поэтому пространственное разрешение метода составляет от 6 до 8 кубических сантиметров, в лучшем случае – от 1 до 3171.
В 2023 году невозможность достичь высокого пространственного и временного разрешения при сканировании мозга является одной из ключевых проблем нейробиологии. Причиной затруднений служат фундаментальные свойства электричества и физика течения крови, так что даже с помощью современных датчиков и искусственного интеллекта пока не удается добиться значительного прогресса. Продвинутый интерфейс мозг-компьютер таким образом не построить.
От проблемы пространственно-временного компромисса можно уйти, если поместить электроды в мозг. Тогда мы сможем не только считывать сигналы каждого отдельного нейрона, но и стимулировать его – коммуникация будет двусторонней. Однако на современном уровне технологий вживить электроды можно только через отверстия в черепе, что сопряжено с риском повредить мозговую ткань. Поэтому пока такие методы применяются только для пациентов с нарушениями функции нервной системы, такими как потеря слуха или паралич. В этих случаях возможная польза перевешивает риск. К примеру, система BrainGate позволяет людям с БАС или повреждениями спинного мозга силой мысли управлять курсором на экране или механической рукой172. Однако такая вспомогательная технология позволяет подключаться к весьма небольшому количеству нейронов, поэтому с ее помощью нельзя обрабатывать сложные сигналы наподобие речи.
Технология перевода мыслей в текст стала бы революционным новшеством, что стимулирует исследования по созданию устройств, интерпретирующих мозговые волны. В 2020 году команда разработчиков провела эксперимент, в ходе которого на головы людей было установлено 250 внешних электродов. С помощью мощного искусственного интеллекта исследователи пытались сопоставить активность коры мозга с набором слов из тестовых предложений. Исследователи использовали ограниченный словарь из 250 слов и смогли распознать мысли человека с погрешностью не более 3 %. Результат впечатляет, но в 2021 году проект закрыли174. Пока неясно, удастся ли масштабировать этот эксперимент, используя словари с большим количеством слов (и, соответственно, получив более сложные сигналы), или же технология упрется в проблему пространственно-временного разрешения. Так или иначе, чтобы расширить возможности неокортекса, нам необходимо найти способ двусторонней коммуникации с большим количеством нейронов одновременно.
Одной из самых многообещающих попыток подключения к максимальному числу нейронов стала технология Neuralink, разработанная компанией Илона Маска. Эта система предполагает имплантацию в мозг множества тонких электродов175. Опыты на мышах показали, что можно считывать данные сразу с 1500 электродов, что значительно больше, чем в других проектах, где обычно задействуются сотни электродов176. Обезьяна, которой вживили такой чип, научилась с его помощью играть в видеоигру Pong177. После ряда согласований в 2023 году Управление по санитарному надзору за качеством пищевых продуктов и медикаментов (FDA) разрешило проводить испытания на людях. На момент подготовки этой книги к печати Neuralink только имплантировала первый чип с 1024 электродами в мозг человека178.
В настоящее время Агентство перспективных исследовательских проектов Министерства обороны (DARPA) США работает над долгосрочным проектом под названием «Проектирование нейроинженерной системы» (NESD). Его цель – создать устройство, способное считывать информацию с одного миллиона нейронов и передавать сигналы ста тысячам179. В рамках этого проекта агентство выделило гранты на реализацию нескольких программ. Например, команда Университета Брауна разрабатывает так называемые «нейрозерна» – микроскопические устройства, которые можно имплантировать в мозг. Эти «зерна» будут образовывать связи с нейронами и друг с другом, создавая своего рода «кортикальный интранет» внутри нашего мозга180.
В итоге мы стремимся создать неинвазивный интерфейс, который, вероятно, будет состоять из наноразмерных электродов, без какого-либо риска доставляемых в мозг через кровеносную систему.
Сколько же вычислительных операций нам предстоит записать? Как мы уже выяснили, общее количество вычислений, необходимых для полноценного моделирования человеческого мозга, составляет не более 1014 за секунду. Заметим, что речь идет о симуляции на основе реальной структуры мозга, способной пройти тест Тьюринга и в принципе для стороннего наблюдателя неотличимой от настоящего мозга человека. Такая симуляция не обязательно должна включать в себя все процессы, происходящие в мозге, поскольку часть из них не влияет на наблюдаемое поведение. Например, крайне маловероятно, что внутриклеточные процессы, такие как репарация ДНК в ядре нейрона, имеют отношение к мышлению.
Но даже если в мозге происходит 1014 операций каждую секунду, не все из них обязательно передавать через интерфейс мозг-компьютер. Многие из этих операций связаны с предварительной обработкой информации в структурах, расположенных глубже верхнего слоя неокортекса181. А нам нужно подключиться именно к высшим областям мозга. Кроме того, мы можем игнорировать процессы, которые не относятся к разуму, такие как регуляция пищеварения. Так что, по моим оценкам, нам потребуется интерфейс, способный образовывать миллионы, может быть, десятки миллионов параллельных связей.
Чтобы этого добиться, нам придется все сильнее уменьшать размеры устройств, попутно решая возникающие инженерные и нейробиологические задачи с помощью продвинутого ИИ. В 2030-х годах мы достигнем цели, создав микроскопических роботов, так называемых наноботов. Эти крошечные устройства свяжут высшие участки коры нашего мозга с облачным сервисом, позволяя биологическим нейронам напрямую обмениваться сигналами с программными нейронами через Всемирную сеть182. Для этого не потребуется проводить хирургические операции на грани фантастики – наноботов можно будет доставить в мозг неинвазивным способом, через капилляры. До сих пор размер нашего мозга был ограничен необходимостью проходить через родовые пути, теперь же его можно будет расширять бесконечно. Как только мы подключим первый слой виртуальной коры, поверх него (в иерархическом смысле) можно будет размещать последующие, что будет делать наше мышление все более сложным. Стоимость вычислительных мощностей продолжит снижаться, но теперь вместе с возможностями компьютеров будет расти и потенциал нашего мозга.
Помните, что случилось два миллиона лет назад, после предыдущего апгрейда нашего неокортекса? Мы стали людьми. Когда мы получим доступ к облачному неокортексу, то, скорее всего, совершим похожий скачок в уровне абстрактного мышления. В результате проявления нашего интеллекта станут намного глубже и богаче, чем искусство и технологии. Изменения будут настолько фундаментальными, что сейчас мы не можем их себе даже представить.
Вообразить себе искусство будущего невозможно. Но если попытаться провести аналогию, стоит вспомнить последнюю революцию, касающуюся неокортекса. Представьте, как обезьяна – достаточно развитое животное с мозгом, который не сильно отличается от человеческого, – смотрела бы кинофильм. Часть картинки имела бы для нее смысл. Она могла бы понять, что на экране люди разговаривают, но не смогла бы разобрать ни слова из диалога. Ей также не пришла бы в голову мысль, что «то, что герои носят металлические костюмы, означает, что действие происходит в Средние века»183. Такие суждения стали возможны благодаря префронтальной коре.
Когда мы говорим об искусстве для людей с облачным неокортексом, мы имеем в виду не только более качественную графику или возможность ощущать вкус и запах. Нам откроются принципиально новые возможности, связанные с тем, как мозг обрабатывает впечатления. В наши дни актеры могут передавать особенности характера героя только с помощью слов и движений. Однако мы можем создать вид искусства, в котором найдут отражение глубинные, неоформленные и невысказанные мысли героя, которые будут загружаться прямо в наш мозг во всем их невыразимом великолепии и многообразии. Интерфейс мозг-компьютер станет важным инструментом, который обогатит нашу культуру.
Мы станем соавторами самих себя: будем развивать свой интеллект, чтобы уметь мыслить глубже, а затем использовать новые возможности для создания новых трансцендентных идей, осмыслить которые будет под силу только новым версиям нашего мозга. Наконец-то мы получим доступ к своему исходному коду подобно ИИ, который способен совершенствовать себя. Эти технологии позволят нам объединиться со сверхинтеллектом, который мы сами сконструируем, так что, по сути, мы создадим себя заново. Освободив наш разум от ограничений черепа и перенеся его на устройства, в миллионы раз более мощные, чем биологические ткани, мы добьемся экспоненциального роста возможностей нашего интеллекта и станем в миллионы раз умнее. Именно это я имею в виду, когда говорю о Сингулярности.
Глава 3. Что такое «Я»?
Что такое сознание?
Тест Тьюринга и другие подобные методики могут многое рассказать нам о том, что значит быть человеком в принципе, но разговор о технологиях уровня Сингулярности подразумевает, что мы зададимся и другим вопросом: каково это – быть данной конкретной личностью? Какое место в этом всем занимает Рэй Курцвейл? Допустим, вас не так сильно интересует именно Курцвейл; людей волнуют прежде всего их собственные переживания, так что вам захочется узнать то же самое о себе. Но в моем случае почему я оказался Рэем Курцвейлом? Почему я смотрю на мир глазами именно этого человека? Почему я не родился, скажем, в 1903-м или 2003-м? Почему я оказался мужчиной, да и вообще человеком? Едва ли можно найти ответы на эти вопросы с научной точки зрения. Вопрос «кто я?» – это одна из фундаментальных проблем философии. Он тесно связан с понятием сознания.
В книге «Эволюция разума» я приводил цитату Сэмюэла Батлера:
Есть растения, которые питаются органической пищей с помощью своих цветов: когда муха садится на цветок, лепестки закрываются и удерживают ее, пока растение не всосет насекомое в себя; но цветок закрывается только тогда, когда в него попадает что-то пригодное для еды; капля дождя или кусок веточки не привлекают его внимания. Удивительно, что столь несознательное существо с таким вниманием преследует свои интересы. Если это отсутствие сознания, то в чем же заключается сознание 1?
Батлер записал свои наблюдения в 1871 году2. Должны ли мы сделать вывод, что растения и в самом деле обладают сознанием? Или, возможно, только этот конкретный вид растений? Как нам это проверить? Мы можем утверждать, что другой человек обладает сознанием, основываясь на его способности общаться и принимать самостоятельные решения в той же манере, что и мы сами. Однако даже в этом случае мы, строго говоря, полагаемся на предположения. Природа не снабдила нас детектором наличия или отсутствия сознания.
Но что вообще такое «сознание»? Этот термин часто используется в двух различных, хотя и взаимосвязанных значениях. Первое из них описывает способность человека воспринимать окружающую обстановку и реагировать на нее, учитывая как свои внутренние переживания, так и то, что происходит вокруг. Согласно этому определению, например, мы можем сказать, что глубоко спящий человек находится без сознания, выпивший – частично в сознании, а трезвый и бодрствующий человек – полностью в сознании. За исключением редких случаев, таких как «синдром запертого в теле», мы, как правило, без труда можем определить, насколько тот или иной человек осознает происходящее. Даже некоторые аспекты поведения животных, такие как узнавание себя в зеркале, помогают пролить свет на природу этого явления. Но когда речь заходит о вопросах личности наподобие тех, что поднимаются в этой главе, на первый план выходит другое значение понятия «сознание»: способность проживать субъективный опыт внутри себя, а не просто создавать видимость этого. Философы называют этот опыт словом «квалиа». Так что, когда я говорю, что мы не можем непосредственно определить, обладает ли кто-то сознанием, я имею в виду, что снаружи невозможно понять, испытывает ли этот человек квалиа.
Несмотря на то что не существует способа достоверно установить наличие у кого-то сознания, игнорировать это явление нельзя. Если задуматься об основах нашей этики и морали, то станет ясно, что наши этические суждения во многом зависят от нашего восприятия сознания. Объекты материального мира, вне зависимости от их ценности и сложности, представляют для нас интерес лишь в той мере, в какой они влияют на сознательный опыт живых существ. Споры о правах животных в конце концов сводятся к тому, в какой мере, по нашему мнению, они обладают сознанием и какова природа их сознательного опыта3.
Сознание – это сложный философский вопрос. Когда мы рассуждаем об этических вопросах, в частности, говорим о правах тех или иных существ, то опираемся на наше представление об их субъективном опыте. Однако поскольку мы не можем достоверно определить его наличие, то пользуемся первым определением сознания как вспомогательным средством, проводя аналогии со своим опытом. Каждый из нас – как я предполагаю! – имеет внутренний опыт, и мы также осознаем, что демонстрируем функциональную осознанность, которую могут наблюдать другие люди. Поэтому мы считаем, что, когда другие проявляют осведомленность о своем окружении, это свидетельствует о наличии у них субъективного опыта. Даже ученые, которые утверждают, что субъективный опыт и эмпирическое мышление не связаны друг с другом, тем не менее ведут себя так, будто люди вокруг них находятся в сознании и осознают свой опыт.
Мы без особых колебаний готовы признать существование сознания у других людей. Однако когда речь заходит о животных, наша уверенность существенно ослабевает, особенно в отношении тех, чье поведение сильно отличается от нашего. Например, собаки и шимпанзе не обладают интеллектом, сравнимым с человеческим, но демонстрируют сложное поведение и проявляют эмоции, что, по мнению большинства людей, неразрывно связано с субъективным опытом. А как насчет грызунов? Они тоже иногда ведут себя подобно людям: играют с сородичами и проявляют страх перед опасностями4. Однако гораздо меньше людей считают грызунов сознательными, и многие согласятся, что их субъективный опыт гораздо более поверхностный, чем у людей. А насекомые5? Плодовые мушки едва ли могут читать наизусть Шекспира, но их поведение зависит от обстоятельств и окружающей обстановки, а мозг состоит из 250 тысяч нейронов. Для сравнения: мозг таракана содержит один миллион нейронов, что составляет лишь 0,001 % от количества нейронов в человеческом мозге. Это означает, что у тараканов гораздо меньше возможностей для формирования сложных иерархических нейронных сетей. Существуют еще амебы. Эти одноклеточные организмы не демонстрируют признаков функционального сознания, в отличие от людей и животных. Однако в XXI веке ученые обнаружили зачатки интеллекта, в частности памяти, даже у этих примитивных живых существ6.
В некотором смысле, наличие сознания можно рассматривать как дихотомию: испытывает ли живое существо квалиа или нет. Однако меня интересует еще и степень этой осознанности. Вспомните, насколько отличается ваше состояние, когда вы слегка задремали или если вы бодрствуете, но немного выпили или вас клонит в сон, от того, когда вы полностью сосредоточены. Какой точке на этой непрерывной шкале соответствует сознание животных, вот что интересует исследователей. Сегодня эксперты склонны полагать, что сознание есть у большего числа видов животных и оно более глубокое, чем считалось ранее. В 2012 году группа ученых из разных областей собралась в Кембриджском университете, чтобы обсудить свидетельства наличия сознания у животных, не относящихся к приматам. В результате была подписана Кембриджская декларация о сознании, в которой утверждалось, что сознание, вероятно, присутствует не только у людей. Как говорится в документе, «отсутствие новой коры вовсе не означает, что организм не испытывает аффективных состояний»7. Подписанты пришли к выводу о существовании «неврологических субстратов, которые порождают сознание» у «всех видов млекопитающих и птиц и многих других организмов, включая осьминогов»8.
Научные исследования показывают, что функциональное сознание возникает в развитом мозге. Но что именно дарит нам субъективные ощущения? Некоторые считают, что это Бог. Другие уверены, что сознание является результатом исключительно физических процессов. Но независимо от того, какой стороны придерживаются люди – религиозной или материалистической, – они воспринимают сознание как нечто священное. Вопрос, каким образом люди (и по крайней мере несколько видов животных) пришли к сознанию, остается открытым: произошло это в результате Божественного провидения либо эволюционных процессов. Однако ценность этого явления не вызывает сомнений. Любой, кто не признает наличия у ребенка сознания и способности чувствовать страдание, будет всеми признан абсолютно аморальным человеком.
Однако вопрос о том, что именно порождает субъективный опыт, вскоре перестанет быть исключительно философским упражнением. С развитием технологий у нас появится возможность расширить сознание за пределы биологического мозга. Тогда нам предстоит определить, что именно играет ключевую роль в формировании квалиа – ядра нашей личности, и сосредоточить усилия на сохранении этого. Поскольку мы можем судить о наличии субъективного опыта только по наблюдаемому поведению, наши интуитивные предположения совпадают с наиболее вероятным научным выводом. А именно, что мозг, способный обеспечивать более сложное поведение, может создавать и более замысловатое субъективное сознание.
Как мы уже обсуждали в предыдущей главе, нетривиальное поведение является результатом сложных процессов обработки информации в мозге9. Эта сложность, в свою очередь, обусловлена количеством иерархических уровней в нейронной сети мозга и гибкостью, с которой он способен представлять информацию.
Это чрезвычайно важное соображение, которое может определить будущее человечества и ваше собственное, если вам посчастливится прожить еще несколько десятков лет. Мы уже говорили, что интеллектуальными достижениями за всю историю человек обязан мозгу, структура которого ничуть не изменилась со времен каменного века. Современные технологии позволяют нам пользоваться огромным багажом знаний, накопленных всеми представителями нашего вида, но мы работаем с ними на том же уровне сознания, что и наши предки в эпоху неолита. Как только мы сможем расширить неокортекс, а я думаю, что это произойдет по ходу 2030-х и 2040-х годов, мы не просто увеличим вычислительную мощность нашего мозга. Это событие сделает наше субъективное сознание гораздо более глубоким.
Зомби, квалиа и «трудная проблема сознания»
Фундаментальная особенность сознания состоит в том, что мы не можем поделиться своим субъективным опытом ни с кем другим. Когда мы называем излучение определенной частоты «зеленым» или «красным» цветом, мы понятия не имеем, совпадает ли мое квалиа, то есть мое субъективное восприятие зеленого или красного, с вашим. Вполне может быть, что я вижу зеленый цвет таким, каким вы видите красный, и наоборот. И нет никакого способа напрямую сравнить наши квалиа, будь то посредством языка или другого средства общения10. Более того, даже когда мы сможем физически подключить один мозг к другому, это все равно не позволит нам доказать, что одни и те же сигналы вызывают одинаковые ощущения у меня и у вас. Так что, если мое восприятие красного и зеленого в корне отличается от вашего, мы никогда не узнаем об этом.
Как я уже упоминал в книге «Эволюция разума», это соображение приводит к еще более тревожному мысленному эксперименту: а что было бы, если бы у человека полностью отсутствовало квалиа? Философ Дэвид Чалмерс (род. в 1966 году) назвал такое гипотетическое существо зомби. Это человек, у которого есть все внешние признаки сознания, которые можно обнаружить с помощью неврологических и поведенческих тестов, но при этом полностью отсутствуют внутренние ощущения11. С помощью научного метода мы никогда не сможем отличить зомби от обычного человека.
Чтобы понять разницу между сознанием как функциональной особенностью и субъективным опытом, можно провести мысленный эксперимент. Вообразите обычную собаку и гипотетического искусственного человека, о котором известно, что у него нет субъективного опыта, то есть зомби. Хотя зомби может демонстрировать гораздо более сложное поведение, чем собака, большинство людей согласятся, что причинить боль собаке – в предположении, что у нее есть субъективное сознание – это более дурной поступок, чем ранить зомби, хотя тот может вскрикнуть от боли, которой, как мы знаем, на самом деле не чувствует. Проблема в том, что в реальной жизни у нас даже теоретически нет научного способа определить, имеет ли живое существо субъективный опыт.
Если существование описанных выше зомби хотя бы теоретически возможно, это может означать, что не существует прямой связи между субъективным опытом (квалиа) и физическими системами (будь то мозг или компьютер), которые выполняют обработку информации, создающую видимость сознания. В религиях это интерпретируется как наличие души – сверхъестественной сущности, отделенной от тела. Такие рассуждения выходят за рамки научного подхода. Если же физические системы, участвующие в процессах познания, также порождают и сознание (что делает существование зомби невозможным), у науки также нет способа это доказать. Субъективное сознание не поддается описанию с помощью физических законов, и нельзя гарантировать, что определенные методы обработки информации, основанные на этих законах, приведут к возникновению субъективного опыта. Чалмерс назвал это «трудной проблемой сознания». Он считал, что «легкие проблемы», например, что происходит с нашим разумом во время сна, могут быть одними из самых сложных научных задач, но, по крайней мере, они поддаются научному изучению12.
Чтобы разрешить «трудную проблему», Чалмерс обращается к философской концепции, которую он называет «панпротопсихизм»13. Согласно этой идее, сознание можно рассматривать во многом как еще одну фундаментальную силу во Вселенной, то есть такую, которая не может быть сведена к проявлению других физических сил. Можно представить, что существует своего рода всеобщее поле, которое создает потенциал для возникновения сознания. В моей интерпретации этой гипотезы сложность обработки информации в нашем мозгу «пробуждает» это поле, заставляя его генерировать субъективный опыт, который мы переживаем. Независимо от того, создан ли мозг на основе углерода или кремния, алгоритмы, участвующие в обработке информации и позволяющие ему демонстрировать внешние признаки сознания, также вызывают появление субъективного внутреннего мира.
Хотя мы никогда не сможем доказать это с помощью научного метода, с точки зрения этики мы должны действовать так, как если бы эта гипотеза была верна. Иначе говоря, если есть вероятность, что существо, которому мы можем причинить вред, обладает сознанием, то лучше относиться к нему так, как если бы оно действительно было разумным, чем рисковать возможностью причинить боль живому существу. Фактически это будет означать, что мы считаем существование зомби невозможным.
С точки зрения панпротопсихизма тест Тьюринга не просто подтвердит способность компьютера функционировать на уровне человека, но и предоставит убедительные доказательства того, что у машины есть субъективный опыт. Это, в свою очередь, заставит задуматься о моральных аспектах взаимодействия с ИИ. Появление сознательного ИИ будет иметь серьезные последствия для законодательства. Однако я сомневаюсь, что наша политическая система сможет оперативно отреагировать и обеспечить соблюдение соответствующих прав на законодательном уровне к моменту прохождения компьютером теста Тьюринга. Поэтому сначала ответственность за разработку этических стандартов использования ИИ ляжет на плечи его разработчиков.
Помимо этических оснований полагать, что существо, кажущееся сознательным, таковым и является, существуют еще теоретические причины считать панпротопсихизм достоверным объяснением феномена сознания. Эта гипотеза представляет собой золотую середину между дуализмом и физикализмом (материализмом), которые долгое время являлись двумя ведущими философскими парадигмами. Дуализм утверждает, что сознание порождается некоей сущностью, не имеющей ничего общего с обычной «мертвой» материей. Многие дуалисты называют эту сущность «душой». С научной точки зрения проблема этой версии в том, что, даже если мы предположим существование сверхъестественной души, у нас нет никакого способа узнать, как она взаимодействует с материей в наблюдаемом нами мире, например, с нейронами нашего мозга14. Материализм, напротив, предполагает, что сознание возникает исключительно благодаря особой организации материи в нашем мозге. Даже если эта гипотеза исчерпывающе объяснит функциональные аспекты работы сознания (например, опишет, каким образом работает мозг, подобно тому, как в компьютерных науках разбираются системы ИИ), она никак не поможет нам понять субъективный опыт, который в принципе недоступен для научного исследования. Панпротопсихизм может стать компромиссным решением между двумя этими противоположными подходами.
Детерминизм, эмерджентность и проблема свободы воли
С понятием сознания тесно связан вопрос свободы воли15. Если спросить любого человека на улице, как он понимает эту концепцию, в ответе так или иначе прозвучит мысль, что человек способен контролировать свои действия. Как политическая, так и судебная система основываются на том соображении, что у каждого есть свобода воли примерно в таком смысле.
Однако когда философы попытались дать более точное определение свободе воли, оказалось, что прийти к согласию не так-то просто. Многие мыслители убеждены, что свобода воли возможна только в том случае, если будущее не предопределено16. Ведь если нельзя повлиять на то, что произойдет, откуда тогда возьмется хоть сколько-нибудь значимая свобода воли? С другой стороны, если «свобода воли» сводится лишь к случайным процессам, которые происходят на квантовом уровне и приводят к тем или иным вашим действиям, вряд ли это можно назвать настоящей свободой. Как сказал английский философ Саймон Блэкберн, «случайность столь же неумолимо, как и неотвратимость» исключает возможность свободы воли17. Концепция свободы воли, которая бы нас устроила, должна каким-то образом объединить детерминизм и индетерминизм, избегая полной предсказуемости, но не скатываясь в случайность.
Ученый в области физики и компьютерных наук Стивен Вольфрам (род. 1959) предложил интересный способ разрешения этой дилеммы. Его работы оказали большое влияние на мои размышления о взаимосвязи физики и вычислений. В своей книге «Наука нового типа» (A New Kind of Science, 2002) Вольфрам описал феномен, который сочетает в себе черты детерминизма и индетерминизма – математический объект, известный как клеточный автомат 18.
Клеточный автомат – это простая модель, состоящая из ряда ячеек, каждая из которых может находиться в одном из двух состояний, например, быть белой или черной, живой или мертвой. Эти состояния определяются набором правил, который может быть весьма разнообразным. Правила определяют, каким образом каждая ячейка будет меняться в зависимости от состояния своих соседей. Изменения происходят пошагово, а поведение системы в целом может быть невероятно сложным. Одним из самых известных примеров клеточного автомата стала игра для двумерной доски под названием «Жизнь», предложенная Джоном Конвеем 19. Игрокам и математикам удалось отыскать множество интересных начальных распределений, которые порождают структуры, развивающиеся по правилам игры предсказуемым образом. На основе игры «Жизнь» можно даже построить работающий компьютер и написать программу, которая будет запускать копию самой игры!
В своих рассуждениях Вольфрам обращается к простейшему автомату – одномерной группе ячеек. Каждый новый ряд добавляется снизу, а цвет ячеек в этом ряду определяется набором правил и состоянием ячеек в предыдущем поколении.
Проведя тщательный анализ, Вольфрам обнаружил наборы правил, которые не позволяют заранее предсказать результат никакого шага, если не пройдены все предыдущие шаги20. Это означает, нет никакой возможности перескочить к нужной нам итерации.
Самые простые наборы правил Вольфрам отнес к классу 1. Примером может служить правило 22221:

Существуют восемь возможных состояний ячейки и ее соседей на определенном шаге. Они представлены в верхнем ряду. Правила определяют, какой цвет в зависимости от исходного состояния примет центральная ячейка в следующем поколении (результат изображен в нижнем ряду). Черный и белый цвета можно для удобства обозначить как 1 и 0 соответственно.
Если мы начнем с ряда, в котором единственная черная ячейка расположена в середине, и проследим за эволюцией этой системы шаг за шагом, применяя правило 222, то получим следующую картину22:

Очевидно, что правило 222 порождает очень предсказуемый рисунок. Если вас спросят, какой будет центральная ячейка после миллиона итераций (или даже после миллиона в миллионной степени), вы не задумываясь ответите: черной. Именно так обычно воспринимается «настоящая» наука: как использование непреложных законов для получения предсказуемых результатов.
Однако класс 1 не охватывает все возможные правила. Вольфрам утверждает, что в реальном мире действуют четыре класса правил, которые различаются по степени предсказуемости результатов их применения. Правила классов 2 и 3 уже более интересны и способны порождать все более сложные структуры из черных и белых ячеек. Но по-настоящему захватывающим является класс 4, ярким представителем которого является правило 11023:

Если мы создадим автомат по этому правилу, начиная с одной черной клетки, то через множество поколений он будет выглядеть следующим образом:

Продолжая итерации, мы увидим такие картины24:

Обратите внимание: у нас нет другой возможности узнать, как будет выглядеть ряд под номером тысяча или миллион в миллионной степени, кроме как провести все эти итерации одну за другой25. Это значит, что системы, основанные на правилах из класса 4 – в том числе, как утверждает Вольфрам, наша Вселенная, – имеют степень сложности, которую нельзя объяснить в рамках традиционного детерминизма, то есть они не могут быть сведены к простым правилам. Поведение таких систем запрограммировано, поэтому их сложность детерминирована, но богатство всех возможностей не описывается исходным набором правил.
Статистический анализ каждой ячейки показывает, что распределение состояний является случайным, но мы знаем, что цвет ячейки на каждом шаге полностью определяется предыдущим поколением. В общей картине можно наблюдать как участки хаоса, так и регулярные структуры. Такое свойство систем называется эмерджентностью 26. Оно означает, что простые объекты, взятые в большом количестве, самоорганизовались в гораздо более сложные структуры. Фрактальные структуры в природе, такие как извилистые ветви деревьев, полосатый рисунок шерсти тигров и зебр, раковины моллюсков, и множество других биологических явлений закодированы с помощью правил класса 427. Мы живем в мире, где на каждом шагу встречаются образы, подобные тем, которые возникают при работе клеточных автоматов. Очень простой алгоритм порождает необычайно сложное поведение, балансируя на тонкой грани между порядком и полным хаосом.
Вот один из примеров внутренней сложности, которая может лежать в основе сознания и свободы воли. Независимо от того, благодаря чему возникла программа, отвечающая за вашу свободу воли, – Богу, панпротопсихическому полю или чему-то еще, – вы являетесь чем-то большим, чем просто набор правил.
По мнению Вольфрама, тот факт, что подобные правила могли бы порождать сознание и в то же время множество других природных явлений, не случаен. Вольфрам утверждает, что сами законы физики возникли из вычислительных правил, аналогичных тем, что используются в клеточных автоматах. В 2020 году он объявил о запуске проекта под названием Wolfram Physics Project, поставив цель объяснить законы физики на основе модели, аналогичной клеточным автоматам, но более универсальной28.
Такая теория станет своего рода компромиссом между классическим детерминизмом и квантовым индетерминизмом. Хотя некоторые крупномасштабные аспекты реального мира, например положение спутника после миллиона витков, могут быть с приемлемой точностью предсказаны с помощью алгоритмов, на более глубоком уровне это не сработает. Если в основе реальности на самом фундаментальном уровне лежат правила класса 4, мы сможем объяснить кажущуюся случайность квантовых процессов с точки зрения детерминизма. Однако это все равно не даст нам алгоритма, который позволил бы заглянуть в будущее и точно предсказать состояние Вселенной в любой момент времени29. Пока это лишь предположения, поскольку нам неизвестен полный набор законов. Возможно, в будущем с помощью так называемой «теории всего» мы сможем объединить все эти подходы в единое непротиворечивое объяснение, но пока до этого далеко.
За неимением возможности предвидения остается только одно – создать симуляцию реальности. Однако в нашей Вселенной не получится собрать достаточно мощный компьютер, чтобы запустить модель ее самой. Поэтому единственный способ узнать, что произойдет в будущем, – это дождаться его наступления.
Далее в этой главе мы будем говорить о перспективах переноса сознания из нашего биологического мозга в компьютер. Однако прежде чем перейти к обсуждению этих вопросов, важно кое-что прояснить. Хотя в будущем станет возможно полностью эмулировать работу мозга на компьютере, это не означает, что такой мозг будет запрограммирован в смысле детерминизма. Мозг, будь то биологический или электронный, не является замкнутой системой. Он постоянно получает информацию из окружающего мира и обрабатывает ее с помощью невероятно сложных сетей нейронов. Недавно ученые обнаружили в человеческом мозге нейронные сети, которые имеют структуру из 11 измерений30! Такая сложная система, вероятно, работает по принципу правил типа 110-го, так что результат ее работы невозможно предсказать заранее, не пройдя все шаги один за другим. Поскольку мозг открыт для внешних сигналов, учесть их заранее в пошаговой симуляции также не представляется возможным. Поэтому умение воспроизвести работу мозга не влечет за собой способности предвидеть его будущие состояния. Возможно, именно это позволяет Вселенной существовать.
Иначе говоря, если законы Вселенной похожи на правила клеточных автоматов, единственный способ увидеть, как они работают, – это наблюдать за их действием в реальном времени, то есть по мере развития событий. С другой стороны, если бы в основе мироздания лежали детерминированные правила, которые не приводят к явлениям, подобным тем, что происходят в клеточных автоматах, или если бы Вселенная работала на основе случайности, возможно, для ее воплощения в реальности вовсе не требовалось бы пошаговое выполнение. Более того, если сознание может возникнуть только в условиях сочетания порядка и хаоса, как в автоматах класса 4, это вполне может оказаться причиной нашего существования. В других обстоятельствах нас бы просто не было, и такими вопросами никто бы не задавался.
Таким образом, мы приходим к компатибилизму – убеждению, что даже в детерминированном мире существует свобода воли31. Мы способны принимать решения самостоятельно, то есть не находясь под влиянием чего бы то ни было, в том числе другого человека, пусть даже наши решения и определяются действующими во Вселенной законами. В детерминированном мире теоретически можно заглянуть как в прошлое, так и в будущее, поскольку все события строго предопределены. Однако в случае набора правил, подобных 110-му, единственный способ узнать будущее – это посмотреть, как будут разворачиваться события. Получается, с точки зрения панпротопсихизма процессы самоорганизации в нашем мозге не управляют нами; они и есть «мы». Мы существуем благодаря глубинным законам, но наш выбор заранее не известен, так что у нас есть свобода воли, пока процессы, порождающие наше сознание, могут проявляться в окружающем мире посредством наших поступков32.
Вопрос свободы воли в случае наличия у человека более чем одного мозга
Если обратить внимание на то, как люди изображают андроидов в книгах и кинофильмах, можно убедиться, что мы, по сути, воспринимаем их так, как панпротопсихисты. То есть если поведение ИИ напоминает человеческое, то даже при том, что он мыслит не с помощью биологических нейронов, мы переживаем за него так, как будто он обладает сознанием в смысле наличия у него субъективного опыта.
Исследования показывают, что, подобно тому, как ИИ может состоять из набора отдельных алгоритмов, человеческий мозг тоже поделен на несколько отдельных модулей, способных принимать решения. Многочисленные эксперименты над нашими двумя полушариями демонстрируют их относительную равноценность и независимость33. Исследователи Стелла де Боде и Сьюзан Кертис изучили 49 детей, которые перенесли операцию по удалению одного из полушарий для устранения жизнеугрожающего эпилептического расстройства34. Большинство из этих детей смогли вернуться к обычной жизни, и даже те, кто не смог полностью избавиться от заболевания, были практически полноценными личностями. Хотя обработкой речи обычно занимается левое полушарие, оба полушария функционально эквивалентны, и человек способен овладеть речью, даже если у него осталась только одна половина мозга35.
Возможно, наиболее впечатляющие результаты были получены при изучении мозга, левое и правое полушария которого оставались сохранены, но пучок из 200 миллионов аксонов36, известный как мозолистое тело, был рассечен хирургическим путем. Такие случаи, когда у пациента две полусферы мозга сохранили работоспособность, но потеряли возможность непосредственного общения, исследовал Майкл Газзанига (род. в 1939 г.)37. В ряде экспериментов он продемонстрировал, что если правому полушарию показать некоторое слово, то левое, которое ничего об этом слове не знало, тем не менее брало на себя ответственность за решения, принятые на основе полученной информации, хотя непосредственный выбор делало правое полушарие38. Это значит, что левая часть мозга прибегала к конфабуляции, то есть выдумывала правдоподобные объяснения, почему она могла принять такое решение. По всей видимости, ни одна из частей мозга не была в курсе существования своего соседа по черепной коробке39.
Эти и другие эксперименты с полушариями мозга свидетельствуют, что у обычного человека фактически есть два мозга, способных принимать независимые решения. Тем не менее сознание у нас одно. Каждый из этих мозгов уверен, что решения принимает именно он, а из-за их тесной взаимосвязи ни у одного из них не возникает подозрения в обратном.
Если абстрагироваться от двух полушарий мозга, можно предположить, что у нас есть и другие центры принятия решений, которые также могут обладать свободой воли в том смысле, который мы обсуждали ранее. Например, новая кора, в которой формируются решения, состоит из множества более мелких модулей40. Это может означать, что, когда мы обдумываем решение, разные модули представляют различные варианты и каждый из них стремится отстоять свою точку зрения. Мой учитель Марвин Минский утверждал, что мозг представляет собой не единый командный пункт, а сложную сеть, отдельные части которой могут поддерживать разные варианты, пока мы находимся в раздумьях. Минский называл наш мозг «обществом разума» (так он назвал свою вторую книгу), в котором различные более простые процессы отражают разные точки зрения41. Но делает ли каждая из частей свободный выбор? Как мы можем в этом убедиться? В последние десятилетия были проведены эксперименты, подтверждающие эту идею. Однако пока наше понимание того, каким образом отдельные процессы приводят к конкретным решениям, которые мы воспринимаем как свои собственные, остается ограниченным.
«Вы-2» обладает сознанием. можно ли считать его вами?
Возникает интересный вопрос. Если единое сознание и личность могут базироваться на нескольких различных, обрабатывающих информацию структурах внутри нашего черепа – в том числе когда те физически разделены, – то что произойдет, если эти структуры окажутся еще и на некотором расстоянии друг от друга?
Один из ключевых вопросов, рассмотренных мной в книге «Эволюция разума», касается философских и моральных последствий создания копии всей информации, содержащейся в мозге человека. Это станет возможным в течение жизни большинства наших современников.
Допустим, я воспользуюсь продвинутой технологией и подробно исследую каждую область вашего мозга, а затем создам ее точную электронную копию. (Сегодня мы уже можем создавать упрощенные копии некоторых специфических областей мозга, например, для борьбы с тремором при болезни Паркинсона 42.) Сам по себе этот участок слишком мал, чтобы породить сознание. Но затем я скопирую еще один, и еще, и еще. В конце концов у меня на руках будет полная цифровая копия вашего мозга со всей информацией, и она сможет функционировать в точности как ваш мозг.
Будет ли «Вы-2» обладать сознанием? «Вы-2» будет утверждать, что пережил все то же самое, что и вы (поскольку у вас с ним общие воспоминания), и будет вести себя в точности как вы. Поэтому, если только мы в принципе не откажем электронным копиям сознательных существ в возможности самим иметь сознание, нам придется ответить утвердительно. Другими словами, если электронный мозг обладает той же информацией, что и биологический, и заявляет, что обладает сознанием, у нас нет научных оснований ему не верить. С точки зрения этики мы будем обязаны относиться к нему как к сознательному существу и признать, что в отношении него действуют законы морали. И это не пустое размышление, поскольку панпротопсихизм предоставляет нам философское обоснование, почему нам следует считать это существо сознательным.
Но есть и более трудный вопрос: можно ли считать «Вы-2» вами? Нужно учесть, что «Вы-1» (то есть обычный человек) все еще существует. Можно даже предположить, что ваша копия была создана без вашего ведома, но, независимо от этого, ваше существование не прерывалось. Если эксперимент удался, «Вы-2» будет совершать поступки, которые совершили бы вы, но вы сами останетесь таким же, каким и были, так что «Вы-1» – это и будете вы. Поскольку «Вы-2» может действовать независимо от вас, он сразу же станет отличаться от вас, создавая собственные воспоминания и получая другой опыт. Так что, раз ваша личность представляет собой уникальную информационную структуру в вашем мозге, «Вы-2», даже обладая сознанием, все же не будет вами.
Хорошо, перейдем к другому эксперименту. На этот раз мы будем постепенно заменять отдельные участки вашего мозга их электронными копиями, подключая их к оставшимся нейронам через специальный интерфейс мозг-компьютер наподобие тех, что были описаны в прошлой главе. Так что вместо «Вы-1» и «Вы-2» остаетесь только «Вы». После каждой фазы эксперимента вы чувствуете себя отлично и никто другой не замечает проблем. Можно ли сказать, что после каждого этапа «Вы» остаетесь вами? А в конце, когда весь ваш мозг станет цифровым?
Вопрос о том, остается ли объект тем же самым при замене отдельных частей, восходит к древнему спору философов о корабле Тесея 43. Две с половиной тысячи лет назад греческие мыслители задумались о деревянном судне, доски которого одна за другой меняются на новые по мере износа. Кажется очевидным, что после замены одной из досок корабль все еще можно считать тем же самым. В его конструкции кое-что поменялось, но все же мы говорим о починке старого корабля, а не о строительстве нового. Но что, если больше половины досок заменены на новые? Или когда все доски свежие, а старых, оставшихся со времен постройки корабля, вообще не осталось? Это случай уже сложнее, но многие все равно скажут, что, в принципе, корабль остался тем же, несмотря на постепенную замену частей. А теперь представьте, что каждый раз при замене доски старую относили на склад. После того как все элементы корабля были заменены, мы вновь собираем корабль из старых частей со склада. Какой из кораблей настоящий? Тот, который имеет с исходным непрерывную связь через постепенные модификации, но состоит из новых материалов? Или вновь собранный из оригинальных запчастей?
Корабль Тесея кажется просто забавным парадоксом, когда мысленный эксперимент касается судна или любого неживого объекта, то есть когда ставки не слишком высоки. Вопрос идентичности корабля оригиналу касается только нашей прихоти. Но задача становится необычайно серьезной, когда речь заходит о человеке. Каждому из нас абсолютно не все равно, находится рядом действительно близкий человек или Чалмерсов зомби, умело создающий нужное впечатление.
Давайте посмотрим на эту ситуацию с точки зрения «трудной проблемы сознания». В случае, когда мы создали «Вы-2» как вашего двойника, невозможно определить, будет ли субъективное сознание «Вы-2» иметь что-либо общее с вашим. Будет ли ваш субъективный опыт отныне каким-то образом охватывать обе копии вашего существа, даже при том, что информационное наполнение их мозгов будет со временем все сильнее различаться из-за разного опыта? Или «Вы-2» станет полностью самостоятельным существом? У науки нет способа ответить на этот вопрос.
В то же время в сценарии, в котором мы постепенно переносим информацию из вашего мозга на небиологический носитель, у нас куда больше оснований полагать, что ваше субъективное сознание сохранится. Как я уже упоминал, в очень ограниченном виде, но мы уже делаем что-то подобное при лечении определенных заболеваний, причем нейропротез обладает большими возможностями, чем тот участок мозга, который он заменяет. Поэтому он не совсем идентичен оригинальной части. Первые протезы, в частности кохлеарные импланты, могли стимулировать мозговую активность, но не заменяли собой основные структуры мозга44. Однако с начала 2000-х годов ученые разрабатывают мозговые импланты, способные помочь людям со структурными повреждениями или некорректно работающими участками внутри мозга. Например, искусственные устройства уже берут на себя часть работы гиппокампа у людей с нарушениями памяти45. В 2023 году эти технологии все еще находятся на начальной стадии развития, но в ближайшее десятилетие мы станем свидетелями того, как они будут становиться все более совершенными и доступными широкому кругу пациентов. При существующих технологиях, по крайней мере, нет никаких сомнений, что личность человека сохраняется, и никто не скажет, что он похож на зомби, о которых говорил Чалмерс.
Весь наш опыт в области нейробиологии подсказывает, что при постепенной замене участков мозга вы даже не заметите разницы, к тому же мозг великолепно адаптируется. Ваш гибридный мозг сохранит все информационные образы, которые определяют вашу личность. Поэтому нет причин опасаться, что ваше субъективное сознание пострадает, и вы, безусловно, останетесь самим собой – единственным и неповторимым. Однако в результате этого гипотетического процесса вы превратитесь в точности в «Вы-2», который, как мы ранее решили, не является вами. Как разрешить это противоречие? Все дело в непрерывности: цифровой мозг не расходится с биологическим, так как ни в один момент времени они не существуют как отдельные объекты.
Рассмотрим теперь третий, уже не гипотетический сценарий. Каждый день в нашем организме происходит замена отмирающих клеток на новые. Хотя нейрон живет относительно долго, в течение месяца обновляется около половины его митохондрий46; период полураспада микротрубочек составляет несколько дней47; запасы белков, обеспечивающих энергией синапсы, восполняются в течение 2–5 дней48; NMDA-рецепторы в синапсах замещаются в течение нескольких часов49; микрофиламенты в дендритах распадаются за 40 секунд50. Получается, каждые несколько месяцев наш мозг почти полностью обновляется, так что, по сути, вы становитесь биологической версией «Вы-2», если сравнивать с вами же более раннего образца. И снова ваша личность сохраняется благодаря информации и непрерывности функционирования, а не какой-то особой структуре или материалу.
Годами я любуюсь красивейшей рекой Чарльз, которая протекает неподалеку от моего дома. Каждый раз, когда я смотрю на реку, она кажется мне такой же, как вчера или даже десять лет назад, когда я упоминал о ней в книге «Эволюция разума». Так происходит потому, что, хотя через заданное течение русла проходят новые молекулы воды каждые несколько миллисекунд, они следуют общей траектории, которая и определяет течение реки. То же самое происходит в нашем мозге. Когда мы будем внедрять в наше тело и мозг небиологические модули, непрерывность наших мыслительных образов будет поддерживаться. Мы продолжим чувствовать себя самими собой, разве что наше восприятие станет острее, а сообразительность вырастет.
Разумеется, та же технология, благодаря которой мы сможем перенести все навыки, воспоминания и личность человека на цифровой носитель, также позволит создать множество копий этой информации. Эта суперспособность из цифрового мира – создавать произвольное количество копий самого себя – не имеет аналогов в живой природе. Резервное копирование информации из нашего мозга в удаленный репозиторий станет надежной защитой от несчастных случаев и болезней, которые могут повредить наш мозг. Это еще не бессмертие, поскольку нельзя считать вечными электронные таблицы, сохраненные в облаке, – аварии, уничтожающие все данные, случаются и в дата-центрах. Но эта мера поможет нам избежать трагических случайностей, которые уносят так много жизней. А мое понимание панпротопсихизма предполагает, что ваше субъективное сознание каким-то образом охватит все копии определяющей вашу личность информации.
У этой интерпретации есть еще одно интересное следствие. Если отпустить «Вы-2» гулять по свету, предоставив ему полную свободу действий, то информационная структура, формирующая его личность, отделится. Однако, поскольку этот процесс будет происходить постепенно и непрерывно, существует вероятность, что ваше субъективное сознание будет работать с двумя структурами одновременно. Я подозреваю, основываясь на теории панпротопсихизма, что наше субъективное сознание связано с базовой уникальной информационной структурой и поэтому каким-то образом будет охватывать все копии этой структуры, которые изначально были идентичны нашей собственной.
Однако, поскольку не исключено, что даже в этом случае «Вы-2» будет настаивать, что имеет отдельное от вас субъективное сознание (так как физические структуры, принимающие решения и отвечающие за коммуникацию, будут различными), и установить истину будет невозможно, с точки зрения права и этики придется рассматривать вас как отдельных личностей.
Ваше существование – редчайшая удача
Рассуждая о том, кто мы такие, стоит задуматься об удивительной цепочке крайне маловероятных событий, которая привела к появлению на свет каждого из нас. Мало того, что ваши родители должны были встретиться и принять решение о рождении ребенка, вероятность чего весьма сложно оценить, так еще и определенный сперматозоид должен был оплодотворить конкретную яйцеклетку, чтобы в результате появились именно вы. Вероятность такого события составляла примерно один шанс из двух квинтиллионов. В среднем мужчина за свою жизнь производит порядка двух триллионов сперматозоидов, а женщина от рождения имеет около миллиона яйцеклеток51. В предположении, что вашу будущую личность определяет конкретный набор из двух половых клеток, мы получаем именно такую оценку вероятности вашего существования. Конечно, не все половые клетки содержат уникальный генетический набор, однако мы также не учли влияние эпигенетики. Например, два сперматозоида с абсолютно одинаковым хромосомным набором, произведенные мужчиной в 25 и 45 лет соответственно, внесут неодинаковый вклад в формирование черт будущего ребенка52. Так что мы не сильно ошибемся, если будем считать все сперматозоиды и яйцеклетки уникальными. Аналогичные соображения справедливы для ваших предков по материнской и отцовской линиям. С каждой стороны есть бабушка и дедушка, две прабабушки и два прадедушки, четыре прапрабабушки и четыре прапрадедушки, и так далее – конечно, не до бесконечности, но нужно учесть всех предков с момента зарождения жизни на земле около четырех миллиардов лет назад53.
Число, состоящее из единицы и ста нулей, называется «гугол» (именно от этого слова образовано название всемирно известной поисковой системы в интернете). Если возвести число 10 в степень гугол, получится гуголплекс – невообразимо большое число. Так вот, рассуждения из предыдущего абзаца (более детально описанные в заметках) приводят нас к выводу, что вероятность вашего существования можно получить, разделив единицу на число, состоящее из единицы с гораздо большим количеством нулей, чем гуголплекс54. При всем при этом вы здесь с нами. Разве это не настоящее чудо?
Кроме того, само возникновение Вселенной, способной поддерживать обработку информации, является в еще большей степени исключительным событием. Наш уровень понимания физики и космологии позволяет утверждать, что небольшое изменение законов физики привело бы к невозможности существования жизни во Вселенной55. Иначе говоря, из всех конфигураций, которые могла бы иметь наша Вселенная, только очень ограниченный набор допускает наше существование. Если перечислить факторы, от которых зависит возможность существования жизни во Вселенной, и оценить, насколько соответствующие значения должны были бы отличаться от реальных, чтобы сделать зарождение жизни невозможным, то можно получить представление о том, насколько маловероятным было наше появление.
Согласно Стандартной модели, существуют 37 видов элементарных частиц, различающихся массой, зарядом и спином. Эти частицы взаимодействуют друг с другом с помощью четырех фундаментальных сил: гравитационной, электромагнитной, сильной и слабой ядерных сил. Некоторые ученые убеждены в существовании гравитонов, которые, как предполагается, отвечают за гравитационные эффекты56. Воздействие упомянутых сил на частицы характеризуется набором постоянных величин, которые и определяют физические законы. Ученые выявили множество причин, по которым даже крайне малые изменения определяющих констант сделали бы невозможным формирование разумной жизни, которая требует для своего наличия сложных химических соединений, источников энергии достаточной мощности, а также сравнительно неизменных условий окружающей среды на протяжении сотен миллионов лет эволюции. В настоящее время господствующей теорией возникновения жизни является гипотеза абиогенеза 57. В соответствии с этой теорией неживая материя в «первичном бульоне» самоорганизовалась из соединений-предшественников в сложные строительные блоки белков, способных поддерживать жизнь. В конце концов белки спонтанно образовали структуру, способную самовоспроизводиться, положив тем самым начало жизни. Если бы этот процесс прервался на любом из этапов, человечество никогда бы не появилось.
Если бы сильное ядерное взаимодействие было сильнее или слабее, в звездах не смогли бы образоваться углерод и кислород – важнейшие для жизни химические элементы58. Аналогично слабое взаимодействие по величине лишь немного превышает минимальное значение, необходимое для эволюции жизни59. Если бы оно недотягивало до этого минимума, весь водород очень быстро превратился бы в гелий и звезды, подобные нашему Солнцу, не могли бы существовать и гореть достаточно долго, чтобы в их звездных системах успела возникнуть жизнь.
Если бы разница в массе между верхним и нижним кварками была немного больше или меньше, они не смогли бы образовать долгоживущие протоны и нейтроны, незаменимые строительные блоки для сложной материи60. К такому же результату привело бы небольшое увеличение массы электрона относительно указанной разницы61. По словам физика Крэйга Хогана, «изменение разницы масс кварков на несколько процентов в любую сторону» сделало бы жизнь невозможной62. Если бы разница была чуть больше, получилась бы вселенная протонов, наполненная атомами водорода63; чуть меньше – мир нейтронов, в котором существуют ядра атомов, но нет электронов и, как следствие, химических процессов64.
Если бы гравитация была немного слабее, Вселенная лишилась бы сверхновых звезд – источника тяжелых химических элементов, из которых состоит жизнь65. При большей гравитации жизненный цикл звезд стал бы значительно короче, не позволяя эволюции сделать свою работу66. В течение секунды после Большого взрыва параметр плотности (известный как Ω – «омега») не должен был отличаться от действительного более чем на одну квадрилионную долю, иначе жизнь была бы невозможна67. Если бы его значение было немного выше, то материя, рассеянная в результате Большого взрыва, снова сжалась бы под действием гравитации еще до того, как могли бы образоваться звезды. А если бы он был чуть меньше, расширение происходило бы настолько быстро, что звезды не успели бы сформироваться.
Кроме того, макроструктура Вселенной обусловлена небольшими локальными колебаниями плотности расширявшегося вещества в первое мгновение после Большого взрыва68. В любой точке ее значение в среднем отличалось от общей плотности примерно на одну стотысячную69. Если бы амплитуда колебаний плотности (которую часто описывают как рябь на поверхности пруда) была на порядок больше или меньше, жизнь тоже была бы невозможна. По словам космолога Мартина Риса, если бы пульсации были слишком малы, «газ вообще никогда не сконденсировался бы в гравитационно-связанные структуры, и такая вселенная навсегда осталась бы темной и однородной»70. Напротив, если бы рябь была слишком большой, Вселенная погрузилась бы в «космический ураган», большая часть вещества превратилась бы в огромные черные дыры, а у звезд не было бы шансов «сохранить стабильные планетные системы»71.
Чтобы образовалась упорядоченная материя вместо хаотического бульона, сразу после Большого взрыва энтропия Вселенной также должна была быть очень низкой. Физик Роджер Пенроуз, основываясь на наших представлениях об энтропии и случайности, утверждает, что только одна из 1010123 возможных вселенных может иметь энтропию настолько низкую, чтобы принять форму, подобную нашей Вселенной72. Это число содержит нулей больше, чем атомов в известной части Вселенной (которых, по разным оценкам, может быть от 1078 до 1082). Если считать, что их 1080, то количество нулей в 1010123 на сорок три порядка больше, то есть в десять миллионов миллиардов миллиардов миллиардов миллиардов миллиардов миллиардов раз73.
Можно подвергнуть сомнению каждое из этих соображений, и не все ученые согласны с выводами о влиянии каждого отдельного фактора. Однако нет смысла рассматривать эти параметры по отдельности. Скорее, как отмечает физик Люк Барнс, нужно изучать «пересечение допустимых значений, а не объединение» (в математическом смысле)74. Иначе говоря, если мы хотим, чтобы жизнь появилась, каждый из факторов должен принять значение, способствующее этому. Всего лишь один промах делает жизнь невозможной. Как остроумно заметил астроном Хью Росс, поверить, что все эти параметры получили необходимые значения по воле случая, так же трудно, как и в то, что «от налетевшего урагана на свалке случайно образовался “Боинг-747”»75.
Нам кажется, что параметры Вселенной будто специально подобраны, чтобы мы могли появиться на свет. Это ощущение можно объяснить так называемой «ошибкой выжившего»76. Речь о том, что, если бы фундаментальные константы были другими, некому было бы задаваться всеми этими вопросами: чтобы оценить вероятность существования такой тщательно настроенной Вселенной, мы должны сначала в ней оказаться. Такое рассуждение носит название «антропного принципа», и ряд ученых считает предлагаемое им объяснение удовлетворительным. Однако если мы уверены, что реальность существует независимо от наличия наблюдателя в лице человека, такой ответ нас не устроит. Мартин Рис предлагает посмотреть на проблему с другой стороны: «Представьте, что вас поставили к стене для расстрела, но все стрелки промахнулись. Вы можете, конечно, сказать: “Ну, если бы кто-то из них попал, рассуждать об этом было бы некому”. Но ведь это все равно удивительный факт, и хорошо бы найти ему объяснение»77.
Bepul matn qismi tugad.
