Kitobni o'qish: «ИИ в бизнесе: сценарии внедрения. План на ближайшие 90 дней: практическое руководство»
Вступление от авторов
Эта книга родилась из разговора, который раз за разом повторялся у нас с коллегами, партнёрами, слушателями программ MBA и ДПО: «Про ИИ говорят из каждого утюга, мы даже уже что-то попробовали сами, но до сих пор не до конца понятно — как ИИ эффективно использовать в моём бизнесе?»
И за этим вопросом, судя по всему, стоит уже не столько профессиональное любопытство, сколько серьёзная усталость. Сотни презентаций и роликов на онлайн-платформах просмотрены, все курсы пройдены и сертификаты получены, тестовый чат-бот или агент уже где-то запущен, бюджет потрачен, а то и перерасходован, — а внятного экономического эффекта не видно. Или как его правильно оценить? И в любом случае — что со всем этим делать дальше?
Нам особенно запомнилась аналогия, которую привёл один из слушателей программы ДПО. Он сравнил внедрение ИИ в своём бизнесе с дрессировкой любимой собаки:
«Вот я сижу на курсе, слушаю и вижу, что у других собаки могут бегать, прыгать, приносить палочку — столько всего умеют. А моя сидит рядом и ничего этого не может. Она хорошая, я её очень люблю, забочусь о ней. Но от этого она не начинает приносить мне палочку… После модуля я чётко осознал, что моя собака тоже так сможет — её точно можно всему научить. Но пока она по-прежнему сидит рядом и ничего этого не делает. Так с чего начать? И что делать дальше?»
Он не сомневается в том, что дрессированные собаки умеют приносить палочку, — это он уже видел. Он задаётся вопросом, как научить свою. А дрессировка — дело сугубо практическое: с какой команды начать, как понять, что команда усвоена, когда хвалить, а когда менять подход. Смотреть на чужих собак на площадке тут уже мало.
С ИИ в бизнесе ровно то же самое. Чужих успехов вокруг хватает, а методики для своей компании нет: с какого процесса начать, как измерить результат, когда масштабировать, а когда вовремя остановиться. Поэтому мы писали не обзор возможностей ИИ, а практическое руководство — для руководителя или собственника бизнеса, занятого, ответственного за результат и совершенно не обязанного разбираться в технической архитектуре языковых моделей. Чтобы он мог быстро, почти как в справочнике, найти то, что нужно для решения: какой результат реально получить, как его измерить и где у ИИ-проекта конечная точка.
Зачем нужна ещё одна книга об ИИ
Литературы об искусственном интеллекте уже достаточно много, но практически вся она умещается в два основных направления.
Первое — это популярные книги о будущем и ИИ: интересно читать, но невозможно применить на практике.
Второе — «техническая литература» для разработчиков ИИ: применимо, но сложно для восприятия того, кто принимает решение о бюджете или отвечает за развитие бизнеса.
А вот между этими направлениями — почти пусто. Но ведь управленческое решение принимается как раз в этом промежутке: какой процесс взять первым, сколько это стоит, что потребуется от внутренних служб компании (ИТ, юристы и т. д.), а главное — как понять спустя 3 месяца, что есть эффект от внедрения и как его оценить.
Вот именно эту «пустоту» мы и пытаемся заполнить своей книгой.
Что в этой книге есть
Мы старались максимально убрать из книги всё лишнее. Книга устроена как понятный навигатор по знаниям, а не как нудное повествование. Каждая глава отвечает на пять ключевых вопросов: где ИИ создаёт ценность (в отдельной функции бизнеса или для всей отрасли), какие решения реально внедрить за тот бюджет, который есть, и какой эффект ожидать, а также как его измерить, и с чего же начать в ближайшие 90 дней.
Главы о функциях и отраслях (части I–III) построены по одинаковой схеме, а главы о малом бизнесе и практике внедрения (части IV и V) написаны свободнее — вокруг вопросов, которые чаще всего задаёт себе собственник бизнеса. Поэтому книгу не обязательно читать подряд. Руководитель отеля может открыть главу о гостиницах и сервисе, коммерческий директор — главу о продажах, а владелец компании без собственного ИТ-отдела — часть о малом и среднем бизнесе. Методологические главы — о выборе первого проекта, данных, технологии, подрядчике, пилоте, экономике и рисках — будут одинаково полезны всем, независимо от роли в компании или отрасли.
В конце книги мы приводим шаблоны: карта возможностей, паспорт пилота, матрица выбора поставщика, оценка рисков, расчёт эффекта, регламент работы сотрудников с генеративным ИИ, ИИ-стратегия на одну страницу, служебная записка на запуск пилота, чек-лист контроля качества контента и карточка встречи. Их можно взять за основу для своих документов.
Чего точно не будет в этой книге?
В ней не будет истории искусственного интеллекта, объяснения устройства и работы нейронных сетей или прогнозов о том, каким станет мир через десять или двадцать лет. В ней также нет места рассуждениям о том, поработит ли искусственный интеллект человечество и когда это произойдёт.
Ещё в ней нет пустых обещаний. Мы старались не приводить ни одного процесса или цифры без указания источника данных и условий применимости. Там, где убедительных данных нет, мы прямо это говорим. Это скучнее, чем эффектные проценты роста, которые мы часто видим в презентациях, но намного полезнее для тех, кто будет запускать свой проект и тратить реальный бюджет.
И ещё одно: мы не утверждаем, что ИИ заменит людей, и не рассуждаем о том, как он это сделает. Мы описываем другое — как любой сотрудник, будь он директор или менеджер, может отдать ИИ часть своей работы: черновики, поиск и расшифровку информации, классификацию, сверку данных. А ответственность за конечное решение всегда остаётся у человека — и уж тем более в жёстко регулируемых отраслях (медицина, юриспруденция и др.).
Как лучше читать эту книгу
Чтобы сэкономить ваше время, мы предлагаем три практических совета для чтения:
Первый: начните с главы о выборе первого проекта. Она задаёт способ мышления, который используется дальше во всей книге.
Второй: читайте книгу, держа свой конкретный бизнес-процесс в голове. Абстрактный вопрос «что нам дал бы ИИ» не имеет правильного ответа. Вопрос «что даст ИИ в обработке наших 12 000 обращений в месяц» — имеет.
Третий: не переносите цифры из книги напрямую на свою компанию. Любая приведённая нами величина — это ориентир из чужого контекста. Ваш базовый уровень измеряется до пилота, только на ваших данных, и только он даёт право говорить об эффекте в конце.
Для собственника компании без своего ИТ-отдела мы рекомендуем короткий маршрут: главы 1–2, затем часть IV (главы 17–19), затем главы 20, 24, 26, 28 и 29. Остальные главы — справочник по вашей функции или отрасли: их удобно открывать, когда дойдёт дело до конкретного процесса.
Насколько можно доверять цифрам: шкала доказательности
Цифры в книге взяты из источников разного качества, и мы не хотим, чтобы вы читали отчёт вендора так же, как контролируемый эксперимент (правда сказать, таких ещё относительно немного). Поэтому в заголовке каждого кейса стоят две пометки: уровень доказательности и масштаб компании — например, «Кейс 12 · B · крупный бизнес».
A — исследование с контрольной группой или раскрытой методикой, судебное решение, документ регулятора. На такие цифры можно опираться как на ориентир.
B — названная компания сама публично раскрыла цифры о своём внедрении (отчёт, доклад, пресс-релиз, корпоративный блог), или событие описано независимыми СМИ. Цифры есть, методика замера не раскрыта или не проверена.
C — материал поставщика, интегратора или консультанта; кейс без названия клиента; самоотчёт без методики; неопубликованные данные партнёра книги. Сюда же мы отнесли собственные кейсы авторов: мы знаем их изнутри, но вы не можете проверить наши цифры, и просить верить на слово было бы нечестно.
Правило применения простое: в бизнес-кейс для своей компании переносятся только ориентиры уровня A, и то как гипотеза для пилота. Всё остальное — повод задать вопросы, а не готовые цифры для плана.
Кейсом мы называем только реальное внедрение или событие в конкретной организации. Модельные расчёты, опросы и типовые конфигурации подписаны как таковые и в счёт кейсов не входят. Если компания не раскрыла результатов в цифрах, в кейсе это сказано прямо. Масштаб определён по выручке, как в российских критериях МСП: малый бизнес — до 800 млн, средний — до 2 млрд, крупный — больше; для зарубежных компаний — по сопоставимому масштабу; вузы и другие некоммерческие организации помечены как «крупная организация». Полный реестр кейсов с уровнем, масштабом, классом проекта (глава 20) и источником — в Приложении Г.Срок годности данных
Срок годности данных
Технологии в этой области меняются быстрее, чем выходят книги. Цены на вычисления падают, модели обновляются, регулирование вводится поэтапно и по-разному.
Поэтому в книге разделены два слоя. Первый — методология: как выбирать процесс, считать эффект, организовывать пилот, управлять рисками. Она устойчива. Второй — конкретные названия сервисов, тарифы и сроки регулирования. Они приведены с датой и ссылкой, и их актуальность следует перепроверять на момент чтения книги. Все правовые положения всегда требуют согласования с юристом применительно к вашей конкретной ситуации: книга не является юридической консультацией.
Как при подготовке книги использовался ИИ
Рукопись готовилась с использованием генеративных языковых моделей (Perplexity, Claude от Anthropic, Gemini от Google), и мы обязаны об этом сказать. ИИ помогал нам в поиске и предварительном отборе источников, подготовке черновиков отдельных фрагментов текста, таблиц и формулировок, а также в редактуре и проверке внутренней согласованности глав.
Тем не менее все факты, цифры и ссылки, приведённые в книге, мы проверили самостоятельно; окончательные формулировки, выводы и рекомендации — наша авторская ответственность.
Мы придерживаемся здесь того же принципа, который рекомендуем в этой книге бизнесу: ИИ — инструмент, а автор и ответственный за результат — только человек.
Благодарность партнёру
Отдельная благодарность — компании GPTunneL, платформе для корпоративного использования генеративного ИИ. Обезличенные данные о кейсах внедрения ИИ в малом и среднем бизнесе (глава 17) предоставлены GPTunneL как партнёром проекта; эти материалы не публиковались ранее и приведены в книге с оговорками о методике расчёта.
Благодарность читателю
Если после прочтения нашей книги вы выберете хотя бы один свой бизнес-процесс, измерите его текущее состояние и запустите один пилот с понятным критерием успеха — книга сделала свою работу. Всё в ней написано только ради того, чтобы вы, наш дорогой читатель, сделали этот шаг. И тогда наш труд был не напрасен, а ваше время потрачено не зря.
Об авторах
Андрей Ветлужский
Андрей Ветлужский — директор Центра цифровых образовательных технологий Высшей школы бизнеса НИУ ВШЭ, сооснователь платформы СВОД (svodx.ru).
Более 20 лет в ИТ и управлении с фокусом на бизнес-результат. Руководит ИИ-проектами: цифровые аватары, чат-боты поддержки, локальные модели для обучения, ИИ-агенты для поиска и сбора лидов. До этого работал на стороне бизнеса — в медицине, ИТ-консалтинге, FMCG и финансах.
Николай Соколов
Николай Соколов — руководитель проектов по ИИ-трансформации и цифровым продуктам (AI PM), AI-инженер Центра цифровых образовательных технологий Высшей школы бизнеса НИУ ВШЭ, сооснователь платформы СВОД (svodx.ru).
Часть I. ИИ как инструмент результата
Вокруг ИИ сегодня множество мифов, и несколько из них особенно живучи. Одни видят в нём технологическую сенсацию, которая вот-вот полностью всё изменит, другие — набор сложных инструментов «исключительно для айтишников». Но эти мифы не дают сформулировать главный вопрос: даст ли ИИ понятный и измеримый результат в моей компании?
Поэтому мы сознательно не строим книгу вокруг сравнения моделей, платформ и вендоров и не рассуждаем о цифровой экономике. Для бизнеса важны абсолютно приземлённые вещи — выручка, издержки, скорость процессов, качество сервиса и решений. Технология, которая не встраивается в эту логику, остаётся красивой демонстрацией возможностей (помните про дрессированную собачку?), и не более того.
ИИ для нас — инструмент результата. Он помогает писать тексты, разбирать документы, прогнозировать спрос, снимать рутину и готовить решения. Но оценивать мы с вами его должны только по одному признаку: насколько объективно улучшился реальный процесс и можно ли этот эффект повторить.
В этом ключе построена вся книга. Сначала — где ИИ создаёт ценность в функциях и отраслях бизнеса, затем — в чем особенности малого и среднего бизнеса, и, наконец, как пройти путь от первого замера до результата, который признает финансовый директор или собственник компании.
Глава 1. Что в этой книге понимается под ИИ
Коротко о главе
· Под словом «ИИ» скрываются пять технологий с разной ценой и риском: машинное обучение, генеративные модели, компьютерное зрение, речь и агенты.
· Выбирать нужно не «ИИ вообще», а уровень автоматизации: классификация, черновик для сотрудника или автономный ответ.
· Любой проект начинается с данных и ответа на вопрос, где результат проверяет человек.
Когда на совещании звучит «давайте внедрим ИИ», каждый, как правило, представляет себе что-то своё: один — чат-бот на сайте, другой — инструмент прогноза спроса, третий — «умные» камеры на складе. И все по-своему правы, потому что под словами «искусственный интеллект», или просто «ИИ», в деловом разговоре скрываются пять разных групп технологий — с разной стоимостью, разной степенью зрелости и абсолютно разными рисками. Смешивать их опрометчиво — под одним и тем же словом может обсуждаться и проект за 200 тыс. , и проект за 50 млн. Поэтому, прежде чем решать, нужен ли ИИ моему бизнесу, стоит разобраться, о какой именно технологии ИИ идёт речь.
Рассмотрим подробнее пять групп ИИ-технологий:
1. Машинное обучение на структурированных данных. Прогноз спроса, оценка риска, вероятность оттока, антифрод. Технология зрелая, требует истории данных и даёт численный результат, который легко проверить.
2. Генеративный ИИ на больших языковых моделях. Черновик текста, ответ по документам, извлечение данных, перевод, резюме звонка. Внедряется быстрее всего, но выдаёт правдоподобные ошибки и потому требует проверки.
3. Компьютерное зрение. Контроль качества на производстве, распознавание документов, аналитика в торговом зале. Нужны размеченные изображения и стабильные условия съёмки: смена камеры или освещения бьёт по точности сильнее всего.
4. Речевые или голосовые технологии: распознавание речи, синтез, голосовые роботы, речевая аналитика. Им нужны записи разговоров и интеграция с телефонией, а результат сильно зависит от качества записи — и от того, как клиент воспримет разговор с роботом.
5. Интеллектуальная автоматизация и агенты: сценарии, где модель не только отвечает, но и выполняет последовательность действий в системах компании. Ошибка здесь — уже не неудачный текст, а действие с последствиями.
Чтобы не запутаться в этих пяти группах, мы свели их в одну таблицу: что делает каждая технология, для каких задач подходит, что ей нужно на входе и в чём её главный риск.
Как различать типы решений
Эту таблицу удобно держать под рукой, когда вам в очередной раз предлагают «внедрить ИИ».
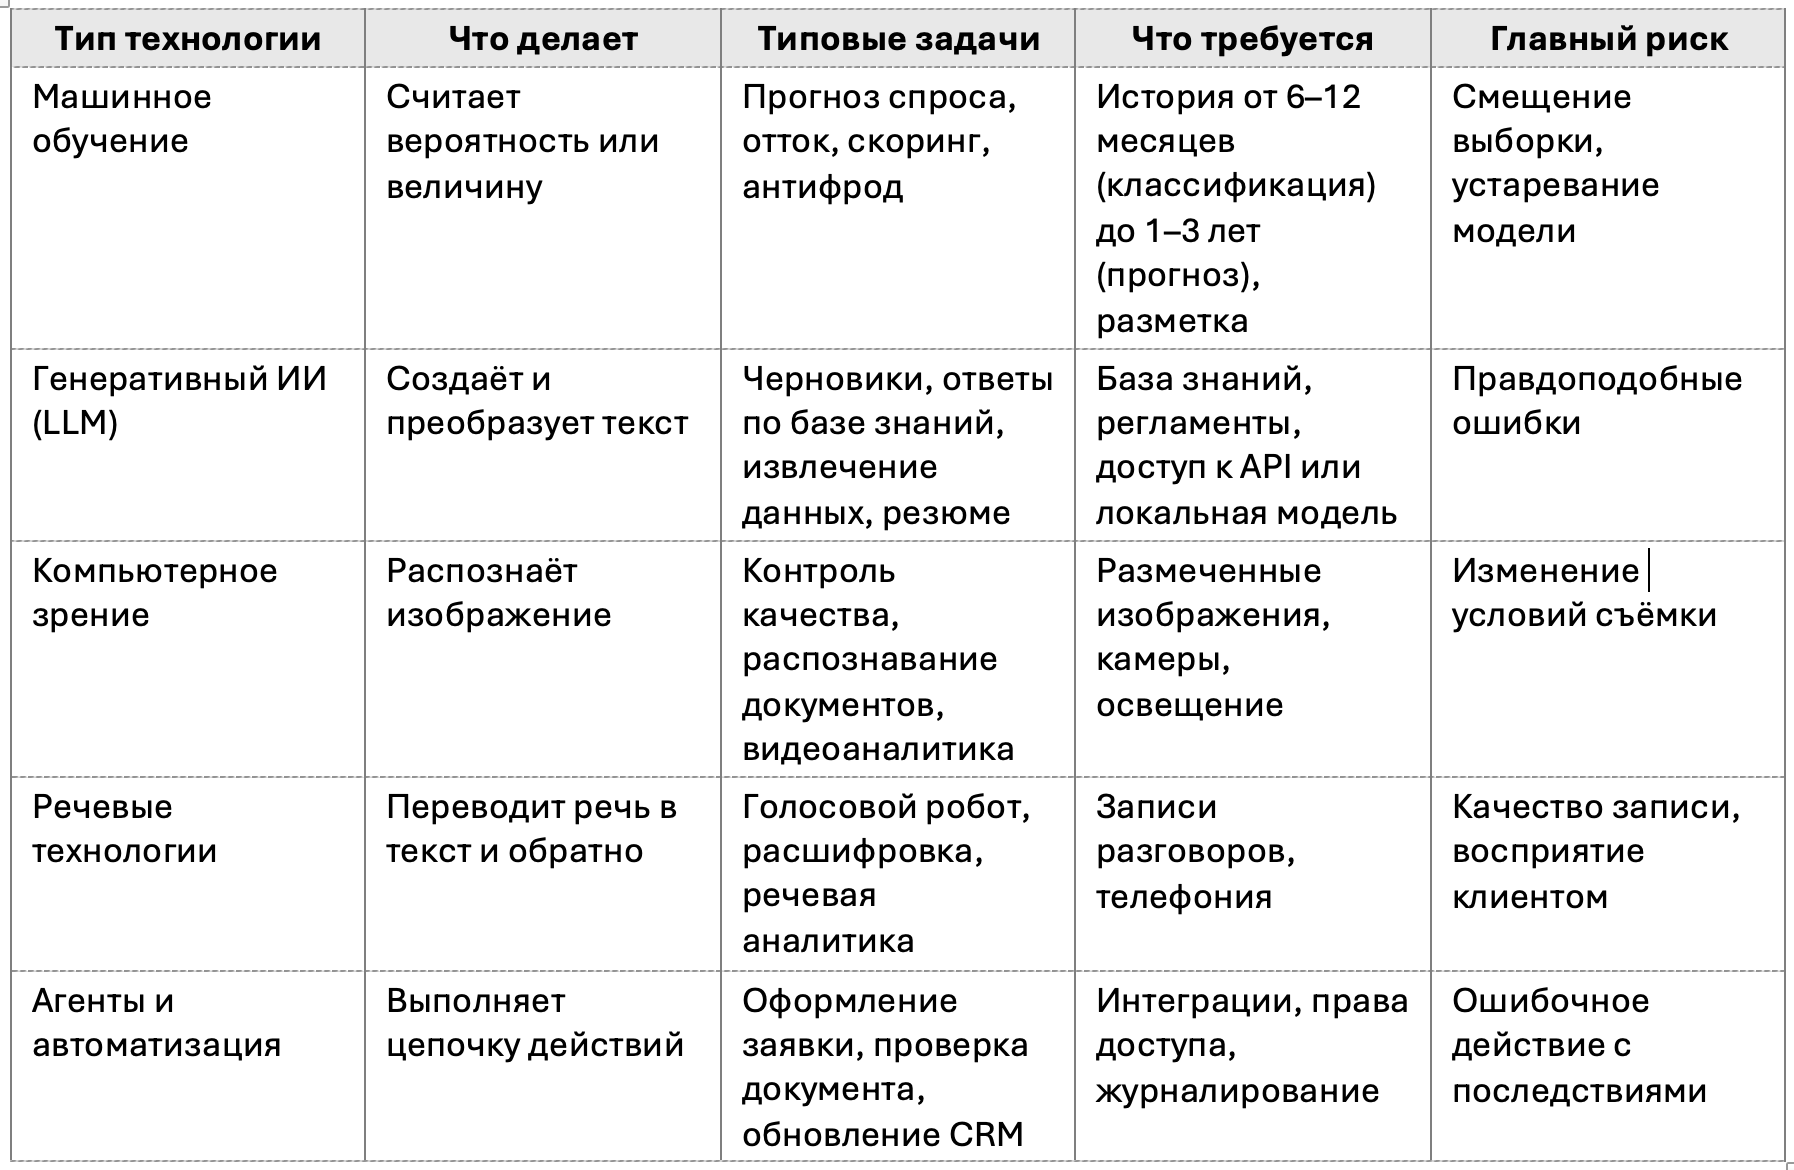
Общее правило: обработка чисел — задача машинного обучения, текста — генеративного ИИ, изображений — компьютерного зрения, речи — речевых технологий, действий в системах — агентов или мультиагентных систем.
Это правило мы умышленно несколько упростили для лучшего запоминания, но на практике вы чаще встретитесь с сочетанием нескольких типов ИИ-технологий в рамках одного проекта. Тем не менее нам показалось важным привести его здесь, чтобы дать базовое понимание, что, обсуждая проект с ИИ, мы можем, например, одновременно говорить и про генеративные модели, и про компьютерное зрение, называя их одним термином «ИИ».
Пример: три уровня зрелости одной задачи
Возьмём одну конкретную задачу — обработку входящего обращения клиента — и разберём три разных уровня реализации, объединённых одним термином «ИИ».
Уровень 1. Классификация. Модель определяет тему обращения и направляет его нужной группе. Нужны размеченные обращения за 6–12 месяцев. Ошибка стоит дёшево: неверная маршрутизация исправляется человеком (технология — машинное обучение).
Уровень 2. Черновик ответа. Языковая модель находит фрагменты базы знаний и предлагает оператору текст. Оператор правит и отправляет. Ошибка модели не доходит до клиента (технология — генеративные модели).
Уровень 3. Автономный ответ. Модель отвечает клиенту без человека. Ошибка сразу доходит до клиента (технология — генеративная модель с поиском по базе знаний; если система ещё и выполняет действия в учётных системах, это уже агент).
Во всех трёх случаях технологию называют «ИИ», но управленческие последствия у них принципиально разные — от дешёвой ошибки маршрутизации до ответа, который уходит клиенту без проверки. Поэтому выбирать стоит конкретный уровень автоматизации для конкретного типа обращений. Начинать — с классификации и черновиков под контролем оператора, а автономные ответы доверять системе только в узких, типовых и хорошо регламентированных запросах, где цена ошибки приемлема.
Потенциал: чего ждать и чего не ждать
Массовое использование ИИ уже произошло, финансовый эффект — еще нет. В опросе McKinsey 2026 года почти девять из десяти респондентов сообщили, что их организации регулярно применяют ИИ хотя бы в одной функции, при этом 37% относят к ИИ хотя бы часть EBIT (операционной прибыли до вычета процентов и налогов), и эта доля за год практически не изменилась [92].
Разрыв между использованием и эффектом — главный факт, из которого исходит эта книга. Он означает, что вопрос «внедрять или не внедрять ИИ» уже не стоит. Более актуален другой вопрос — как получить измеримый результат именно в моей компании? Вот на него мы пытаемся ответить.
Быстрый старт
План на следующие 90 дней:
Шаг 1. Составьте список того, что в компании уже называют ИИ. Обычно обнаруживается несколько несвязанных инициатив, купленных разными подразделениями.
Шаг 2. Разнесите их по пяти типам технологий из таблицы выше. Для каждой зафиксируйте: какая задача, чей процесс, какие данные, кто проверяет результат.
Шаг 3. Уберите дубли и инициативы без владельца процесса. Оставьте не более трёх процессов.
Шаг 4. По каждому оставшемуся процессу определите базовый уровень процесса в цифрах. Без этого замера дальнейшее обсуждение эффекта беспредметно.
Важно!
· Не обсуждайте «ИИ вообще»: для каждой инициативы называйте технологию, процесс и задачу.
· Для каждой инициативы определите владельца процесса и способ проверки результата человеком.
Данные и технологии
Любой ИИ-проект начинается с простого вопроса — какие данные у меня уже есть и можно ли им доверять? Технологии различаются требованиями к данным, но принцип у всех один — модель не создаёт достоверные данные из ничего. Она использует то, что организация уже накопила, — документы, обращения клиентов, записи звонков, транзакции и журналы операций. Поэтому качество ИИ-решения почти всегда ограничено качеством данных и процессов, на которых оно построено.
Для задач машинного обучения нужны цифровые данные за достаточный период — например, история продаж, обращений, отказов или просрочек. Важно, чтобы данные были связаны с фактическим результатом: у обращения есть тема и итог обработки, у лида — статус в CRM, у заказа — дата и сумма. Для многих прикладных сценариев требуется размеченная история за 6–12 месяцев, хотя необходимый период зависит от частоты событий, сезонности и сложности задачи. Если в CRM нет актуальных статусов или сотрудники ведут данные по-разному, модель просто выучит ошибки процесса.
Для генеративного ИИ и RAG-систем главный актив — актуальная база знаний: регламенты, договорные шаблоны, описания продуктов, прайс-листы и другие документы, на которые модель опирается при подготовке ответа. Файлов обычно хватает, проблема в их состоянии — документы дублируются, противоречат друг другу, не имеют владельца, содержат устаревшие цены или существуют только в плохих сканах. Больше информации модель надёжнее не сделает — она просто будет уверенно пересказывать противоречивые или уже не действующие правила.
Для задач компьютерного зрения нужны изображения или видео с понятной разметкой — например, снимки товара с отмеченным дефектом или фотографии документов с выделенными полями. Помимо объёма и разметки, важны стабильные условия съёмки: ракурс, освещённость, камера, фон. Модель, обученная на качественных фотографиях из одного цеха или магазина, может работать заметно хуже в другом, где меняются камера, свет или расположение объекта. Поэтому проверять систему на пилоте нужно в реальных условиях — в том самом цехе, где ей предстоит работать.
Для речевых сценариев — расшифровки звонков, контроля качества диалогов, голосовых помощников — требуются записи разговоров, корректные метаданные и интеграция с телефонией. Вместе с аудио полезно сохранять дату, тип обращения, результат разговора и данные CRM. Тогда ИИ сможет связать содержание разговора с бизнес-результатом — продажей, жалобой или отказом клиента. Правовые основания обработки записей, правила доступа, сроки хранения и порядок обезличивания персональных данных нужно определить заранее.
Агентным системам мало базы знаний или истории операций — агенту нужен контролируемый доступ к рабочим системам: CRM, ERP, почте, базе документов. Именно доступы делают агента полезным, и именно они создают наибольший риск: система может сама создать заявку, изменить статус клиента, отправить сообщение или запустить платёж. Поэтому права даются по принципу минимально необходимых, а все действия фиксируются в журнале: что сделал агент, на основании каких данных, когда, кто это утвердил и, главное, можно ли действие отменить.
Общее правило: ИИ не создаёт порядок в данных автоматически — он делает существующий порядок или беспорядок быстрее, масштабнее и убедительнее.
Компания без актуальных регламентов, единой базы знаний и дисциплины ведения данных рискует получить от модели не надёжного помощника, а аккуратно и доступно сформулированный хаос.
Риски и роль человека
Главная особенность генеративных моделей — способность формировать правдоподобный, связный и уверенно звучащий ответ даже тогда, когда он основан на неверных, неполных или устаревших данных. Такое явление называют галлюцинацией. В отличие от обычного технического сбоя, галлюцинация редко выглядит как ошибка: модель не сообщает, что не уверена, а может привести убедительное объяснение, несуществующую ссылку, неверное правило или придуманный факт. Опасна не столько сама ошибка, сколько то, что её не замечают — пока ответ не ушёл клиенту, не лёг в договор или в управленческое решение.
Общее правило: чем дороже или необратимее последствие ошибки, тем ближе человек должен находиться к моменту принятия и исполнения решения.
В задачах классификации обычно достаточно выборочного контроля: руководитель или специалист регулярно проверяет часть решений модели, оценивает точность и корректирует правила при обнаружении систематических ошибок. В задачах подготовки черновиков контроль должен происходить до внешнего действия: сотрудник читает, исправляет и утверждает текст перед отправкой клиенту, публикацией, внесением в документ или передачей в другую систему. В задачах, где ИИ может самостоятельно выполнить действие, нужен более строгий режим: заранее определённые границы полномочий, подтверждение человеком для критичных операций, возможность отмены, журнал всех действий и постоянный мониторинг отклонений.
Такой подход не означает, что человек должен вручную перепроверять каждую техническую операцию независимо от её значимости. Напротив, задача хорошего процесса — оставить человеку ровно те точки контроля, где его экспертная оценка действительно снижает риск, а рутину передать автоматизации. Например, агент может самостоятельно создать типовую заявку, если все обязательные поля заполнены и действие обратимо, но должен запросить подтверждение перед изменением банковских реквизитов, предоставлением скидки выше установленного лимита, публикацией ответа от имени компании или передачей чувствительных данных.Термин human-in-the-loop, или «человек в контуре», в этой книге означает не формальное присутствие сотрудника рядом с системой, а обязательную и осмысленную проверку результата в той точке процесса, где ещё можно предотвратить нежелательные последствия. Человек должен понимать, что именно предлагает или делает ИИ, иметь право изменить либо отклонить решение и располагать достаточной информацией для такой проверки. Для этого интерфейс системы должен показывать источник данных, логику рекомендации, степень уверенности при наличии такой оценки и историю предыдущих действий. Иначе «человек в контуре» быстро превращается в человека, который просто нажимает «ОК».
Глава 2. Где возникает экономический эффект
Коротко о главе
· Эффект возникает в пяти местах: выручка, затраты, скорость, качество решений, управление рисками.
· Сэкономленное время само по себе не становится деньгами.
· Методику расчёта согласуйте с финансовым директором до старта проекта, иначе эффект невозможно будет подтвердить.
Любой разговор об ИИ-проекте в конце концов упирается в деньги, и это правильно. Деньги почти всегда находятся в одном из пяти мест: выручка, затраты, скорость, качество решений и управление рисками. Всё остальное — в той или иной мере производное от них.
Однако здесь есть неочевидный перекос. Во-первых — в финансовых ожиданиях, которые зачастую сильно завышены. Рост производительности сотрудника и рост прибыли компании — абсолютно разные по финансовой стоимости события. Как мы сказали ранее (см. главу 1), массовое использование ИИ пока не даёт роста EBIT у большинства компаний. Сэкономленное время сотрудников само по себе не превращается в деньги — оно либо уходит в дополнительный объём работы, либо позволяет отказаться от внешних расходов, либо просто растворяется в рабочем дне.
Во-вторых — в том, куда вкладываются деньги. Более половины бюджетов на генеративный ИИ уходит в продажи и маркетинг, а наибольшая финансовая отдача, по данным исследований, в бэк-офисе — там, где ИИ позволяет отказаться от внешнего аутсорсинга и упростить рутинные операции [45].
Пять источников эффекта
У каждого из пяти источников своя механика, свои типовые сценарии и свой способ измерения. Последний столбец подсказывает, когда эффект только кажется эффектом.
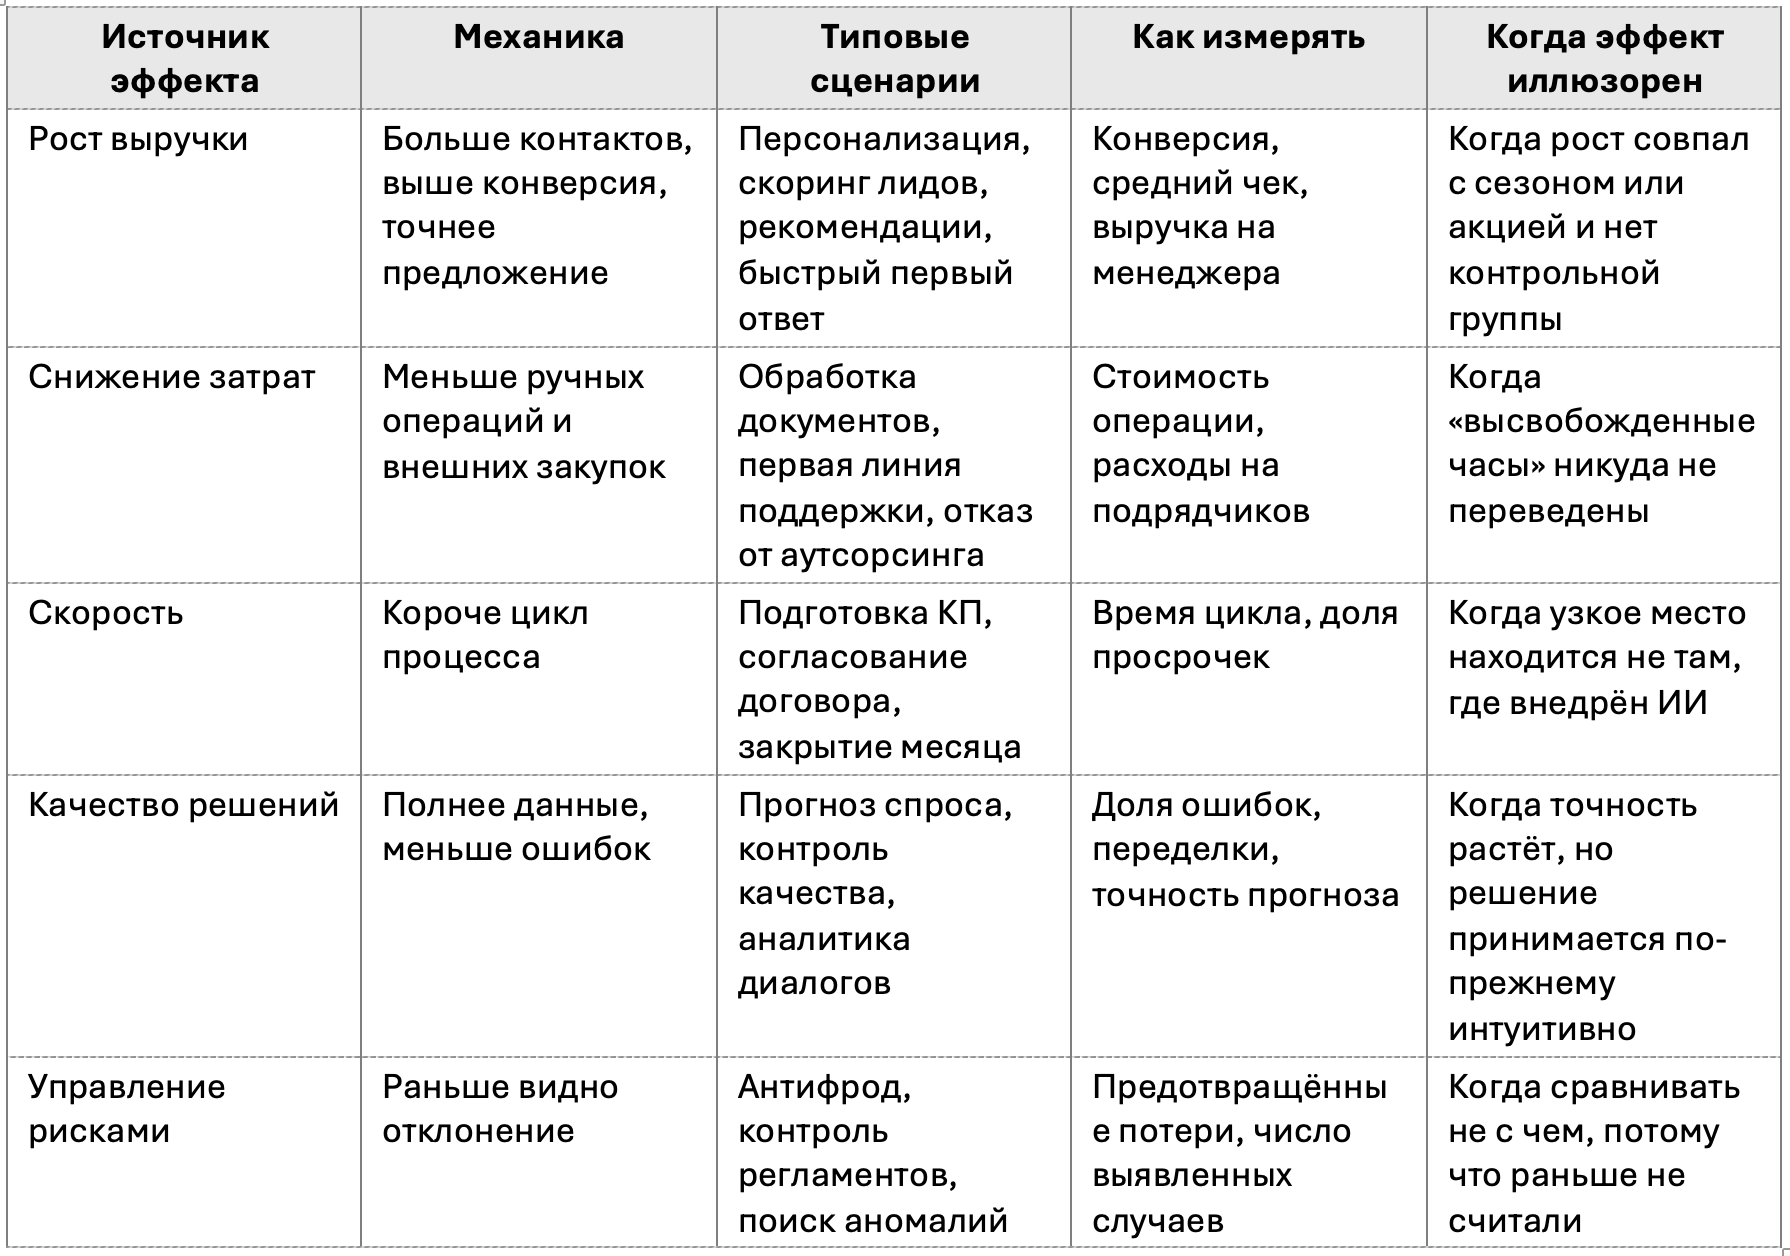
Примеры: где и какой экономический эффект даёт ИИ
Первая линия поддержки. Эффект в затратах. Считается через стоимость обращения и долю обращений, закрытых без оператора. Проверяется просто, поэтому это частый первый проект.
Подготовка коммерческих предложений. Эффект в скорости и выручке. Опасность в том, что экономия времени менеджера превращается в деньги только при росте числа сделок, а не числа отправленных документов.
Закрытие месяца в бухгалтерии. Эффект в скорости и качестве. Измеряется днями закрытия и количеством корректировок. Экономия здесь чаще снимает сверхурочную нагрузку, чем сокращает штат — это реальный, но не денежный эффект, и его нужно называть честно.
Контроль качества на производстве. Эффект в потерях: доля брака, попавшего к клиенту, и стоимость возвратов. Здесь эффект попадает в финансовый результат быстрее всего: каждый не дошедший до клиента дефект — это сразу минус возврат.
Формула выбора эффективного сценария
Чтобы понять, с какого сценария начать, достаточно простой формулы:
Приоритет сценария = ценность × реализуемость × готовность данных.
Ценность оценивается в деньгах за год: объём операций × стоимость операции × ожидаемая доля улучшения.
Реализуемость — наличие интеграций, срок до первого измеримого результата, согласуемость с информационной безопасностью и юристами.
Готовность данных — есть ли нужные данные в одном источнике и можно ли им доверять.
Общее правило: в работу берутся сценарии с высокой оценкой по всем трём множителям. Сценарий с огромной ценностью и нулевой реализуемостью даёт ноль.
Это упрощённая версия формулы для быстрой прикидки. Полную матрицу приоритизации из шести взвешенных критериев — для отбора самого первого проекта — см. в главе 20.
Какой бы сценарий вы ни выбрали, у него есть пять обязательных KPI, и базовый уровень каждого фиксируется до пилота. Стоимость единицы операции — это полные расходы процесса, делённые на число операций; базой служит замер за 1–3 месяца до пилота. Время цикла — медиана от поступления до закрытия, и замерять её нужно по системе, а не по ощущениям.
Доля операций без участия человека берётся из журнала системы; до пилота она обычно близка к нулю. Долю ошибок и переделок определяют выборочной проверкой 100 случаев — и до пилота её замеряют той же методикой.
Пятый показатель — эффект, признанный финансовой службой: сокращение расходов или прирост выручки по методике, согласованной до старта. Он ключевой. Если финансовый директор не согласовал методику до пилота, после пилота он этот эффект не признает.
Быстрый старт
План на следующие 90 дней:
Шаг 1. Выберите три процесса с большим объёмом однотипных операций и понятным владельцем. Объём важнее сложности: эффект масштабируется количеством.
Шаг 2. Измерьте базовый уровень по пяти KPI выше. Согласуйте методику расчёта с финансовой службой письменно.
Шаг 3. Оцените каждый процесс по формуле ценность × реализуемость × готовность данных.
Шаг 4. Сформулируйте для победившего сценария критерий успеха и критерий остановки. Оба — в цифрах.
Важно!
· Определите, какой из пяти источников эффекта вы хотите получить, до выбора технологии.
· Проверьте, куда именно будет переведено высвобожденное время.
· Не начинайте проект, в котором нет ответа на вопрос «в какой строке отчётности мы увидим результат».
Данные и технологии
Как только дело доходит до расчёта эффекта, почти всегда выясняется неприятная вещь — нужных для него данных в компании попросту нет. Полную себестоимость операции, фактическое время цикла, долю ошибок заранее, как правило, никто не считает. Поэтому мы считаем сбор этих данных первой задачей проекта, а вовсе не формальностью, которую можно отложить «на потом».
Что понадобится как минимум? Выгрузка объёмов операций за 12 месяцев, фонд оплаты труда всех участников процесса, расходы на внешних подрядчиков и системные журналы с временными метками. Без этого любой разговор об эффекте превращается в обмен мнениями.
Риски и роль человека
Ошибиться в финансовом расчёте можно по-разному, но эти три ошибки встречаются особенно часто:
1. Высвобожденное время учитывают как деньги, но не говорят, куда именно оно переведено.
2. Результат сравнивают с плохим базовым уровнем, который к тому же измерен иначе, чем сам результат.
3. В расчёте нет контрольной группы, и тогда обычное сезонное колебание легко выдать за успех ИИ.Ответственность за методику расчёта всегда остаётся у финансовой службы и владельца процесса. Модель может подготовить выгрузку и даже всё посчитать, но признать эффект — это управленческое решение, и принимает его именно человек. И лучше — на цифрах, а не на впечатлениях от удачной демонстрации.
Часть II. ИИ по функциям бизнеса
Бизнес не внедряет искусственный интеллект «вообще» — он внедряет его в маркетинг, продажи, клиентский сервис, HR, финансы, юридическую работу, обучение сотрудников и другие конкретные процессы. И здесь быстро выясняется, что одна и та же технология в соседних отделах ведёт себя совершенно по-разному: в маркетинге ускоряет контент, в бухгалтерии разбирает документы, в сервисе снимает с операторов типовые вопросы. Поэтому в каждой главе этой части мы смотрим на одно и то же — где возникает ценность, какие нужны данные, что остаётся за человеком и по каким метрикам понять, что всё это работает.
Читать эту часть удобно как карту точек входа: где ИИ даёт эффект быстрее всего, где ошибка обходится дорого и контроль нужен максимальный, а где можно начать с маленького пилота и постепенно расти дальше.
Читать эту часть удобно как карту точек входа: где ИИ даёт эффект быстрее всего, где ошибка обходится дорого и контроль нужен максимальный, а где можно начать с маленького пилота и постепенно расти дальше.
Глава 3. Маркетинг и бренд
Коротко о главе
· ИИ удешевляет варианты контента, но не позиционирование и не ответственность за бренд.
· Заметный ИИ-контент чаще снижает доверие, чем повышает: выигрывает управляемое качество, а не объём.
· Скорость и стоимость меряются сразу, влияние на выручку — только с контрольной группой.
Маркетинг — пожалуй, первое место, куда ИИ приходит в компанию сам, без всякого проекта внедрения: кто-то из команды уже пишет посты в чат-боте, а дизайнер генерирует картинки для соцсетей. Вопрос в другом — что из этого реально работает на бренд и продажи компании?
В маркетинге ИИ меняет экономику производства контента и глубину персонализации. Дешевеет создание вариантов: текстов, баннеров, видео, продуктовых изображений. Дорожает то, что нельзя автоматизировать: позиционирование, выбор идеи, проверка достоверности и ответственность за бренд.
Но есть и важное ограничение, и связано оно с людьми — с тем, как они воспринимают результат. По опросу 8 тыс. потребителей в восьми странах лишь 7% говорят, что заметный ИИ-контент повышает доверие к бренду, тогда как 31% — что снижает; 91% ожидают раскрытия факта использования ИИ [34]. Именно поэтому выигрывает управляемое качество, а «больше контента» само по себе ничего не даёт.
Сценарии
Сценарии ниже идут от самых сложных к самым простым. У каждого одной строкой — что понадобится и каким решением это обычно закрывается.
Продуктовый визуал по цифровым двойникам — варианты упаковки, языков и форматов без повторной съёмки. Сложность высокая: нужны 3D-модели, печатные файлы упаковки и бренд-стандарты; как правило, это проект с внешней студией.
Массовая адаптация одного креатива под каналы, форматы и рынки — больше вариантов на тот же бюджет. Сложность средняя: мастер-креатив и спецификации площадок, хватает генеративных редакторов.
Персонализация формулировок в email, push и SMS с обязательным A/B-тестом — рост CTR и конверсии рассылок. Сложность средняя: история рассылок с откликами, сегменты и согласия; нужна платформа персонализации.
Быстрая реакция на тренды — ролик или пост за часы в заранее согласованных рамках бренда, без длинного цикла согласований. Сложность средняя: бренд-гайд и одобренные рамки, внутренний ассистент.
Черновики контента и ТЗ дизайнерам с обязательной редактурой — короче цикл производства. Сложность низкая: голос бренда (tone of voice), фактура и база кейсов, ассистент на LLM.
Разметка и поиск по медиатеке, чтобы не переделывать существующие материалы. Сложность низкая: каталог материалов с метаданными, DAM с ИИ-разметкой.
Разбор отзывов, комментариев и обращений — приоритеты для продукта и коммуникации. Сложность низкая: отзывы, обращения и оценки, аналитика текстов.
Описания для маркетплейсов и каталога со сверкой характеристик по товарному справочнику или учётной системе — быстрее выкладка карточек. Сложность низкая: справочник характеристик, генеративный ассистент со сверкой.
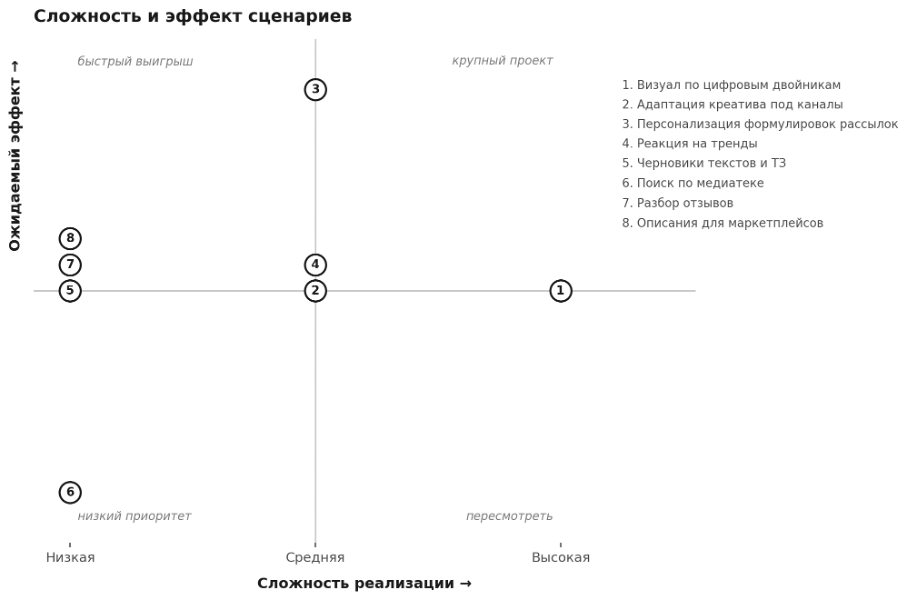
Все восемь сценариев в одном бюджете не поднять, да и не нужно. Начинать разумно с последних четырёх — им не нужны ни внешняя студия, ни сложные интеграции.
Примеры
Кейс 1 · уровень C · крупный бизнес. Unilever, FMCG, производство контента
Проблема: одной линейке товаров Unilever нужны тысячи картинок и роликов — под разные варианты, размеры и языки.
Решение: сделали цифровые двойники продуктов (3D-копии) и модульные съёмочные площадки. Перестроили процесс производства, а не только инструменты.
Результат: к запуску Closeup за три дня собрали более 100 материалов для четырёх рынков на десяти площадках одновременно. Собственная ИИ-студия компании для бьюти-брендов (Beauty AI Studio) ускоряет производство до 30%, досматриваемость роликов и кликабельность (CTR) выросли более чем вдвое [133]. По данным партнёров проекта, изображения делают в 2 раза быстрее и на 50% дешевле, а дублирование контента сократилось в соотношении 5:1 [99].
Условия успеха: единые стандарты бренда и готовые 3D-данные упаковки.
Ограничения: материалы компании и поставщика, независимой проверки нет; влияние на продажи не раскрыто.
Кейс 2 · уровень C · крупный бизнес. Michaels, розница товаров для творчества, персонализация рассылок
Проблема: персонализировать удавалось лишь 20% email-рассылок Michaels, остальные уходили всем одинаковыми.
Решение: модель, обученная на текстах бренда, пишет и подбирает формулировки писем.
Результат: персонализированных рассылок стало 95%, кликабельность (CTR) писем выросла на 25%, SMS — на 41% [86]. Работа идёт с 2019 года [107].
Условия успеха: постоянные эксперименты вместо разовой генерации.
Ограничения: рост кликов не равен росту выручки; часть данных дал поставщик.
Кейс 3 · уровень B · крупный бизнес. СберМаркетинг, агентство, собственные каналы
Проблема: посты для своих каналов готовились долго, ручной сбор фактуры стоил дорого.
Решение: ИИ-агент (программа, выполняющая цепочку шагов) на нескольких моделях ищет фактуру, пишет черновик и задание дизайнеру. Каждый материал обязательно проверяет и правит человек, сохраняя голос бренда.
Результат: за месяц теста цикл подготовки поста сократился на 70%, эксклюзивных публикаций стало в 2 раза больше, пост подешевел в среднем на 52% [123].
Ограничения: месяц наблюдения без контрольной группы; влияние на продажи не измеряли.
Как небольшому агентству пройти путь от выбора процесса до честной экономики первого года — с договором с клиентом, правами на материалы и разговором о скидке — показывает сквозной пример «Полдень» в главах 20–29.
Потенциал и KPI
Скорость и стоимость видны сразу. Время производства единицы контента меряется тайм-трекингом по этапам — фактура, текст, дизайн, согласование; базой служит медиана за 3 месяца до пилота. Стоимость единицы — это затраты на людей, лицензии и подрядчиков, делённые на число материалов, в среднем за квартал. Ориентир даёт кейс СберМаркетинга: минус 70% цикла и минус 52% стоимости поста [123].
Качество показывают два числа: доля черновиков, которые редактор вернул на доработку, и число ошибок факта при выборочной проверке 20 материалов в месяц по чек-листу. Оба нужно снять до внедрения — по той же методике, что и после.
С продажами сложнее. CTR и конверсию в заказ меряют только сравнением тестовой и контрольной групп: базой для CTR служит средний показатель за 6 отправок до пилота, для конверсии — среднее за квартал по атрибуции в CRM или аналитике. Если вы работаете с персонализацией или медиатекой, добавьте ещё два показателя — долю персонализированных кампаний (в кейсе Michaels до внедрения было 20% [86]) и долю повторно созданных материалов (ориентир — сокращение дублирования 5:1 [99]).
Общее правило: скорость и стоимость меряются сразу, эффект на выручку — только через сравнение с контрольной группой.
Внешние оценки (5–15% продуктивности маркетинга) описывают потенциал отрасли, а не гарантию для компании [86].
Быстрый старт
План на следующие 90 дней:
Шаг 1. Выберите один формат с высокой повторяемостью: например, посты в собственных каналах или карточки товаров. Зафиксируйте цикл, стоимость и число ошибок факта.
Шаг 2. Соберите бренд-пакет для модели: голос бренда, запрещённые формулировки, список проверяемых фактов, правила упоминания продуктов. Без него текст получится «средним по интернету».
Шаг 3. Запустите производство в связке «черновик от ИИ — редактура человеком — выпуск». Одновременно ведите A/B-тест формулировок в одном канале.
Шаг 4. Сравните цикл, стоимость, CTR и число ошибок с базовым уровнем. Решите, что масштабировать, а что оставить людям.
Контроль качества контента
Каждый материал проходит шесть контрольных точек — бриф, черновик, право, визуал, раскрытие и публикацию, — и на каждой есть своё стоп-правило и свой ответственный. Нет брифа — нет генерации. Любая непроверяемая цифра удаляется. Утверждение о свойствах или цене без подтверждения снимается. Искажение продукта на визуале — переделка. Сомнение, нужна ли пометка о синтетическом контенте, трактуется в пользу раскрытия. А если цена или наличие в тексте расходятся с системой-источником, публикация останавливается. Полный чек-лист с ответственными по каждому этапу — в Приложении А (шаблон 9 «Чек-лист контроля качества контента»).
Важно!
· Примите и запишите политику раскрытия использования ИИ в коммуникациях.
· Не публикуйте цифры и утверждения о продукте без сверки с системой-источником.
· Эффект на выручку меряйте только через контрольную группу.
Данные и технологии
Хорошая новость: для маркетинга с ИИ не нужно ничего экзотического. Почти всё нужное у вас уже есть — бренд-гайд, медиатека, история кампаний с результатами, справочник характеристик товаров и согласия клиентов на рассылки. Плохая новость в том, что модели это нужно в порядке: бренд-гайд — в машиночитаемом виде, а не в красивом PDF, медиатека — с метаданными, а не папкой «Финал_финал_2». И отдельно про согласия: персонализация без них и без учёта 152-ФЗ приносит компании не выручку, а претензию регулятора.
Подключать придётся то, с чем маркетинг и так работает каждый день, — систему рассылок, аналитику, CRM, медиатеку (DAM) и кабинеты маркетплейсов. Готовы ли вы к этому, проверяется одним простым вопросом: может ли система сама, без менеджера, узнать актуальную цену и наличие товара? Если нет, модель будет уверенно писать о товаре, которого нет на складе, по цене, которая изменилась ещё вчера.
С продуктовыми изображениями правило ещё строже. Физически точную картинку дают только 3D-модели и печатные файлы упаковки — именно на них построен кейс с цифровыми двойниками [99]. Никакой промпт их не заменит.
И последнее, о чём обычно вспоминают слишком поздно. Промпты и версии материалов стоит хранить так же бережно, как макеты: кто автор, когда сделано, что именно создала модель. Когда клиент или регулятор спросит, откуда взялась фраза в рекламе, ответ должен лежать в архиве, а не в памяти уволившегося дизайнера.
Риски и роль человека
Рисков у ИИ в маркетинге четыре, и ни один из них не технический — все они про репутацию и деньги.
Риск достоверности. Закон «О рекламе» требует, чтобы реклама была добросовестной и достоверной. Неверные характеристики, цена или условия покупки — уже нарушение (статья 5) [171]. И неважно, кто написал текст, копирайтер или нейросеть: отвечает тот, кто его опубликовал, то есть ваша компания.
Риск раскрытия. Общей обязанности маркировать ИИ-контент в России пока нет (глава 29), но аудитория своё мнение уже составила: 79% участников теста Ipsos считают, что компании должны честно говорить об использовании ИИ [72]. Если вы работаете на рынке ЕС, требования там строже — они тоже собраны в главе 29.
Риск доверия. Заметный ИИ-контент чаще снижает доверие к бренду, чем повышает его [34]. Парадокс в том, что заметить его не так просто: в слепом тесте 40% зрителей не отличили ролик, сделанный ИИ, от ролика, снятого людьми [72]. Так что раскрывать ли участие ИИ, решает бренд — технология за вас этот вопрос не закроет.
Риск однообразия. В эксперименте BCG с 758 консультантами модель улучшила результат творческой задачи на 40%, но разнообразие идей в группе упало на 41% [13]. Для бренда это прямая угроза: все начинают звучать одинаково. Поэтому идея и позиционирование остаются за людьми, а модель работает на вариациях.
Глава 4. Продажи и работа с клиентами
Коротко о главе
· ИИ меняет подготовку к разговору и дисциплину после него, а не сам разговор.
· Быстрые сценарии: подготовка к встрече, черновики писем, разбор 100% звонков, заполнение CRM.
· Цену, скидку и обещание клиенту определяет только человек и только по данным системы-источника.
Хороший продавец продаёт в разговоре, а время теряет до и после него — на поиск информации, письма и заполнение CRM, которое, как правило, откладывается до вечера пятницы. В продажах ИИ меняет не сам разговор с клиентом, а подготовку к нему и исполнительскую дисциплину после него. Автоматизируются поиск фактуры, разбор звонков, заполнение CRM, черновики писем и приоритизация сделок. Решение о цене, скидке или обещании клиенту остаётся за человеком.
При этом многое зависит от того, с чего вы начинаете. В серии рандомизированных экспериментов на крупной трансграничной торговой платформе эффект генеративного ИИ на продажи колебался от статистически неразличимого до 16,3% — в зависимости от того, насколько плохо задача решалась до этого; прирост шёл через конверсию, а не через размер корзины [9]. Поэтому, прежде чем ждать эффекта, честно ответьте себе — насколько хорошо мои менеджеры справляются с этой задачей сейчас? Без такого замера сравнивать будет не с чем.
Сценарии
Ниже — восемь сценариев, где ИИ уже работает в продажах. У каждого одной строкой — какой эффект ждать, насколько это сложно, что понадобится из данных и каким решением это обычно закрывается.
Автоматическая подготовка к встрече: сводка по клиенту, история обращений, открытые вопросы, риски сделки. Эффект — меньше времени на подготовку и выше доля встреч с релевантной повесткой; сложность низкая: CRM, история переписки и тикеты, хватает готового ассистента над CRM.
Разбор 100% звонков вместо выборки: соблюдение скрипта, возражения, обещания менеджера. Эффект — рост соблюдения скрипта и предметный коучинг; сложность средняя: записи звонков, согласия клиентов и чек-лист качества, нужен сервис речевой аналитики.
Приоритизация лидов и сделок по вероятности закрытия на исторических данных CRM. Эффект — время менеджеров перераспределяется на сделки с высокой вероятностью; сложность средняя: 12–24 месяца истории сделок с исходами, модель на данных CRM.
Черновики писем и коммерческих предложений с обязательной проверкой перед отправкой. Эффект — сокращение времени на письма; сложность низкая: шаблоны, прайс, кейсы и голос бренда, генеративный ассистент.
Автозаполнение CRM по итогам звонка: следующий шаг, сумма, стадия, дата. Эффект — полнота данных и меньше «сделок без следующего шага»; сложность средняя: транскрипты и схема полей CRM, интеграция ассистента с CRM.
Подсказка о выходе из бесперспективного контакта и перераспределении времени. Эффект — экономия времени на неуспешных звонках; сложность высокая: нужны транскрипты с исходами звонков и дообученная модель.
Ответы на входящие типовые вопросы в чате с явным раскрытием, что отвечает бот, и правилом эскалации. Эффект — быстрее первый ответ и меньше нагрузки на менеджеров; сложность средняя: база знаний и правила эскалации, чат-бот с RAG.
Поиск по внутренней базе знаний (RAG — схема, при которой модель отвечает по найденным корпоративным документам): цены, условия, регламенты. Эффект — меньше ошибок в условиях и ценах; сложность низкая: актуальные регламенты и прайсы, RAG-поиск.
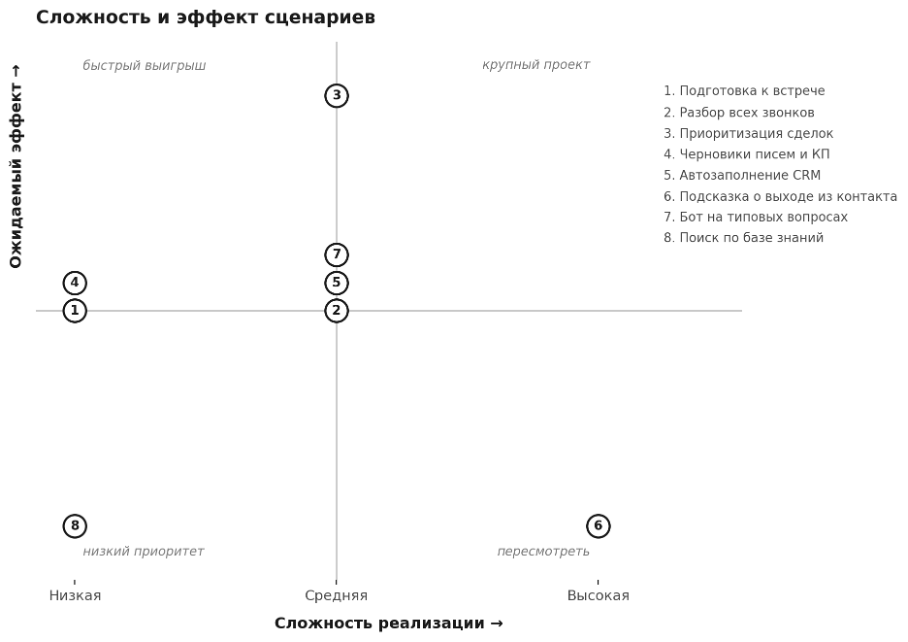
Не все из них одинаково просты. Подготовку к встрече и черновики писем можно запустить за пару недель, а подсказке о выходе из контакта нужны сотни размеченных звонков с исходами.
Примеры
Кейс 4 · уровень C · масштаб не раскрыт. FMCG-дистрибьютор, телефонные продажи в торговые точки
Проблема: 8 тыс. звонков магазинам в день, вручную прослушивали 1,5% разговоров в месяц, по этой выборке скрипт (сценарий разговора) соблюдался на 90%.
Решение: с февраля 2024 года речевая аналитика автоматически оценивает 100% звонков. Супервайзеры каждое утро разбирают отчёты с операторами, руководитель колл-центра раз в неделю обсуждает результаты каждого сотрудника.
Результат: фактически скрипт соблюдали в 40% разговоров, через год — в 70%. Если оператор проговаривает все четыре блока скрипта, магазин берёт на одну товарную позицию больше [170].
Условия успеха: чек-лист качества согласовали заранее, обратную связь встроили в рутину.
Ограничения: кейс поставщика; прежние 90% были завышены выборкой, поэтому «рост» отчасти отражает смену способа измерения.
Кейс 5 · уровень A · масштаб не раскрыт. Исходящие звонки, академический эксперимент
Проблема: время уходит на разговоры, которые ничем не закончатся.
Решение: агент по первой минуте разговора предсказывает неудачу и советует его завершить.
Результат: время на неуспешные звонки сократилось на 54%, почти все продажи сохранились; за счёт освободившегося времени ожидаемые продажи вырастают до 37% [61].
Ограничения: рабочий документ, на дату обращения не рецензирован; прирост продаж — модельная оценка при допущении, что время действительно потратят на звонки.
Собственный кейс авторов — агент на локальной модели, который нашёл для небольшой команды 200 проверенных контактов компаний (одна из сделок дошла до договора), — разобран в главе 23.
Потенциал и KPI
Для каждого KPI фиксируются способ измерения и базовый уровень, измеренный до пилота на том же сегменте.
Начните со времени менеджеров. Долю времени на продажу дают хронометраж или выгрузка активностей из CRM за 2 недели; для ориентира — до внедрения непродажные задачи занимали более 70% времени продавцов Microsoft [93]. Время на переписку считают учётом времени или оценкой по количеству писем; ориентир — 12,1 часа в неделю на письма, из них 6,2 часа — с нуля [55]. Соблюдение скрипта меряется автооценкой 100% разговоров по чек-листу: в кейсе FMCG на старте автооценки оно составило 40% [170].
Дисциплину показывают ещё два числа. Полнота ведения CRM — доля сделок с заполненным следующим шагом и суммой, база — эта доля до внедрения. Время первого ответа в чате берётся из логов чат-канала, база — медиана до внедрения.
С выручкой сложнее. Конверсию из квалифицированного лида в сделку смотрят по воронке CRM, сравнивая тестовую и контрольную группы менеджеров; база — среднее за 6 месяцев до пилота. Длительность цикла сделки — медиана дней от квалификации до закрытия, база — медиана за 6 месяцев до пилота.
Внешние ориентиры эффекта: рост эффективности продаж на 10–15% при технологизации процесса [90] и экономия в среднем 90 минут в неделю по опросу 133 продавцов Microsoft [93].
Обе цифры — самоотчёты без контрольной группы. Собственный потенциал следует проверить пилотом.
Быстрый старт
План на следующие 90 дней:
Шаг 1. Выберите один процесс и одного владельца процесса. Зафиксируйте базовые значения трёх KPI: доли времени на продажу, полноты CRM и конверсии лида в сделку. Разделите менеджеров на тестовую и контрольную группы.
Шаг 2. Запустите два сценария с низким риском: подготовку к встрече и черновики писем. Введите правило: ни одно письмо не уходит клиенту без проверки человеком.
Шаг 3. Подключите разбор звонков по согласованному чек-листу. Встройте разбор в еженедельный коучинг, иначе аналитика не меняет поведение.
Шаг 4. Сравните группы, посчитайте затраты на лицензии, интеграцию и время сотрудников. Примите решение: масштабировать, изменить сценарий или остановить.
Карточка встречи
Перед встречей у менеджера должна быть карточка из шести полей. Клиент, отрасль, роль собеседника и история — покупки, обращения, открытые вопросы — берутся из CRM и тикетов, их проверяет менеджер. Цель встречи и следующий шаг ставит сам менеджер, руководитель проверяет их на выборке. Три гипотезы потребности и риски сделки с причинами возможного проигрыша предлагает ассистент, менеджер их проверяет. А ограничения — цена, сроки, юридические условия — берутся из прайса и регламентов и обязательно проверяются человеком. Полный шаблон — в Приложении А (шаблон 10 «Карточка встречи»).
Важно!
· Цены, условия и обещания клиенту всегда проверяет человек.
· Разделите менеджеров на тестовую и контрольную группы до запуска.
· Встройте разбор звонков в еженедельный коучинг, иначе аналитика не меняет поведение.
Данные и технологии
Что понадобится, зависит от задачи. Модели приоритизации нужна история сделок с исходами за 12–24 месяца, разбору звонков — записи с согласием клиентов, ассистенту — актуальные прайсы, регламенты и база знаний. Без исходов сделок модель приоритизации учить попросту не на чем: она не знает, чем заканчивались похожие сделки.
С записями разговоров отдельная история. Обрабатывать персональные данные клиентов можно только при законном основании — согласии, договоре с клиентом или другом основании из статьи 6 152-ФЗ; требования к самому согласию — в статье 9 [152]. Решение отправить записи звонков во внешний сервис принимается отдельно и только после юриста.
Подключать придётся CRM, телефонию, почту и базу знаний. Но прежде чем покупать что-то сверху, посмотрите на две цифры: какая доля сделок в CRM имеет запланированный следующий шаг и какая доля звонков привязана к сделке. Если хотя бы одна ниже половины, сначала чинится процесс, а не покупается модель. Разницу легко увидеть: «Отправить договор в четверг» — это следующий шаг, а пустое поле или «Созвониться» — нет. Модель, обученная на пустых полях, научится только одному — оставлять их пустыми.
И последнее. Ассистент должен отвечать по документам компании — так устроена схема RAG. Если он отвечает «из головы», то есть из общей памяти модели, появляются галлюцинации: правдоподобные, но неверные цены и условия. В системной инструкции стоит прямо запретить ответы вне найденных документов. Это заметно снижает риск, но проверку менеджером не отменяет — подпись под коммерческим предложением всё равно ставит человек.
Риски и роль человека
Главный риск — неверное или неисполненное обещание клиенту. Цена, скидка, срок поставки и юридические условия подтверждаются человеком и должны браться из системы-источника, а не из текста, который предложила модель.
Второй риск — скрытая автоматизация. В эксперименте на 6 255 клиентах бот без раскрытия был сопоставим с опытными операторами (доля покупок 0,237 против 0,251), но если клиенту до начала разговора сообщали, что с ним говорит бот, доля покупок снижалась до 0,048, то есть на 79,7% [84].
Скрывать бота — не выход: раскрытия требуют и доверие клиентов, и регулирование (глава 29). Поэтому формулировку раскрытия и момент передачи разговора человеку нужно проектировать и тестировать так же тщательно, как скрипт.
Третий риск — эффект зависит от типа задачи. В том же эксперименте BCG с 758 консультантами (глава 3) работа с моделью улучшила результат творческой задачи на 40%, но ухудшила результат аналитической задачи на 23% [13]. В продажах это означает: генерация черновиков — да, самостоятельные выводы о причинах потери сделки — с проверкой.
Четвёртый риск — подмена причин отказа. По опросу 1 000 продавцов, 37% проигранных сделок связаны с несоответствием продукта потребности, 35% — с ценой и ценностью [64]. Такие причины ускорением переписки не лечатся.В регулируемых продажах (финансовые продукты, медицинские товары, страхование) любое утверждение о свойствах и стоимости требует проверки человеком до отправки клиенту: реклама должна быть достоверной по статье 5 Федерального закона «О рекламе» [171]. Модель может написать идеальное письмо, но отвечать за обещание в нём всё равно будут ваш менеджер и ваша компания.
Глава 5. Клиентский сервис и контакт-центры
Коротко о главе
· Сервис — первая функция, где генеративный ИИ работает массово.
· Порядок внедрения: помощник оператора, затем автономный ответ на узком наборе тем с правилом эскалации.
· Решение о масштабировании принимается по повторным обращениям и точности, а не по доле автоматизации.
Если у вас есть контакт-центр или хотя бы пара операторов в чате, вопрос «как ИИ поможет моему сервису?» возникает одним из первых — и не случайно. Сервис — первая функция, где генеративный ИИ дошёл до массовой промышленной эксплуатации. Причина проста: обращения однотипны, ответы уже записаны в регламентах и базе знаний, а результат измеряется каждый день.
Меняются три слоя работы:
1. Типовые запросы со стандартным ответом.
2. Подготовка ответа для оператора — черновик, поиск по документам, история клиента.
3. Контроль качества — раньше выборочно проверяли 5–10% звонков, теперь можно анализировать все [139].
Важно различать два режима. Автономный агент отвечает клиенту сам. Помощник оператора (copilot) готовит вариант, а отправляет человек.
Есть и фон, который нельзя игнорировать, — клиенты всё чаще решают вопрос вне вашего канала. Gartner прогнозирует, что к 2027 году 40% обращений будут полностью закрываться сторонними GenAI-инструментами — ChatGPT, Google AI Overviews, Apple Intelligence [51]. А значит, содержание вашей публичной справки становится частью сервиса.
Сценарии
Ниже восемь сценариев. Для каждого указано, насколько это сложно для компании без своей команды данных, что понадобится и каким решением это обычно закрывается.
Автономный ответ на типовые запросы — статус заказа, срок доставки, условия возврата, режим работы. Требуется актуальная база знаний и доступ к статусам в учётной системе. Сложность средняя: обычно это готовый ИИ-агент в helpdesk, а эффект — снижение доли обращений, доходящих до оператора.
Помощник оператора — черновик ответа со ссылками на регламент, оператор правит и отправляет. Схема RAG — модель отвечает по найденным корпоративным документам. Сложность низкая: нужны история переписки и регламенты, хватает встроенной функции платформы; эффект — короче время обработки и ровнее качество.
Маршрутизация и классификация — тема, продукт, тональность, срочность. Обращение сразу попадает нужной группе. Сложность низкая: размеченные обращения за 3–6 месяцев, готовая модель или API; эффект — меньше переадресаций, точнее SLA.
Суммаризация диалога и автоматическое заполнение карточки после разговора. Снимает «постобработку» с оператора. Сложность низкая: транскрипты и поля CRM, достаточно API модели.
Речевая аналитика — расшифровка звонков, проверка скрипта, поиск причин повторных обращений. Позволяет перейти от выборочного контроля к полному. Сложность средняя: записи звонков и критерии оценки, сервис оператора связи или облака.
Помощь в письменных каналах на нескольких языках — перевод и стилистическая правка перед отправкой. Сложность средняя: глоссарий и tone of voice, готовый сервис перевода; эффект — новые рынки без расширения смены.
Анализ причин обращений — группировка тем и передача их владельцам продукта. Самый недооценённый сценарий: он сокращает поток, а не ускоряет ответ. Сложность средняя: обращения за 6–12 месяцев, API модели плюс аналитика.
Подсказка следующего действия по клиенту с историей покупок. Если действие затрагивает деньги клиента — списание, начисление, блокировку, — система его не выполняет: оператор проверяет и подтверждает рекомендацию вручную. Сложность средняя: история покупок и правила, модуль CRM или helpdesk.
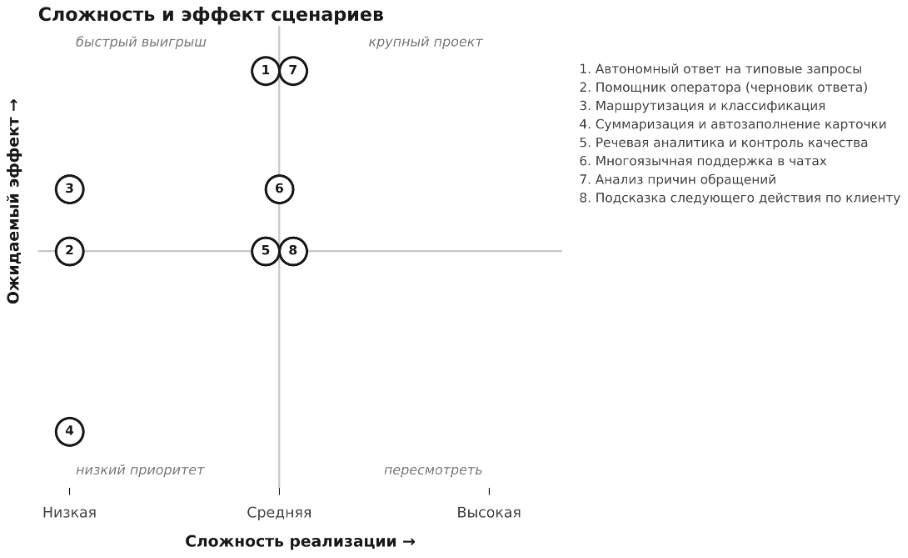
Начинать разумно с трёх сценариев низкой сложности — помощника оператора, маршрутизации и суммаризации: им хватает встроенных функций платформы или API модели. Автономный ответ включают следом, на узком наборе тем.
Примеры
Кейс 6 · уровень B · крупный бизнес. Klarna: масштаб и последующая коррекция
Проблема: платёжный сервис Klarna (150 млн клиентов) получал массу однотипных обращений на 23 рынках, клиенты подолгу ждали ответа.
Решение: в чат поставили ассистента на моделях OpenAI, говорящего более чем на 35 языках. Первым отвечает он, человек подключается по просьбе клиента.
Результат: по данным компании, за первый месяц — 2,3 млн диалогов, две трети всех обращений, работа около 700 сотрудников на полной занятости. Вопрос решался меньше чем за 2 минуты вместо 11, повторных обращений стало на 25% меньше, вклад в прибыль 2024 года оценили в 40 млн долларов [102]. Но в мае 2025 года глава компании признал, что стоимость стала слишком доминирующим критерием и «в итоге получаете более низкое качество», — Klarna снова набирает людей, чтобы клиент всегда мог поговорить с человеком [46].
Условия успеха: единая база знаний, доступ к данным заказов, жёсткое правило передачи человеку.
Ограничения: цифры опубликовали поставщик и компания, независимой проверки нет; считали число диалогов, а не удовлетворённость клиентов по сегментам.
Кейс 7 · уровень C · крупный бизнес. «Инфосистемы Джет»: обращения на готовых сервисах
Решение: сервисный центр «Инфосистемы Джет» (ИТ-услуги) за месяц запустил обработку обращений на YandexGPT.
Результат: нейросеть обрабатывает 30% обращений, 75% её ответов не требуют участия сотрудника [139]. Похожий пример — в «Сфера Документы» («СберКорус») оператор тратил на запрос в среднем 10 минут, бот отвечает за 1–2 секунды [139].
Ограничения: данные облачного провайдера (продавца нейросети); методика замера не раскрыта, влияние на выручку не показано.
Кейс 8 · уровень A · крупный бизнес. Ответственность за ответ бота
Что произошло: чат-бот Air Canada сказал клиенту, что заявку на тариф в связи с утратой можно подать в течение 90 дней после выписки билета. Правила этого не предусматривали.
Итог: трибунал Британской Колумбии (Moffatt v. Air Canada, 2024 BCCRT 149) решил, что компания обязана заботиться о пользователях бота, но не приняла разумных мер для точности ответов, — это небрежное искажение информации. Довод, что бот — «отдельное юридическое лицо», суд назвал remarkable submission («примечательным доводом») [31]. Взыскано 650,88 канадского доллара разницы в тарифе, а также 36,14 доллара процентов и 125 долларов сборов [127].
Вывод: ответ бота — это ответ компании. Сценарии, где бот формулирует условия договора, тарифы и сроки, требуют шаблонов, а не свободной генерации.
Собственный кейс авторов — чат-бот для слушателей программ дополнительного образования, который окупился за несколько месяцев, но остановился в развитии после ухода ключевого заказчика, — разобран в главе 27.
Потенциал и KPI
Главный соблазн в сервисе — мерить успех долей автоматизации. Мы советуем смотреть шире: сколько обращений бот действительно закрыл, не возвращаются ли клиенты с тем же вопросом и во что обходится каждое решённое обращение.
Сколько закрывает бот. Доля обращений, закрытых без оператора, — решённые ботом диалоги, делённые на все входящие. Брошенные и переданные человеку диалоги считайте отдельно — так строит эту метрику Salesforce [116]. База — нынешняя доля самообслуживания до пилота.
Не возвращаются ли клиенты. Это сторожевой показатель: доля обращений, с которыми клиент пришёл повторно в течение 7 дней. Если она растёт, любой выигрыш в скорости ничего не стоит. База — значение за квартал до пилота; для ориентира — Klarna сообщала о снижении повторных обращений на 25% [102]. Рядом с ним смотрят среднее время до решения (медиана за квартал, сравнивать только внутри одного типа обращений) и CSAT — отдельно по диалогам с ботом и без него.
Насколько бот точен. Старший оператор каждую неделю проверяет 100 диалогов и считает долю ответов без фактических ошибок. База — первая неделя пилота.
Во что обходится обращение. При оплате «за результат» стоимость решённого обращения видна прямо в счёте: Intercom, например, берёт за ИИ-агента 0,99 доллара за результат, не больше одного на диалог [70]. Сравнивайте её с нынешней стоимостью обращения у оператора с учётом ФОТ смены.
А вот сравнивать свои цифры с чужими бенчмарками бессмысленно. Gartner прямо предупреждает: боты слишком разные по типу, дизайну и сложности — и советует мерить достижение цели, долю отказов, число шагов диалога и время обработки относительно собственного базового уровня [52].
Быстрый старт
План на следующие 90 дней:
Шаг 1. Выгрузите обращения за 6 месяцев, сгруппируйте по темам, выберите 5–10 тем с максимальной частотой и минимальным риском ошибки. Назначьте владельца процесса — руководителя сервиса.
Шаг 2. Приведите в порядок базу знаний по выбранным темам: один документ — один вопрос, актуальная дата, ответственный. Без этого шага любой бот транслирует устаревшие правила.
Шаг 3. Запустите помощника оператора в одном канале. Отправляет человек. Это даёт быстрый эффект и размеченные данные о качестве ответов.
Шаг 4. Включите автономный агент на подмножестве тем для части трафика (10–20%). Обязательно: явное уведомление, что отвечает ИИ, и кнопка перехода к оператору.
Шаг 5. Сверьте шесть KPI с базовым уровнем. Решение о масштабировании принимается по повторным обращениям и точности, а не по доле автоматизации.
Порядок «сначала помощник оператора, потом автономный агент» снижает риск: агентные проекты чаще всего останавливают из-за роста затрат и слабого контроля (глава 20).
Важно!
Утвердите правило эскалации из восьми пунктов и проверьте его на 20 реальных диалогах до запуска.
Сначала запускайте помощника оператора, автономный агент — только на узком наборе тем.
О масштабировании решайте по повторным обращениям и точности, а не по доле автоматизации.
Данные и технологии
Боту в сервисе нужно немного, но без этого он бесполезен: база знаний в машиночитаемом виде, история обращений, справочник статусов заказов и платежей и права доступа по ролям. Самое важное здесь — статус заказа. Без него бот отвечает общими словами и только раздражает клиента, который хотел услышать одно: где его заказ.
Технически всё сводится к одной цепочке: канал (чат, почта или телефон) — helpdesk — учётная система. Если к ним добавляется голос, понадобятся распознавание и синтез речи. Платят за них по факту — от 0,65 за минуту расшифровки до 0,70–2,50 за минуту речевой аналитики в зависимости от объёма [157]; подробнее о ценах — в главе 17.
И два правила, которые не обсуждаются. Первое: модель получает только те персональные данные клиента, которые нужны для ответа, и ни строчкой больше. Второе: каждый запрос и ответ записывается в журнал. Когда клиент скажет «ваш бот мне это пообещал», журнал будет единственным способом выяснить, что на самом деле произошло.
Риски и роль человека
Самая дорогая ошибка сервисного бота — продолжать разговор, когда клиенту уже нужен человек. Поэтому первым делом мы советуем утвердить правило эскалации: диалог немедленно уходит оператору, если срабатывает хотя бы один из восьми пунктов.
1. Клиент просит человека — прямо или косвенно («позовите оператора», «не помогает»). Требование всегда доступного человека — прямой вывод из опыта Klarna [46].
2. Речь идёт о деньгах: возврат, списание, компенсация, смена тарифа или условий договора.
3. У вопроса есть правовые последствия: претензия, спор, запрос персональных данных, отказ в услуге.
4. Модель не уверена в ответе (ниже установленного порога) или в базе знаний нет документа по теме.
5. Клиент повторяет вопрос в третий раз или в диалоге видны признаки конфликта.
6. Клиент в уязвимом положении: сообщает о болезни, утрате, угрозе здоровью или безопасности.
7. Обращение связано с инцидентом — аварией, утечкой, блокировкой счёта.
8. Диалог превысил лимит шагов и так и не привёл к результату.
Но и само правило работает, только если оператор видит весь предыдущий разговор. Клиент, которому после бота приходится заново объяснять свою проблему человеку, запомнит не скорость ответа, а потерянное время.
Теперь о критике полной автоматизации — по существу.
Во-первых, метрика «доля автоматизации» легко улучшается за счёт вытеснения клиента из канала — это видно по брошенным диалогам. Во-вторых, экономия на качестве возвращается позже: Klarna публично признала снижение качества и вернула людей [46]. В-третьих, ответственность за ответ бота несёт компания (Moffatt v. Air Canada) [31].
Ожидания рынка стоит читать осторожно. 75% CX-руководителей ожидают, что в ближайшие годы 80% взаимодействий будут решаться без участия человека [140]. Но ожидание — ещё не результат.
Важная регуляторная оговорка — клиент должен знать, что говорит с ИИ; на рынке ЕС это прямая обязанность (глава 29). Для финансовых, медицинских и страховых тем решение, влияющее на права и деньги клиента, остаётся за сотрудником.Оператор перестаёт печатать однотипные ответы и отвечает за сложные диалоги, проверку выборки ответов ИИ и поддержку базы знаний. Контроль качества и работа с исключениями становятся основной частью должности, а не остатком. А клиент, у которого спор о деньгах или настоящая беда, по-прежнему говорит с человеком.
Глава 6. Финансы, бухгалтерия и закупки
Коротко о главе
· Сценарии: ввод первички, сверка счетов с договорами, объяснение отклонений, сплошной контроль расходов.
· Сверка с договорами находит деньги, а не только экономит минуты.
· Решения о платежах, признании расходов и отчётности остаются за человеком.
В бухгалтерии и закупках ИИ может сделать две очень разные вещи — сэкономить минуты или найти деньги. Вторая встречается реже, но именно ради неё стоит браться за проект. Финансовая функция устроена удобно для автоматизации: операции повторяются, результат сверяется с внешними данными, ошибка обнаруживается при контроле. Поэтому здесь ИИ быстрее всего переходит из презентаций в регламенты.
Меняются четыре слоя работы:
1. Ввод документа — счёт, акт, накладная превращаются в проводку без ручного набора.
2. Сверка — счёт против договора, платёж против заказа, банковская выписка против учёта.
3. Объяснение цифр — отклонение бюджета, динамика затрат, комментарий к отчёту.
4. Контроль — вместо выборки проверяется весь массив операций.
Сценарии
Сценариев десять. У каждого — оценка сложности для компании без собственной команды данных, нужные данные и привычный тип решения.
Распознавание и ввод первичных документов с формированием проводки. Требуется поток документов и справочники контрагентов и номенклатуры. Сложность средняя: сервис распознавания в связке с учётной системой даёт меньше ручного набора и ниже долю ошибок ввода.
Сверка счёта с договором и заказом — цена, объём, скидка, условия оплаты. Самый недооценённый сценарий, поскольку находит деньги, а не экономит минуты. Сложность высокая: нужны оцифрованные договоры и реестр заказов, решение — отраслевое или собственная разработка; эффект — возврат переплат и меньше утечек по условиям договоров.
Разбор дебиторской и кредиторской задолженности — приоритизация просрочек, черновики претензий и писем. Сложность низкая: платёжная история и договоры, модель приоритизации плюс шаблоны писем; эффект — меньше просроченной задолженности.
Объяснение отклонений бюджета — помощник собирает факторы и готовит комментарий, который правит финансовый контролёр. Сложность низкая: план, факт и аналитики затрат, LLM с доступом к отчётам по схеме RAG; комментарии готовятся быстрее.
Классификация затрат и категоризация поставщиков для управления закупками. Сложность средняя: реестр расходов за 12–24 месяца, API модели плюс аналитика; в итоге — прозрачная база для переговоров о цене.
Подготовка технического задания и сравнение коммерческих предложений в закупках. Сложность низкая: каталог, стандарты и прошлые ТЗ, внутренний помощник в закрытом контуре; меньше раундов уточнений, больше участников тендера.
Поиск закупок в обход договоров (в закупках их называют «маверик», от англ. maverick spend) — операции мимо утверждённых договоров и каталогов, без положенных корпоративных скидок. Сложность средняя: реестр операций 1С за 12–24 месяца, действующие договоры и каталог номенклатуры; эффект — меньше утечек бюджета и сохранённые договорные скидки. Алгоритм только подсвечивает подозрительные операции, а приостановить платёж или разбираться с инициатором решает финансовый контролёр.
Сплошной разбор условий договоров поставщиков — обязательства, индексация цен, штрафы и отклонения от вашего стандарта допустимых условий (юристы называют его плейбуком). Сложность высокая: договоры в машиночитаемом виде и утверждённый перечень допустимых отклонений; эффект — меньше автопролонгаций невыгодных договоров и неучтённых рисков во всём портфеле. ИИ готовит таблицу отклонений, а формулировку или протокол разногласий утверждают юрист и категорийный менеджер.
Контроль расходов сотрудников — проверка 100% отчётов на дубли, нарушения политики, нетипичные суммы. Сложность средняя: отчёты, чеки и политика расходов, специализированный сервис аудита расходов.
Поддержка закрытия периода — контрольные списки, поиск незакрытых документов, черновики пояснений. Сложность средняя: календарь закрытия и журналы операций, модуль учётной системы; меньше просроченных задач закрытия.
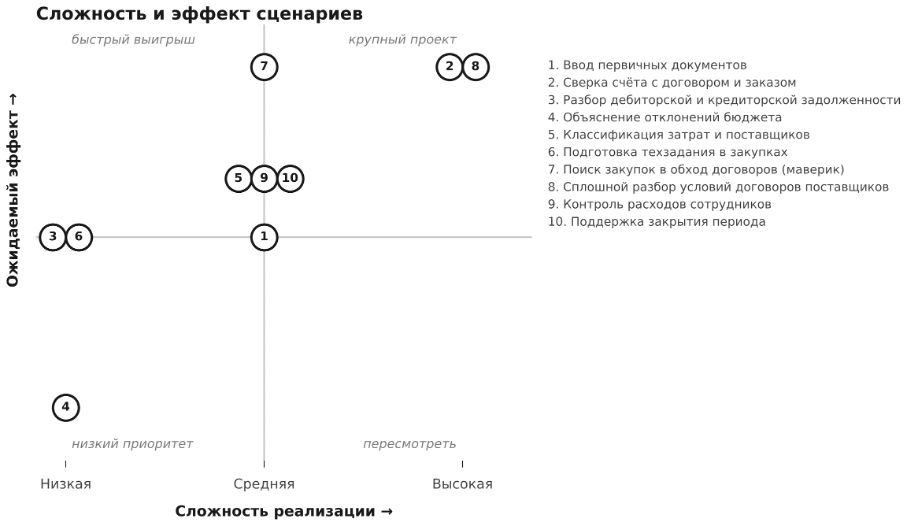
Самые лёгкие входы — объяснение отклонений бюджета и техзадания в закупках: у них низкая сложность. Сверка счетов с договорами и сплошной разбор условий договоров — самые сложные сценарии, зато именно они находят деньги.
Решения о платеже, признании расхода, налоговой позиции и содержании отчётности всегда должен принимать человек. ИИ только готовит материал для решения.
Примеры
Кейс 9 · уровень C · крупный бизнес. Сеть «Подружка»: ввод первички
Проблема: сеть косметики и парфюмерии «Подружка» (ООО «Табер Трейд», 250 магазинов) получает тысячи счетов в месяц, свыше 90% — на бумаге. Ввод отнимал 2–3 часа в день и давал ошибки.
Решение: интеллектуальные сервисы Directum Ario связали с Directum, 1С и операторами ЭДО (электронного обмена документами).
Результат: сервис извлекает из счетов 90% данных и верно определяет 95% реквизитов, у бухгалтеров освободилось 3 часа в день. Проект занял 6 месяцев [33].
Условия успеха: единый канал приёма документов, порядок в справочниках, интеграция с учётной системой.
Ограничения: публикация поставщика в конкурсной заявке; методика замера не раскрыта, экономический эффект не приведён.
Кейс 10 · уровень B · крупный бизнес. «Акрон Холдинг»: техзадание в закупках
Проблема: в промышленном холдинге более 20 тыс. закупок в год. Заказчики описывали потребность как придётся; из-за слабых техзаданий росло число раундов переговоров, а часть поставщиков не выходила на тендер.
Решение: ИИ-инструмент в закрытом контуре (на собственных серверах) по свободному описанию заказчика дописывает характеристики, ГОСТы и параметры.
Результат: разработка заняла около месяца и 20 человеко-часов. За первые четыре месяца прошло более 400 техзаданий, экономия одного только времени превысила 2 млн рублей [112].
Ограничения: экономию считала сама компания, влияние на цену закупок не измеряли.
Кейс 11 · уровень C · крупный бизнес. Сверка счетов с договорами
Решение: глобальная биотехнологическая компания (не раскрыта) поручила агентной системе (ИИ, сам выполняющий цепочку действий) сверять счета с условиями договоров.
Результат: нашлись расхождения примерно на 4% от суммы закупок — при расходах 1 млрд долларов это 40 млн долларов ежегодного эффекта на маржу [89]. В глобальной фармацевтической компании прототип такой сверки собрали за четыре недели и нашли расхождения более чем на 1 млн долларов [87].
Ограничения: кейсы консультанта, независимо не проверены; эффект зависит от того, оцифрованы ли договоры.
Кейс 12 · уровень B · крупный бизнес. Отчёт с выдуманными ссылками
Что произошло: в отчёте Deloitte Australia для Department of Employment and Workplace Relations (237 страниц, 290 тыс. долларов) нашлись ссылки на несуществующие исследования и выдуманная цитата из решения федерального суда.
Итог: в исправленной версии фирма раскрыла, что пользовалась Azure OpenAI, и согласилась вернуть часть оплаты [47].
Вывод: аналитический или пояснительный текст, подготовленный с ИИ, до отправки нужно проверить — каждую ссылку и цифру. Ответственность за документ остаётся на организации.
Потенциал и KPI
В финансах эффект ИИ видно по трём вещам: как быстро и дёшево обрабатываются счета, сколько денег нашла сверка и насколько чище стало закрытие периода. Для первой группы есть внешний ориентир — исследование Ardent Partners [8]. Только читать его стоит с поправкой: больше половины участников — компании с выручкой свыше 1 млрд долларов, опрос проведён весной 2024 года на 212 респондентах. Это планка, к которой можно стремиться, но не норма для вашей компании.
Обработка счетов. Начните со стоимости одного счёта: затраты подразделения за период, делённые на число счетов. В среднем у участников исследования это 9,40 доллара, у лучших 20% — 2,78 доллара. Рядом — время обработки, от получения счёта до проводки: в среднем 9,2 дня, у лучших — 3,1 дня. Третий показатель — доля счетов, которые прошли до проводки без участия бухгалтера: в среднем 32,6%, у лучших 49,2%. И четвёртый, сторожевой, — доля «исключений», то есть документов, которые система не смогла разнести сама и отдала человеку (в среднем 14%). Если исключений становится больше, весь выигрыш в скорости съедается ручным разбором. Базовый уровень по всем четырём — ваши собственные значения за квартал до пилота.
Деньги, найденные сверкой. Это сумма расхождений между счетами и договорами, которую сверка нашла за квартал. Если раньше сверяли выборочно, база честно равна нулю — и любая найденная сумма видна сразу.
Качество закрытия. Здесь два показателя. Доля проводок, которые пришлось исправлять уже после закрытия периода, считается по журналу корректировок; база — среднее за три закрытия до пилота. И время, которое контролёр тратит на управленческий комментарий к отчёту; база — его фактические трудозатраты за последний цикл.
Быстрый старт
План на следующие 90 дней:
Шаг 1. Выберите один процесс с высоким объёмом и понятным контролем: ввод счетов или сверка с договорами. Владелец процесса — главный бухгалтер или руководитель казначейства, не ИТ.
Шаг 2. Замерьте базовый уровень: стоимость и время обработки документа, доля ручных касаний, число исключений. Без этого замера эффект потом нельзя будет доказать.
Шаг 3. Соберите обучающий и проверочный набор: 300–500 документов, включая нетипичные. Согласуйте с ИТ-безопасностью контур обработки: своя инфраструктура или российское облако.
Шаг 4. Запустите режим «двойного контроля»: модель предлагает распознанные реквизиты и проводку, сотрудник подтверждает. Фиксируйте каждое исправление — это данные о качестве.
Шаг 5. Сверьте KPI с базовым уровнем и решите, для каких типов документов допускается автоматическое проведение, а для каких сохраняется подтверждение. Решение о масштабировании принимается по доле исключений, а не по доле автоматизации.
Порядок «сначала помощник, потом автономная обработка» экономит деньги. Как показал кейс 11, прототип сверки можно собрать за несколько недель — короткий цикл уместен и для меньших компаний.
Важно!
· Оцифруйте договоры и приведите справочники в порядок до запуска модели: без этого сверка условий не работает.
· Определите перечень операций, где решение остаётся за человеком, со ссылкой на статью 16 152-ФЗ.
· Каждая цифра и ссылка в исходящем документе сверяется с первоисточником до отправки.
Данные и технологии
Хорошая новость: финансам с ИИ не нужно ничего, чего нет в приличной бухгалтерии. Нужны электронный архив первичных документов, справочники контрагентов и номенклатуры, реестр договоров с условиями в машиночитаемом виде, реестр расходов за 12–24 месяца и права доступа по ролям. Вопрос только в том, в каком всё это состоянии.
Эффект здесь даёт машиночитаемый учёт, а не модель. В ту же сторону бизнес подталкивает и государство: с 1 января 2026 года налоговый мониторинг применяется к 870 компаниям из более чем 20 отраслей, и свыше 70% участников подключены к АИС «Налог-3» с бесшовным обменом данными [173]. Когда налоговая получает данные прямо из учётных систем, хранить договоры в папке со сканами становится как-то неловко.
Технически всё сводится к одной связке: канал, по которому приходят документы (ЭДО, почта, сканер), учётная система и хранилище отчётности. С договорами звеньев больше. Пока условия лежат в PDF, модели попросту не с чем сверять счёт.
Для категоризации затрат главное — история расходов. В одном крупном европейском финансовом институте затраты разложили на четыре уровня и около 400 подкатегорий, и это снизило расходы примерно на 10% от многомиллиардной базы косвенных закупок [89]. Без истории такую классификацию строить не на чем.
Риски и роль человека
В финансах ошибка модели стоит денег, а иногда и репутации того, кто подписал отчёт. Рисков, о которых стоит договориться заранее, пять.
Персональные данные. Они есть в счетах, авансовых отчётах и выплатах физлицам. Отправить их в ИИ-сервис — значит обрабатывать их со всеми требованиями 152-ФЗ, включая хранение в России. Штрафы за нарушения мы собрали в карте рисков главы 29 [17].
Автоматические решения о людях. Часть 1 статьи 16 152-ФЗ запрещает принимать решения с юридическими последствиями для человека только на основе автоматизированной обработки его персональных данных. Исключения — письменное согласие или прямое указание закона. Оператор при этом обязан разъяснить порядок такого решения и рассмотреть возражение в течение 30 дней [168]. Поэтому отказ в выплате, удержание или блокировку расхода сотрудника всегда решает человек.
Регулируемая отчётность. В отчётности и аудите ответственность с моделью не делится. Американский регулятор аудита PCAOB уже обсуждает сценарий, в котором ИИ проверяет 100% проводок вместо выборки [106], но требования к аудиторским доказательствам от этого мягче не становятся. Рынок пока больше пробует, чем внедряет: в опросе 1 800 организаций почти три четверти уже применяют ИИ в финансовой отчётности, но широко — лишь 10% [81].
Галлюцинации в текстах. Во что обходится непроверенная ссылка в аналитическом документе, хорошо показывает кейс Deloitte Australia [47]. Правило простое: каждая цифра и ссылка в исходящем документе сверяется с первоисточником.
Вендорские цифры. На российском рынке они впечатляют. В Сбере более 700 ИИ-инициатив и около 900 автономных агентов с эффектом свыше 475 млрд рублей, из них более 50 млрд — от генеративного ИИ. В Альфа-банке роботизированные процессы выполняют около 3,5 млн операций в месяц [172]. Но методику расчёта никто не раскрыл, так что это описание масштаба, а не норматив для вашего бизнес-плана.Что же остаётся людям? Бухгалтер перестаёт набивать реквизиты и отвечает за исключения, чистоту справочников и проводки по спорным операциям, а финансовый контролёр — за то, как читать цифры. Так же смотрит на дело и государство как заказчик: в бюджетном процессе ИИ-агент на базе GigaChat должен снизить нагрузку на специалистов до 70%, но «последнее слово всегда будет за человеком» [156]. Да и подпись под отчётом модель за вас не поставит.
Bepul matn qismi tugad.