
Kitobni o'qish: «Психометрика в EdTech. Первые шаги. Инструменты для методистов, аналитиков, исследователей и продакт-менеджеров в образовании»
Научный редактор Инна Антипкина
Все права защищены. Никакая часть данной книги не может быть воспроизведена в какой бы то ни было форме без письменного разрешения владельцев авторских прав.
© Оформление. ООО «МИФ», 2025
* * *
Моим родителям
Предисловие
Современные технологии искусственного интеллекта прокладывают путь к будущему образования, где обучение становится по-настоящему доступным и персонализированным. Однако в центре всех изменений всегда остается человек – ученик и учитель, студент и преподаватель.
Психометрика, наука о педагогических и психологических измерениях, становится той линзой, которая помогает взглянуть на данные глубже, превращая обезличенные логи в отражение реальных историй, целей и усилий. За каждым байтом данных скрывается человек. Психометрика позволяет понять, как люди учатся: какие стратегии они выбирают, как преодолевают трудности, что их вдохновляет и мотивирует.
Например, в Практикуме мы применяем психометрические подходы для анализа поведенческих паттернов, разработки адаптивных методов обучения и поддержки студентов на их образовательном пути. Это не просто оцифровка процессов, это способность увидеть, понять и поддержать каждого студента, помогая ему создать свою уникальную историю успеха. Технологии усиливают, а не заменяют человеческую эмпатию и взаимодействие.
Образованию будущего нужна среда, где технологии становятся инструментами поддержки человеческих усилий. Пространство, где преподаватели вдохновляют на развитие, а студенты становятся активными творцами своего пути. В этом контексте психометрика – это не просто наука, а гуманистический инструмент, превращающий данные в ресурс для раскрытия человеческих возможностей и создания осмысленного обучения.
Дарья Золотухина, руководитель направления Образования, развития талантов и технологий для общества в Яндексе
От научного редактора
Если вы когда-либо слушали выступление Димы Аббакумова, то знаете, как понятно и весело он умеет подать любую тему. Если же вы с Димой не встречались, то по тексту этой книги поймете, что автор поставил себе задачу – описать базу психометрической аналитики наиболее простым и прикладным образом; и автор задачу выполнил.
Приведу только одну деталь: в первом варианте рукописи Дима снабдил все представленные метрики математическими формулами, заботливо их аннотировал, описал все буковки-индексы простым и понятным языком. А потом одним махом все формулы в тексте снес. Я сначала удивилась такому решению, а потом восхитилась смелости: и правильно, в мире столько продактов и методистов с математической тревожностью – зачем их пугать. А тем, кому от формул не страшно, все станет ясно из приведенного кода.
Скорее всего, после прочтения книги у вас появится вопрос: «Все же так просто! Наверное, психометрическую аналитику (не путайте ее с учебной аналитикой) применяют во всем EdTech, во всех онлайн-курсах?» Но нужно знать условия работы бизнеса, чтобы понять: нет, не просто, далеко не во всех. Психометрика – все еще экзотическая наука в России. Цифровые образовательные продукты создаются быстро («раз, два – в продакшен»). То, что разношерстные команды Яндекс Практикума – продакты, методисты, разработчики – заговорили на общем языке психометрической аналитики, кажется мне волшебством. А чтобы придумать подходящие формату продукта метрики (а ключевые метрики в этой книге – посильность, супербалл, дельта – далеко не общепринятые, Дима их сам придумал, проверил их полезность, связал с бизнесовыми метриками), нужны креативность, смелость и приверженность доказательному подходу. Не просто ввести метрику в систему, а доказать, что она полезна для студентов, для продукта, для развития бизнеса. Не обманывайтесь кажущейся простотой текста.
Как научный редактор я докапывалась до каждой главы, требуя обоснований, но как первый читатель хотела больше практической информации. Поэтому иногда подавала автору противоречивые сигналы. Например, просила: «Дима, приведи, пожалуйста, референсные значения для этой метрики – пусть из твоей практики, но чтобы у читателя был ориентир. Но только уточни там, что это не бронзой на граните высечено, пусть понимают, что в их продукте оптимальные значения метрики могут быть не такими, как в твоей практике». И Дима очень честно все описывал и предупреждал. Я слегка в шоке, что Яндекс Практикум так открыто делится полезностями. Но кто мы такие, чтобы не поддержать принципы открытой науки?;)
Психометрика – чудесная наука, она за справедливость и пользу оценивания. В ней много спорного и трудного, но с этой книгой ваши первые шаги в психометрической аналитике для EdTech точно будут уверенными.
Инна Антипкина, доцент, старший научный сотрудник Центра психометрики и измерений в образовании Института образования НИУ ВШЭ, руководитель проектно-учебной лаборатории моделирования и оценивания компетенций в высшем образовании
От автора
Последние пять лет мы наблюдаем динамичный рост EdTech. В широком смысле EdTech – это область, связанная с применением технологий для улучшения образования в целом, к которой относятся:
• онлайн-курсы;
• мобильные приложения;
• тренажеры и симуляторы;
• системы управления обучением и электронные журналы;
• программы управления контентом;
• инструменты виртуальной и дополненной реальности;
• технологии персонализированного обучения и многое другое.
Однако чаще (в более привычном нам смысле) аббревиатура EdTech ассоциируется со сферами бизнеса, в которых студенты заходят на веб-сайт или в мобильное приложение и получают там новые знания. Этот бизнес может быть большим и малым. Примерами большого бизнеса являются Яндекс Практикум, DataCamp, Duolingo и многие другие компании в России1 и за рубежом2. К малым можно смело отнести индивидуальных онлайн-преподавателей и небольшие онлайн-школы, применяющие образовательные технологии в своей практике. На такие малые и большие сферы применения EdTech я ориентируюсь в этой книге. Кроме того, рассчитываю, что и более широкому кругу читателей из сфер образования и обучения эта книга окажется полезной.
В EdTech любят метрики и используют их на самых разных уровнях управления бизнесом. Например, метрика рентабельности ROI (Return on Investment) помогает понять, окупились ли расходы на создание, рекламу и проведение курса, а метрика ROMI (Return on Marketing Investment) показывает, насколько хорошо работают используемые маркетингом инструменты для привлечения студентов на курс. Метрика количества уникальных пользователей представляет текущий объем аудитории курса и позволяет отследить динамику этой аудитории во времени, а LTV (Lifetime Value) – сколько прибыли приносит отдельный студент за все время взаимодействия с EdTech-провайдером.
Существуют метрики удовлетворенности и лояльности студентов. Например, CSI (Customer Satisfaction Index) говорит о том, доволен ли студент обучением в целом или его отдельными аспектами, NPS (Net Promoter Score) – готов ли студент рекомендовать конкретный курс своим знакомым и друзьям, a метрика реферальности – сколько новых студентов приходят благодаря рекомендации обучающихся в данное время студентов.
Для оценки качества обучения обычно используют метрики COR (Completion Rate), или «доходимость», которая показывает долю студентов, успешно завершивших обучение, и Transformation (или Success) Rate, которая отражает степень уверенности студента в том, что цели его обучения достигнуты. Наконец, как и любому бизнесу, EdTech важно изучать долю и причины возвратов, для чего используется соответствующая метрика. Приведенный список, безусловно, неполный, но он отлично иллюстрирует, как важны метрики и работа с ними для современного образовательного бизнеса.
Главная ценность упомянутых метрик заключается в том, что они делают бизнес видимым и, следовательно, управляемым. Однако парадокс заключается в том, что в них отлично выражена бизнес-составляющая, но практически отсутствует составляющая образовательная. Другими словами, показывают ли нам указанные метрики, работает или нет учебный контент и насколько хорошо он это делает; осваивают ли студенты желаемое и насколько уверенными они могут быть в этом; оптимальны ли формат обучения и учебная нагрузка и, собственно, происходит ли обучение в самом деле? Едва ли. Разве что косвенно. Получается, собственно обучение – то, на основе чего строится EdTech-бизнес, – остается скрытым, а значит, неуправляемым.
При этом наука, которая уже полтора века измеряет обучение и помогает настраивать его на студентов, есть. Она называется психометрика и дает прямые ответы на вопросы о студентах, контенте и их взаимодействии. Подтверждения этому мы с вами найдем на страницах этой книги, а пока поверьте мне на слово. Но, собственно, почему вы должны мне поверить?
Самое время представиться. Меня зовут Дмитрий Аббакумов. Двадцать лет назад я «завалил» промежуточные тесты на первом курсе университета. К счастью, они были экспериментальными, и нас, заваливших, тогда не отчислили. Однако после этого провала я решил разобраться в том, как работают инструменты измерения и оценки знаний, почему они бывают хорошими и плохими (как было в случае с моим университетским опытом) и чем хорошие отличаются от плохих. Так я познакомился с наукой психометрикой: сначала прошел обучение в лаборатории «Гуманитарные технологии» при МГУ им. М. В. Ломоносова, затем учился на первом потоке студентов единственной в России магистерской программы по психометрике «Измерения в психологии и образовании»3 в НИУ «Высшая школа экономики», а впоследствии получил докторскую степень по психометрике в одном из сильнейших университетов мира – KU Leuven, Бельгия. Вот куда завел меня тот заваленный в университете тест. После защиты диссертации я вернулся в Россию, и здесь один из основателей Практикума, Михаил Янович, пригласил меня присоединиться к команде. В Практикуме я сфокусировался на измерении и исследовании того, как учатся наши студенты, как работают тренажеры и микротеория и как через улучшение учебного опыта повышать шансы студентов на успех и наращивать результаты образовательного бизнеса. В течение трех лет моей работы в российском Практикуме и его международном подразделении, впоследствии ставшем самостоятельным бизнесом под названием TripleTen, психометрика стала ядерной технологической компетенцией и одним из ключевых элементов успеха этого бизнеса. В это время я выступал с открытыми лекциями и преподавал на программах School of Education – без преувеличения, кузницы кадров российского EdTech. Мне искренне хотелось (и хочется сейчас) сделать так, чтобы психометрика помогла большему количеству образовательных проектов. Так в конце 2023 года появилась идея написать книгу о психометрике в EdTech.
В этой книге вы узнаете, что такое психометрика как наука и как приложить ее к EdTech-бизнесу; как правильно логировать данные, рассчитывать характеристики контента и студентов и другие важные (психо)метрики; как применять их для улучшения учебного опыта и результатов студентов и какой вклад работа с этими метриками вносит в образовательный бизнес. Книга неслучайно называется «Первые шаги»: она не только рассказывает о психометрическом подходе, но и содержит сниппеты вычислительного кода и практические упражнения с ключами, с помощью которых мы вместе сделаем эти первые шаги. А чтобы шагать было не страшно, а приятно, вы не встретите сложных формул. Я подробно объясняю вычисления в тексте, а затем дополняю пояснениями команды в сниппетах вычислительного кода. Кроме того, здесь много иллюстраций. Верю, что вам это понравится.
Однажды после одного из моих открытых воркшопов в School of Education участница Мария Коробова, которая преподает математику на российской платформе Stepik, поделилась со мной отзывом: «Я в восхищении от технологии и особенно от того, что она применима у меня на маленьком курсе. Спасибо вам огромное, что это придумали и что делитесь!» (Кстати, с метрикой «посильность», о которой говорит Мария, вы познакомитесь в одной из глав книги.) Она рассказала, что регулярно подсчитывает (психо)метрики для своего курса, вносит в него изменения и видит положительные результаты. Я вдохновляюсь такими отзывами и той пользой, которую психометрика приносит малым и большим EdTech, и надеюсь, что вы вдохновитесь вместе со мной и эта книга поможет вам максимизировать ценность ваших образовательных продуктов.
У книги есть соавторы: одна из глав написана совместно с Марией Ковалёвой и Николаем Кутковым, руководителем и исследователем лаборатории образовательных технологий Практикума, которая изучает образовательные технологии и оценивает их влияние на учебные результаты студентов Практикума. Сейчас, например, лаборатория исследует, как инструменты на основе YandexGPT помогают студентам лучше учиться.
Эта книга была бы невозможной без моего друга и научного редактора Инны Антипкиной. Инна – опытный психометрик, кандидат наук об образовании, активно преподает, разрабатывает инструменты оценивания и занимается исследованиями в Институте образования Высшей школы экономики.
Похоже, мы плавно перешли к благодарностям. Помимо горячей благодарности моим соавторам и редактору, хочу выразить особую признательность моей «литературной крестной» Анастасии Чуковской, которая заинтересовалась идеей книги, стала менеджером этого проекта, помогла довести начатое до результата и способствовала моему книжному дебюту. В лице Анастасии я благодарю всех участников этого сложного производственного процесса – подготовки книги – со стороны Яндекса.
Отдельно хочу поблагодарить арт-директора Валентину Смирнову и иллюстратора Олесю Ткач.
Я благодарю издательство МИФ и его сотрудников, работавших над книгой, за профессионализм и внимание к деталям, и лично ответственного редактора Анну Таривердиеву за теплую атмосферу партнерства.
Поскольку материал для книги не появился бы, если бы я не попал в Практикум (а затем в TripleTen), хочу поблагодарить всех коллег, кто поверил в силу моей любимой науки и помогал извлекать из психометрики пользу для наших студентов и EdTech-бизнеса: Михаила Яновича, Елену Швец, Виктора Ламбурта, Марка Сысоева, Анастасию Богапову, Марию Меркулову, Ингвара Сильницкого, Сергея Парфёнова, Льва Якимова, Мадина Тлишева и других.
Отдельную благодарность хочу выразить первым читателям и рецензентам книги: Оксане Власовой, Сергею Жданову, Дарье Кравченко, Веронике Кышовой и Асе Фурсовой – за ценные советы, уточненные формулировки и теплые слова поддержки.
Наконец, хочу сказать спасибо моему верному компаньону – мини-бультерьеру Финику.
31 июля 2024 года
Глава 1. Наука об измерении невидимого
Удобно, когда работаешь с чем-то осязаемым. Всегда можно оценить результаты своей работы: взвесить урожай яблок, подсчитать количество перевезенных пассажиров или позиций в товарном чеке. Сравнивая полученные значения, можно оценить, в каком году урожай был выше, в какое время суток люди чаще пользуются такси и какие товарные позиции лучше всего продаются, а на основании этих сравнений принимать взвешенные решения: выбрать более эффективное удобрение, спрогнозировать необходимое количество такси на линии, чтобы удовлетворить спрос и не спровоцировать простой, заранее в нужном количестве заказать хорошо продающийся товар.
Образованию в этом смысле повезло меньше: его основной продукт скрыт от непосредственного наблюдения. Невозможно, посмотрев на двух студентов, сказать, кто из них лучше знает предмет. Нет инструментов, которые, подобно весам или рулетке, покажут, каков запас знаний у человека. И даже если поместить его в дорогостоящий современный сканер, мы не узнаем, сколько информации в его голове.
Ученые и практики издавна предпринимают попытки измерить невидимое. В литературе можно проследить, что еще за 500 лет до нашей эры Конфуций (551–479 гг. до н. э.) делал первые «педагогические измерения»: наблюдал за учениками, их активностью и мотивацией – и сопоставлял полученные данные с их результатами. Вот, например: «Того, кто не стремится к достижению знания, не следует направлять на правильный путь. Тому, кто не испытывает трудностей в выражении своих мыслей, не следует помогать. Того, кто не в состоянии по одному углу предмета составить представление об остальных трех, не следует учить»4. Однако системно такими измерениями стали заниматься только во второй половине XIX века. А значит, именно в это время появились первые исследования и публикации о том, как измерять скрытые от непосредственного наблюдения педагогические и психологические характеристики так же легко и точно, как и физические величины (массу, длину, время).
В этом движении можно выделить два основных направления. Первое – это собственно измерение физических (наблюдаемых) величин учебного процесса. В лаборатории Вильгельма Вундта (1832–1920) в Лейпциге для измерений использовались самые различные инструменты – от простого таймера до тахистоскопа, суперсовременного в то время аппарата, позволявшего проецировать изображение в течение определенного времени, чтобы замерить, например, скорость распознавания этого изображения. На фотографии 1892 года Гуго Мюнстерберг (1863–1916), ученик Вундта, проводит исследование – выясняет, сколько времени студенты Гарвардского университета тратят на выполнение учебных заданий (рис. 1).
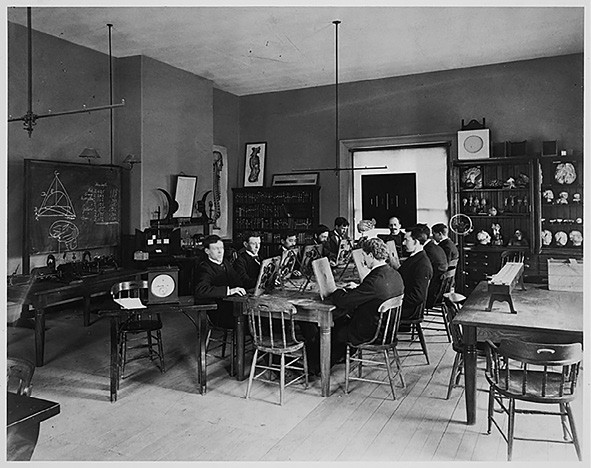
Рис. 1. Лабораторное измерение скорости решения заданий студентами5
Второе направление – представление ненаблюдаемого результата учебного процесса в качестве физической величины. Первым ученым, о ком важно упомянуть в этом отношении, является Фрэнсис Эджуорт (1845–1926). Его работа «Статистика экзаменов»6 (1888) – это, пожалуй, первая попытка выразить «знания» через физическую величину. Он пишет, что если несколько экспертов оценивают работу студента, то среднее значение оценок, выставленных за эту работу, можно считать истинным уровнем знаний этого студента. И добавляет, что отклонения оценок отдельных экспертов от полученного среднего можно считать ошибкой измерения. Так, среднее и ошибка – ключевые характеристики при измерениях физических величин (например, массы или длины) – впервые были приложены к ненаблюдаемой характеристике (знаниям). Можно сказать, эта работа дала старт первой метрике ненаблюдаемого.
Скоро приходит понимание, что использовать труд нескольких экспертов для оценки одного студента – ресурсоемкое мероприятие (особенно если требуется оценить несколько студентов). Так возникает идея, вместо того чтобы несколько экспертов оценивали одну работу, дать одному студенту несколько заданий, а затем подсчитать по полученным результатам те же показатели – среднее и ошибку. В итоге появляются первые тесты как наборы заданий одного содержания, которые активно использует в своей исследовательской работе другой ученик Вундта – американский психолог Джеймс Маккин Кеттелл (1860–1944).
На рубеже XIX–XX веков происходит интеграция первого и второго направлений: одновременно исследуются физические величины учебного процесса и измеряются ненаблюдаемые результаты. Российский профессор Александр Нечаев (1870–1948) изучает оптимальную продолжительность учебного времени, сопоставляя результаты обучения и длительность урока. Однако еще более важным является то, что Нечаев предпринимает первые попытки обобщить несколько мер ненаблюдаемого с помощью одного числа. Так, он вычисляет среднее значение между памятью учащихся на предметы, числа, звуки и слова, вводя условную общую характеристику памяти, а затем исследует (визуально, см. рис. 2), как отдельные виды памяти связаны между собой и какой вклад вносят в общую память.

Рис. 2. Ранние исследования памяти7
Британский ученый Чарльз Спирмен (1853–1945), анализируя, как студенты выполняют различные задания и тесты, обнаруживает, что результаты часто оказываются похожими: например, сильный студент хорошо справляется и с первым, и со вторым, и с третьим заданиями, тогда как слабый и в первом, и во втором, и в третьем случаях получает невысокий результат. Описывая свои наблюдения математическим языком, Спирмен выводит коэффициент корреляции (меру взаимосвязи между величинами), а затем понятие общего фактора – ненаблюдаемой величины, определяющей результаты и в первом, и во втором, и в третьем заданиях.
Работу Спирмена продолжает американский ученый Луис Тёрстоун (1887–1955), который продемонстрировал, что результаты выполнения очень большого количества самых разных по содержанию учебных заданий можно объяснить всего несколькими переменными. Например, если учащийся хорошо перемножает, складывает, делит и справляется со многими другими вычислительными операциями, это объясняется тем, что хорошо развитое умение считать является у него общей характеристикой, определяющей все успехи в вычислениях. Тёрстоун вводит обобщающие переменные: понимание речи, беглость речи, умение считать, пространственная визуализация, ассоциативная память, скорость восприятия и логические рассуждения – и называет их основными способностями человека. Важно отметить, что в ходе этих исследований Тёрстоун разработал новый статистический инструмент – факторный анализ, который по праву считается первым кирпичиком науки о данных (Data Science).
Общим в исследованиях Кеттелла, Нечаева, Спирмена, Тёрстоуна было то, что они преследовали цель с помощью одного числа обобщить большое количество отдельных учебных результатов. Это общее число можно назвать мерой, или метрикой, например, памяти, знаний или способностей. Память, знания или способности по своей сути являются ненаблюдаемыми (неосязаемыми) характеристиками. Чтобы измерить характеристики, нужно обеспечить им возможность как-то проявиться. Именно для этого Нечаев давал учащимся слова и через какое-то время просил их воспроизвести. Воспроизведение слов (в исследованиях Тёрстоуна – решение вычислительных задач) уже можно было пронаблюдать и подсчитать (например, 7 из 10 слов были воспроизведены правильно). Далее, чтобы на основании этих наблюдений создать общую метрику, следовало воспользоваться статистическим решением. Оно может быть простым, как у Нечаева (среднее по этим наблюдениям для каждого студента), или более сложным, как у Спирмена и Тёрстоуна (факторный анализ). В результате получаем число для каждого студента, характеризующее его невидимую характеристику.
Это и есть главный принцип психометрики как науки об измерениях невидимого: чтобы измерить невидимое, нужно дать ему проявиться через наблюдаемое поведение, а затем воспользоваться специальной статистической формулой для обработки результатов этих наблюдений и вычисления соответствующей метрики.
Слово «психометрика» упоминается уже со второй половины XIX века: Фрэнсис Гальтон (1822–1911) определял ее как «искусство присвоения чисел операциям разума» (1879), а диссертация Кеттелла, которую он защитил в 1886 году под руководством Вундта в Лейпциге, называлась «Психометрические исследования» (нем. Psychometrische Untersuchungen). Однако закрепление психометрики в качестве самостоятельного научного направления произошло значительно позднее, в 1935 году, когда Тёрстоун с коллегами основали международное Психометрическое общество и состоялась первая встреча этого общества, которые проходят ежегодно по настоящее время. С того момента (и публикации в самом влиятельном научном журнале мира Science, см. рис. 3) педагогика и психология были признаны как количественные рациональные науки – такие же, как естественные.

Рис. 3. Психология заявляет о себе как о количественной науке8
Психометрика зародилась на Западе, но и в России это направление также развивалось интенсивно, а исследования находились на переднем крае науки, о чем свидетельствует, в частности, то, что инструменты, изобретенные Нечаевым для изучения памяти, неоднократно получали премии на зарубежных психологических выставках, а его книги (например, «Современная экспериментальная психология в ее отношении к вопросам школьного обучения», 1901) нашли себе место в научных библиотеках Гарвардского и других ведущих западных университетов (см. рис. 4). Однако прискорбный исторический факт заключается в том, что в 1935 году, когда в США было создано международное Психометрическое общество, в России профессор Нечаев был репрессирован и сослан в Семипалатинск (Казахстан). А годом позднее, в 1936-м, педагогические измерения в России объявили не просто лженаукой, а извращением, и они были запрещены по всей стране. В науке об измерениях невидимого в России начался «ледниковый период», который продлился вплоть до начала XXI века. Хотя отдельные работы в области измерений все же велись, сфокусированы они были преимущественно на психологической диагностике, а не на педагогике; статистические же методы психометрики не разрабатывались вовсе.

Рис. 4. Штамп библиотеки Гарвардского университета на форзаце книги А. П. Нечаева
Однако вернемся к развитию науки об измерениях. В середине XX века (в 1947 году) вышла книга9 ученицы Тёрстоуна Дороти Эдкинс (1912–1975). Она рассказывала, как сделать так, чтобы задания, которые мы даем студентам, проявляли именно ту невидимую характеристику, которую мы хотим измерить. Другими словами, в этой книге приводится содержательная связка и даются инструменты для связывания невидимой характеристики с наблюдаемыми индикаторами. В 1958 году вышла другая значимая работа10 Эдкинс, в которой были представлены научно обоснованные рекомендации о том, как на основании педагогических измерений улучшать обучение – «настраивать» его на учащихся. С этого момента психометрику можно считать драйвером доказательного образования, основанного на данных, собираемых с помощью научных методов. (Да, да, доказательное образование появилось задолго до того, как о нем заговорили как о rocket science.)
Постепенно простые способы, такие как вычисление среднего, предложенное еще Эджуортом в 1888 году, были доработаны до полноценных психометрических теорий – сначала той, что сегодня известна как «классическая» (1940–1950-е), а позднее – современной (1960–1970-е). В фундаментальной книге «Статистические теории тестовых баллов»11 (1968) Фредерика Лорда (1912–2000) и Мелвина Новика (1932–1986) приводятся вычислительные обоснования валидности, точности и надежности измерений и закрепляется статистический аппарат для соответствующих метрик. Можно считать, что у науки об измерении невидимого появились глубокий и надежный фундамент и правила функционирования.
С усовершенствованием компьютеров и их вычислительных возможностей стали широко использоваться и развиваться более сложные математические подходы. Название «Современная теория тестирования» (Item Response Theory) объединяет большое количество математических моделей, предназначенных для оценки все тех же непосредственно ненаблюдаемых характеристик. Дальнейшее развитие психометрики связано с поиском и внедрением улучшений для второй части главного принципа – статистической обработки результатов наблюдений и вычисления соответствующих метрик. Ученые выясняют: а как быть с заданиями, где правильный ответ может быть частичным, – и возникает серия моделей, называемых политомическими. Ученые задаются вопросом: а что, если не одна, а совокупность невидимых характеристик определяет наблюдаемые результаты? Так появляются многомерные и когнитивные диагностические модели. Ученые исследуют, как время выполнения заданий уточняет метрику невидимого, – и здесь рождаются специальные модели с учетом времени ответа (response time). Ученые выясняют, как контекстная информация о студенте (например, возраст или учебная группа) и заданиях (например, тип задания или наличие иллюстрации) описывает и объясняет получаемые метрики. Наконец, прямо сейчас, в 2024 году, психометрические модели строятся как частный случай искусственных нейронных сетей автокодировщиков – бум искусственного интеллекта не обошел стороной измерения невидимого.
Направлений в современной психометрике десятки, а статистических моделей сотни: практически для каждого частного случая предложена новая модель, и каждый год появляются актуальные модели и решения. В 2024 году ежегодная конференция Психометрического общества, прошедшая 16–19 июля в Праге, собрала рекордные 570 участников из 40 стран мира. Каждый участник конференции либо представил улучшение существующих моделей, либо презентовал новую. Каждая предложенная модель имеет свои требования, допущения и ограничения, соответственно, приложение модели становится максимально сфокусированным на узкой задаче и специфичным с точки зрения контекста.
После десятилетий забвения этой темы работы по психометрике появились и в России. В книге «Теория и практика конструирования педагогических тестов» (2002) Марина Челышкова (1947–2022) раскрывает первую часть главного принципа психометрики: чтобы измерить невидимое, нужно дать ему проявиться через наблюдаемое поведение. В свою очередь, в книге «Моделирование и параметризация тестов: основы теории и приложения» (2008) Елена Карданова поясняет вторую часть этого принципа: статистическая обработка результатов наблюдений и вычисление соответствующих метрик. Значимость обеих книг заключается в том, что они обобщают западные разработки и представляют их на русском языке.
Важную роль в развитии науки в России сыграл Александр Шмелёв, автор книги «Практическая тестология» (2013), выступивший соорганизатором первого в нашей стране стандарта тестирования («Российский стандарт тестирования персонала», 2015), соавторами которого стали 15 крупных ученых и практиков. Каждый год появляются десятки статей российских психометриков, в которых рассматриваются проблемы измерений или описываются новые тесты и проведенные с их помощью исследования.
Наука об измерении невидимого за полтора века существования стала очень сложной, и с позиции практики к ней объективно непросто подступиться. При этом ее польза для образования и EdTech неоспорима. В этой книге я рискнул дать базовый универсальный инструментарий, который, с одной стороны, будет прост для использования практически в любом EdTech-проекте, а с другой – останется в рамках науки, позволяющих обеспечивать качество получаемых измерений. Важно относиться к этой книге именно как к описанию первых шагов, которые помогут выстроить систему в больших и малых образовательных проектах и приведут к продуктовым результатам, таким как улучшение контента, учебного опыта и достижений студентов.
Глава 2. Инструменты и данные
С целью демонстрации вычислений в этой книге я выбрал язык программирования R – мощный инструмент для статистических вычислений и графики, созданный в 1993 году Россом Ихакой и Робертом Джентлменом. R быстро завоевал популярность и стал одним из наиболее востребованных инструментов статистического анализа и визуализации данных. Основные преимущества R заключаются в его обширной функциональности, огромном наборе доступных пакетов и активности сообщества пользователей, что делает его незаменимым для аналитиков данных. Несмотря на наличие альтернатив, таких как универсальный язык программирования Python, я остановился на R по двум причинам. Во-первых, R был изначально разработан для задач статистики и визуализации, что делает его более понятным и удобным именно для этих целей. Во-вторых, для новичков в области анализа данных R может оказаться более доступным благодаря своей узкой направленности на статистические задачи и логичному синтаксису. Таким образом, использование R в этой книге позволяет сосредоточиться на самом важном – вычислениях – и не отвлекаться на технические детали и настройки.
Другая особенность книги состоит в том, что я использую только один пакет R – библиотеку dplyr. Этот пакет, один из самых популярных, предназначен для манипулирования данными и предлагает интуитивно понятные и эффективные функции для работы с таблицами данных. Пакет разработан Хэдли Уикхэмом и его командой и представляет собой настоящую грамматику анализа данных. Будучи простым и интуитивно понятным, он оптимизирован для работы с большими наборами данных и обеспечивает высокую производительность. Функции dplyr – это все, что нужно для первых шагов. Например, функция filter() используется для отбора строк из данных, соответствующих определенным условиям. Это особенно полезно, когда необходимо выделить подмножество данных для анализа. Функция select() позволяет выбрать определенные столбцы из данных – это упрощает работу и дает возможность сфокусироваться на конкретных переменных. С помощью функции mutate() можно создавать новые столбцы или изменять существующие, чтобы добавлять новые переменные, основанные на имеющихся данных. Функция summarize() используется для агрегации данных, что позволяет вычислять различные статистики, такие как средние значения, суммы или медианы. С помощью функции arrange() можно сортировать строки в данных по значениям одного или нескольких столбцов. Это правда все, что нам нужно для первых шагов в психометрике.
И наконец, в этой книге мы используем для вычислений только реальные данные. Датасеты доступны для скачивания по ссылкам и QR-кодам, указанным в соответствующих главах. Данные представляют собой результаты выполнения студентами Яндекс Практикума заданий из трех вводных (бесплатных) онлайн-курсов по анализу данных, тестированию программного обеспечения (QA) и программированию. Задания разнообразны и содержат как квизы с выбором ответов, так и задачи онлайн-тренажера, где студенты самостоятельно вводят кодовое решение. В каждом из трех курсов я случайно выбрал по 250 студентов, проходивших обучение в период с августа 2023 года по январь 2024 года. Данные были анонимизированы и перекодированы в соответствии с современными стандартами и с использованием нескольких алгоритмов шифрования (md5, crc32, xxhash32, murmur32 и других).
Таким образом, несмотря на то, что наше погружение в анализ данных только начинается, мы делаем это основательно, уверенно и сразу по-настоящему.
Глава 3. Логируем учебные действия

Качество любой метрики зависит от качества данных, на основании которых эта метрика рассчитывается. В компьютерных науках существует концепция «мусор на входе – мусор на выходе», которая заключается в том, что некорректные (или «мусорные», то есть содержащие шум или ошибки) входные данные приводят к абсурдному результату. Рассмотрим несколько ситуаций, иллюстрирующих эту концепцию. Все примеры реальны и основаны на онлайн-тренажере по программированию, в котором студенты решают задачи, сопровождающиеся краткой теорией и встроенными подсказками, которыми можно воспользоваться по желанию. Задачи по содержанию объединены в блоки – уроки.
Ситуация 1. Система логирования данных фиксирует только общее количество (или долю) верно решенных студентом задач в уроке. Это очень ограниченный подход к логированию, так как он не фиксирует результаты решения отдельных задач. Аналитик, работающий с такими данными, видит, например, что студент решил 7 из 10 позиций. Однако это не дает информации о том, с какими именно задачами он не справился, соответственно, отсутствует возможность рассчитать трудность каждой. В результате методист, разрабатывающий курс, может сделать неверные выводы о том, какие задачи и связанная с ними теория нуждаются в доработке.
Ситуация 2. Представим, что система записывает информацию о решении студентом каждой задачи, при этом логирует только последнюю попытку, удаляя все предыдущие. В этом случае аналитик получает искаженную информацию, так как последние попытки в подавляющем большинстве случаев успешны. Такие данные скрывают реальную картину усилий студента, потому что мы не знаем, сколько попыток им было предпринято, прежде чем он нашел правильное решение. Это может ввести в заблуждение методиста, который, основываясь на полученных данных, может считать, что студенты с легкостью справляются с предложенными задачами, и, возможно, задумается о том, чтобы добавить задачи «со звездочкой».
Ситуация 3. Система логирует каждую попытку решения задачи, но не фиксирует использование студентами подсказок. Аналитик может интерпретировать успешные попытки как хорошее освоение материала, но такая интерпретация окажется искаженной и даже ложной. Методист, не имея информации о том, как студенты используют дополнительные ресурсы, не оценит их значимости в процессе обучения.
В каждом из этих примеров мы видим феномен «не то чтобы совсем “мусор на входе – мусор на выходе”», но «недостаточно тщательный подход к отбору данных на входе – возможные ошибки на выходе», и это происходит из-за недостаточности или неадекватности логированных данных. В первом случае, когда отслеживается только общее количество решенных задач, мы теряем информацию о сложности отдельных заданий и о том, с какими именно проблемами сталкиваются студенты. Во втором примере, фиксируя только последнюю попытку решения, упускаем из виду всю историю попыток и усилий, что создает ошибочное представление об обучении. В третьем случае, не учитывая использование подсказок, получаем искаженное представление об успехе студентов. Таким образом, в каждом из этих сценариев неполные или неадекватные данные ведут к неправильным или искаженным выводам, что влияет на качество разработки и оптимизации EdTech-продуктов.
Описанные ситуации подчеркивают критическую важность корректного логирования данных. Тщательное и всестороннее логирование не только помогает аналитикам получить адекватное представление об учебном процессе, но и обеспечивает методистов необходимой информацией для адаптации и улучшения курсов. Так мы можем сформулировать первый принцип: лог должен репрезентировать взаимодействие студента с образовательным продуктом. Это значит, что каждое учебное действие студента внутри продукта должно логироваться.
Минимальные учебные элементы и минимальные учебные действия
Для корректного логирования нужно определить минимальные (атомарные) учебные элементы внутри продукта. Что считается минимальным элементом? Например, одно задание в тесте. Почему этот элемент минимальный? Потому что тестовое задание одно, и оно цельно или неделимо. Другими словами, нет ничего более мелкого и при этом цельного. Минимальным учебным элементом является видеоролик или текстовый материал. Видеоролик и текстовый материал – целые и неделимые единицы контента. А вот урок, состоящий из одного видеоролика, одного текстового материала и трех тестовых заданий, минимальным учебным элементом назвать нельзя.
Для иллюстрации воспользуемся метафорой «яблоневый сад». Сад один, но он может быть рассмотрен как группа деревьев. Дерево – как совокупность веток. Каждая ветка – как набор листьев и плодов. Таким образом, лист и плод будут минимальными элементами. Конечно, мы можем увлечься и начать препарировать листья и плоды, а затем вооружиться микроскопом… Но все же образ чего-то минимально целого и, главное, здравый смысл остановят нас. Почему здравый смысл? Потому что поиск минимального элемента мы ведем в интересах методиста и студента, а для большинства учебных продуктов минимальными элементами будут одно задание и одна единица учебного материала в формате видео или текста.
Разобравшись с минимальными учебными элементами, можем определиться и с минимальными учебными действиями. Эта книга написана в большей степени для практиков образования, чем для академических исследователей. А практика любит простоту. Именно поэтому, исходя из простоты, минимальным учебным действием будем считать цельное взаимодействие студента с минимальным учебным элементом. Например, в случае тестового задания этим взаимодействием является выполнение этого задания (пока мы не говорим о правильности выполнения; об этом речь пойдет далее). В случае, когда рассматриваются текстовый материал и видеоролик, минимальными учебными действиями будут прочтение этого материала и просмотр ролика. Почему такой подход простой? Потому что мы можем однозначно ответить на вопрос о том, совершено ли студентом минимальное учебное действие: «Да, тестовое задание выполнено»; «Нет, видеоролик не просмотрен»; «Да, текстовый материал прочитан». Такой подход обеспечивает достаточность данных для дальнейшей психометрической работы.
Однако возникает вопрос: а разве нельзя прочесть половину текстового материала или просмотреть половину видеоролика? Конечно, можно. Для этого существуют более сложные подходы к логированию данных, фиксирующие, например, старт, паузу, возобновление, завершение взаимодействия с видеороликом или текстовым материалом. Такое тонкое логирование в настоящее время используется преимущественно в академических исследованиях: например, можно ли по положению курсора на экране оценивать, куда смотрит студент, чтобы не использовать трудоемкие айтрекеры. Но, учитывая практический, а не академический фокус этой книги, будем относить такое логирование к дополнительным возможностям.
Итак, мы разобрались с тем, что такое минимальные учебные элементы и минимальные учебные действия. И помним главный принцип: лог должен репрезентировать взаимодействие студента с образовательным продуктом. Теперь выясним, как корректно логировать минимальные учебные действия.
Отображение механик заданий в логах
Для корректного логирования нужно понимать, как устроено минимальное учебное действие в продукте, какова его механика. Начнем с самого простого случая: студент выполняет тестовое задание с одним верным вариантом ответа. Это минимальное действие предполагает только два исхода: верный либо неверный ответ. В табл. 1 представлено, как может выглядеть лог этого учебного действия.

Таблица 1. Лог, фиксирующий только верное или неверное выполнение студентом двух заданий. Длинный формат
Bepul matn qismi tugad.
