Kitobni o'qish: «Многопоточность на C++ через практику и замеры»
Как читать эту книгу
Эта книга — для разработчика, который уже пишет на C++, знает RAII, умные указатели и move-семантику, но с многопоточностью пока знаком на уровне «запустил std::thread, вроде работает». Цель — дойти до уровня, на котором вы проектируете конкурентные подсистемы, обосновываете решения цифрами и уверенно проходите senior-собеседования.
Правило книги: «так быстрее» подтверждается бенчмарком, «так безопасно» — тестом под ThreadSanitizer и рассуждением через happens-before. Весь код книги собран и проверен под ThreadSanitizer и AddressSanitizer; тесты сквозного проекта проходят десять прогонов подряд.
Как устроена глава: вступление; теория и практика с проверенным кодом; грабли с ревью; вопросы с собеседований; шаг сквозного проекта (что делаем, чем проверяем, что меряем); три задачи разной сложности с критериями самопроверки. Решения всех задач с разбором — в главе «Ответы к задачам» в конце книги.
Сквозной проект shardkv — in-memory key-value сервер, который за 14 шагов проходит путь от потока на соединение с гонкой данных до асинхронного сервера с вычислительным пулом, сбросом нагрузки, CI и журналом архитектурных решений. Два шага из четырнадцати — неудавшиеся эксперименты, и это осознанно: умение отказаться от красивой оптимизации, которая не прошла замер, — тоже навык сеньора.
Что нужно для примеров: GCC 14+ или Clang 18+ с -std=c++23, CMake 3.25+, Ninja; для глав 10–13 — Asio (standalone) и stdexec, проект скачивает их сам через FetchContent. Все цифры замеров сняты в контейнере с двумя виртуальными ядрами, где сервер и нагрузочный клиент делят процессор; на вашей машине абсолютные значения будут другими — прогоните бенчмарки сами, это часть обучения.
Для первой работы достаточно глав 1–7, лёгких и средних задач из них и проекта до шага 7. Остальное — путь к уровню senior.
Глава 1. std::thread, std::jthread и stop_token: как запустить поток и не вызвать std::terminate
«У меня локально работало». Последние слова перед инцидентом.
Поздравляю: вы решили заняться многопоточностью. Это примерно как решить заняться жонглированием, только вместо мячиков бензопилы, а зрители — ваши пользователи в продакшене.
Хорошая новость: запустить поток в C++ можно одной строкой. Плохая: уронить программу тоже можно одной строкой, причём той же самой. Эта глава о том, как запускать потоки так, чтобы они гарантированно завершались, не оставляли висячих ссылок и не превращали выход из программы в лотерею.
К концу главы вы:
— поймёте, что такое поток с точки зрения ОС и почему его не создают на каждый запрос;
— узнаете, почему деструктор std::thread вызывает std::terminate и почему detach() — это не решение, а отсрочка проблемы;
— научитесь передавать в поток аргументы и не терять их по дороге;
— освоите std::jthread и кооперативную отмену через stop_token;
— научитесь доставлять исключения из потока туда, где их могут обработать;
— напишете первый шаг сквозного проекта: TCP-сервер shardkv с потоком на соединение, который умеет корректно останавливаться.
Про примеры. Весь код в книге написан на C++23 и собирается GCC 14+ или Clang 18+ с флагом -std=c++23. Для вывода используется std::println из заголовка <print>. Каждый пример собран и прогнан под ThreadSanitizer и AddressSanitizer — иначе какой смысл.
1.1. Что такое поток и сколько он стоит
Процесс — это изолированная песочница: своё адресное пространство, свои открытые файлы, свои ресурсы. Поток — это поток выполнения внутри процесса: свой стек, свои регистры, свой указатель команд. А вот память, куча, глобальные переменные и файловые дескрипторы у всех потоков процесса общие.
Именно в этом «общие» и кроется вся сила многопоточности и вся её боль. Потоки могут работать с одними данными без копирования. И точно так же они могут одновременно эти данные испортить.
В Linux std::thread — это обёртка над pthread, а pthread — над системным вызовом clone. Когда вы создаёте поток, происходит следующее:
— ядро выделяет структуру задачи и регистрирует её в планировщике;
— резервируется стек (в Linux по умолчанию 8 МБ виртуальной памяти, физическая выделяется по мере использования);
— создаётся локальное хранилище потока (thread_local);
— планировщик решает, на каком ядре и когда поток начнёт работать.
Давайте не верить на слово, а померить:
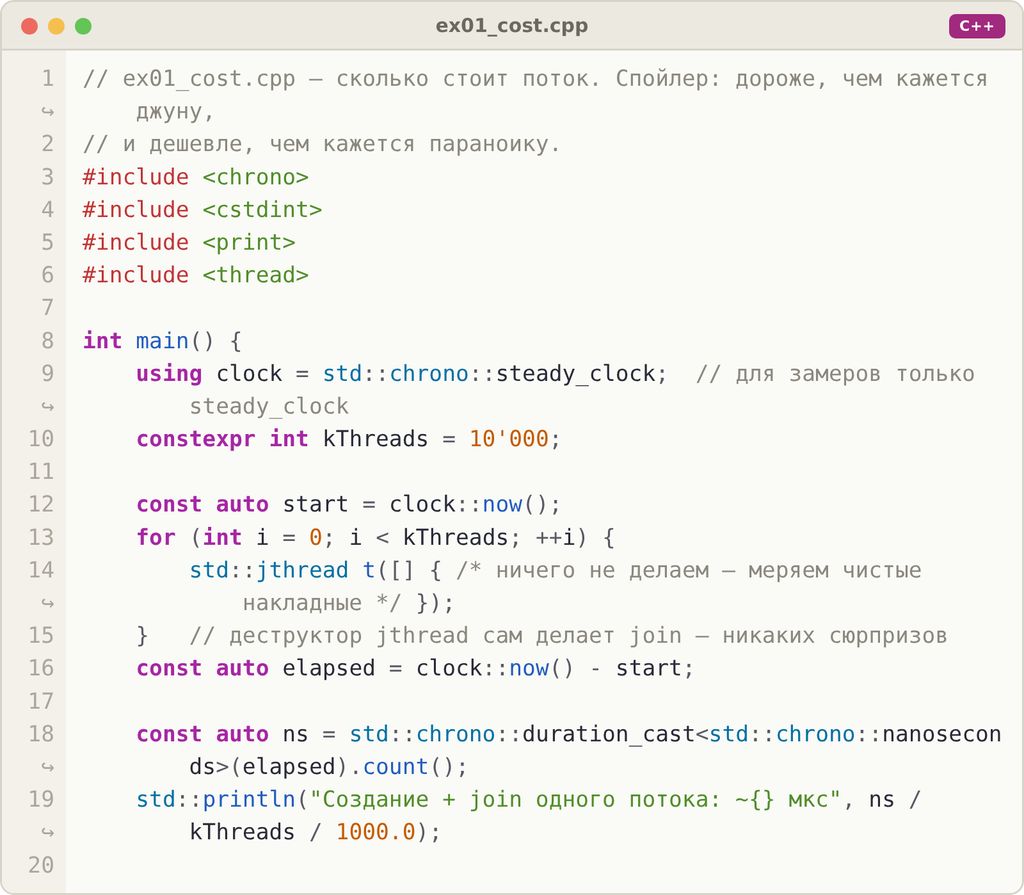
Листинг 1.1 — сколько стоит поток (ex01_cost.cpp)
На моей машине в release-сборке получилось около 55 мкс на поток. На голом железе с хорошим ядром будет от единиц до десятков микросекунд. Кажется, немного? Вызов пустой функции стоит около наносекунды. Поток дороже в десятки тысяч раз.
Отсюда первое правило: потоки не создают на каждый чих. Если сервер на каждый запрос создаёт поток, при нагрузке он будет тратить время не на работу, а на создание и уничтожение потоков. Правильный ответ — пул потоков, мы напишем его в главе 7. А пока, для учебного сервера, поток на соединение — нормальная отправная точка.
Второе правило: потоков полезно иметь примерно столько, сколько ядер. std::thread::hardware_concurrency() вернёт число аппаратных потоков, но это подсказка, а не гарантия: функция имеет право вернуть 0, если не знает. Если вычислительных потоков больше, чем ядер, они не ускоряют работу, а толкаются за процессорное время, и каждый переключатель контекста стоит микросекунды.
1.2. join, detach и std::terminate
Создать поток просто: передаём в конструктор std::thread что-нибудь вызываемое. Дальше у вас есть ровно два варианта, и выбрать один из них нужно обязательно:
— join() — дождаться завершения потока;
— detach() — отпустить поток, он будет работать сам по себе, и вы больше не можете его дождаться.
А если не выбрать ни один?
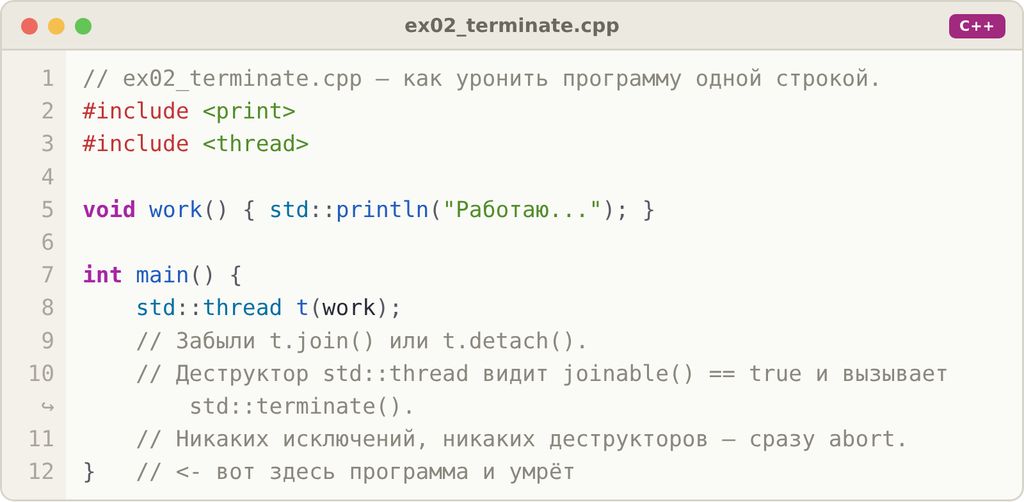
Листинг 1.2 — как уронить программу одной строкой (ex02_terminate.cpp)
Программа упадёт через std::terminate. Это не баг стандартной библиотеки, это осознанное решение. Объект std::thread, у которого joinable() == true, представляет живой поток. Если такой объект разрушается, у деструктора есть три варианта: дождаться потока (а вдруг он вечный, и программа зависнет), отпустить поток (а вдруг он работает с локальными переменными, которые сейчас умрут) или убить программу. Комитет выбрал третий: громкая смерть лучше тихого UB.
Почему detach() — почти всегда ошибка
Джун, впервые увидевший terminate, обычно делает так: «а, нужно вызвать detach, и всё заработает». Работать действительно начинает. До первого инцидента.
После detach() у вас нет никакого способа узнать, когда поток закончил работу. А значит, нет способа гарантировать, что всё, к чему поток обращается, ещё живо:
— локальные переменные функции, которая создала поток, умрут при выходе из неё;
— объект, чей метод запущен в потоке, может быть уничтожен владельцем;
— при выходе из main разрушаются глобальные и статические объекты, а отпущенный поток продолжает ими пользоваться (подробности в разделе 1.9).
Это классический use-after-free, только с отложенным действием и проявляется он «иногда». Под нагрузкой. В пятницу.
У detach есть законные применения, но их мало: поток, который не обращается ни к чему, кроме собственных данных, переданных по значению, и время жизни которого вам действительно безразлично. На практике это редкость. Правило для ревью: каждый detach() в коде требует письменного обоснования, почему все используемые данные переживут поток.
1.3. Исключения и join: почему «просто не забыть» не работает
Хорошо, договорились: всегда вызываем join(). Но посмотрите на этот код:


Листинг 1.3 — почему «просто не забыть join()» не работает (ex03_exception_join.cpp)
В функции bad() между созданием потока и join() есть код, который может бросить исключение. Исключение начинает раскрутку стека, деструктор std::thread видит живой поток и вызывает terminate. Исключение, которое можно было бы аккуратно обработать, превращается в падение программы.
Можно, конечно, обложить всё try/catch и звать join() в каждой ветке. Но мы пишем на C++, а в C++ ресурс, который нужно освободить, отдают RAII-объекту. Поток — тоже ресурс.
1.4. std::jthread: поток, который умеет за собой убирать
В C++20 появился std::jthread («joining thread»). Его отличия от std::thread:
— деструктор не вызывает terminate, а сначала просит поток остановиться (request_stop()), затем делает join();
— у него встроенный механизм кооперативной отмены: std::stop_source и std::stop_token;
— если первый параметр функции потока имеет тип std::stop_token, jthread сам передаст туда свой токен.
Функция good() из предыдущего примера использует именно jthread. Исключение летит дальше, а поток корректно дожидается в деструкторе. Никаких terminate.
Правило книги, которое будет действовать до последней главы: по умолчанию используйте std::jthread. std::thread оставьте для случаев, когда вам действительно нужно поведение «terminate, если забыли» (почти никогда) или вы работаете со старым стандартом.
Одна тонкость: join в деструкторе означает, что деструктор может ждать. Если поток не проверяет запрос остановки, деструктор jthread будет ждать вечно. Программа не упадёт, а зависнет, и это тоже плохо, поэтому потоки должны уметь останавливаться (раздел 1.6).
1.5. Передача аргументов: копии, ссылки и ловушки
Аргументы конструктора потока копируются (точнее, проходят decay-copy) во внутреннее хранилище потока в том потоке, который его создаёт. Потом новый поток вызывает функцию, передав ей эти копии как rvalue. Из этого следует несколько неочевидных вещей.


Листинг 1.4 — как аргументы попадают в поток и где они теряются по дороге (ex04_args.cpp)
Ссылки не передаются неявно. Если функция принимает std::vector<int>&, передать туда вектор просто так нельзя: копия — это rvalue, и к неконстантной ссылке она не привязывается. Код не скомпилируется, и это хорошо. Если вы действительно хотите ссылку, оборачиваете в std::ref и тем самым берёте на себя обязательство, что объект переживёт поток.
Неявные преобразования случаются в новом потоке. Если функция принимает const std::string&, а вы передаёте char*, сам указатель скопируется сразу, а превращение в std::string произойдёт позже, уже внутри нового потока. Если к этому моменту буфер умер (например, функция-создатель вернулась, а поток был отпущен через detach), вы получите строку из мусора. Лечение: конвертируйте явно, до передачи в поток.
Move-only типы перемещаются. std::unique_ptr передаётся через std::move — и это лучший способ отдать потоку владение данными: если поток владеет данными, никто не может уничтожить их раньше времени.
Лямбды с захватом по ссылке — это обещание. Захват [&] читается приятнее всего, но означает ровно то же, что std::ref: «я гарантирую, что всё это переживёт поток». С jthread в той же области видимости обещание выполняется автоматически: деструктор jthread сработает раньше, чем захваченные переменные, объявленные до него. Порядок объявления здесь не случаен — к этому мы вернёмся в задаче 1.3.
1.6. Кооперативная отмена: stop_token, stop_source, stop_callback
Первое желание новичка — «убить поток снаружи». В C++ такой возможности нет, и это правильно. Поток, убитый посреди работы, может держать захваченный мьютекс, недописанный файл, наполовину изменённую структуру данных. После такой операции вся программа находится в неизвестном состоянии.
Поэтому в C++ поток просят остановиться, а он сам решает, в какой точке это безопасно. Механизм состоит из трёх частей:
— std::stop_source — «кнопка». Метод request_stop() нажимает её. Нажать можно один раз, это необратимо.
— std::stop_token — «лампочка», которую выдаёт stop_source через get_token(). Поток спрашивает stop_requested() и узнаёт, нажата ли кнопка. Токены дешёво копируются, и все они смотрят на одну кнопку.
— std::stop_callback — «реакция на нажатие». Регистрирует функцию, которая будет вызвана при запросе остановки.
У каждого jthread есть свой stop_source. Его токен приходит в функцию потока первым параметром, если она его принимает:


Листинг 1.5 — кооперативная отмена (ex05_stop.cpp)
Обратите внимание на три детали.
Проверка флага работает только для потоков, которые не спят. Цикл while (!st.stop_requested()) хорош, пока поток крутится и периодически возвращается к проверке. Но если поток заблокирован в системном вызове (ждёт данные из сокета в recv() или клиента в accept()), он флаг не проверит, пока вызов не вернётся. А вернуться он может через час. Вот тут и нужен stop_callback: в нём можно разбудить блокирующую операцию — закрыть сокет на чтение, отменить ввод-вывод, разбудить condition variable (глава 3). Именно так работает остановка в нашем сервере.
Где выполняется stop_callback. Колбэк вызывается в том потоке, который вызвал request_stop(), а не в потоке, который ждёт. Если на момент регистрации остановка уже запрошена, колбэк выполнится сразу, в конструкторе stop_callback. Деструктор stop_callback подождёт, если колбэк прямо сейчас выполняется в другом потоке. Эта гарантия нам ещё пригодится.
Один stop_source может управлять многими потоками. Во второй части примера два потока получают токены от одного источника и останавливаются одной командой. Это стандартный приём для сервисов: одна кнопка «стоп» на все рабочие потоки.
1.7. Исключения в потоке
Если исключение вылетает из функции потока наружу, вызывается std::terminate. Поймать его в main нельзя: у каждого потока свой стек, и раскрутка стека одного потока не может «перепрыгнуть» в другой.
Значит, исключение нужно перевезти. Для этого есть std::exception_ptr — указатель, который может хранить исключение любого типа:
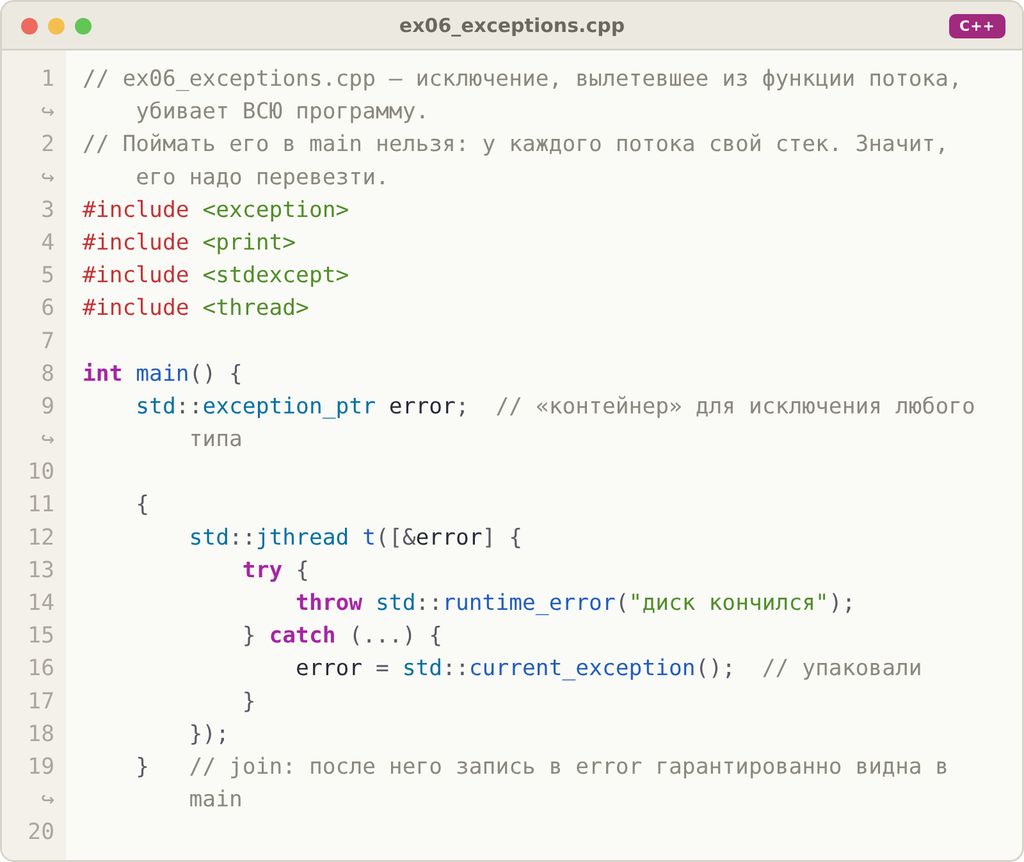

Листинг 1.6 — исключение, вылетевшее из функции потока, убивает всю программу (ex06_exceptions.cpp)
Внутри потока ловим всё через catch (…), упаковываем через std::current_exception(), а в вызывающем потоке после join() распаковываем через std::rethrow_exception(). Почему после join()? Потому что join() гарантирует, что всё, что сделал поток, видно потоку, который его дождался. Без этой гарантии чтение error в main было бы гонкой данных. Формально это отношение называется happens-before, и в главе 5 мы разберём его досконально.
В главе 7 то же самое за нас будет делать std::future, но полезно один раз сделать это руками, чтобы понимать, что происходит внутри.
1.8. thread_local и hardware_concurrency
Переменная с thread_local существует в отдельной копии для каждого потока. Каждый поток видит и меняет только свою копию, поэтому гонок на ней не бывает:

Листинг 1.7 — у каждого потока своя копия переменной (ex07_thread_local.cpp)
Где это полезно: счётчики и статистика по потокам (сливаем в общий итог редко), кеши и буферы, которые дорого создавать на каждый вызов, генераторы случайных чисел (std::mt19937 не потокобезопасен, а заводить мьютекс ради rand — грустно).
Где это опасно: копия создаётся для каждого потока, и с пулом из 64 потоков «маленький кеш на 10 МБ» внезапно становится 640 МБ. И деструкторы thread_local-объектов выполняются при завершении потока, то есть у отпущенного через detach потока — неизвестно когда.
1.9. Завершение программы при живых потоках
Вот сценарий, который ломает программы, считающиеся рабочими годами. Поток отпущен через detach() и пишет в лог через глобальный объект-логгер. main() возвращает управление. Что происходит дальше:
— возврат из main эквивалентен вызову std::exit();
— std::exit() запускает деструкторы статических и глобальных объектов, в том числе вашего логгера;
— отпущенный поток в это время продолжает работать и вызывает методы уже разрушенного логгера;
— в лучшем случае программа падает при выходе, в худшем — портит данные, которые успела записать на диск.
Самое неприятное: это проявляется не всегда, а только когда поток не успел закончить до выхода. На машине разработчика он успевает. В продакшене под нагрузкой — нет.
Что можно сделать:
— Правильно: все потоки завершаются до выхода из main. Владелец потоков (обычно какой-то сервис) останавливает их через stop_token и дожидается в деструкторе. С jthread это получается само собой.
— Аварийно: std::quick_exit() завершает программу без деструкторов статических объектов (выполняются только функции, зарегистрированные через std::at_quick_exit). Это способ выйти, когда корректная остановка невозможна, а не способ лечить архитектуру.
— Никогда: надеяться, что «поток успеет».
1.10. Грабли с ревью
Список того, что я регулярно встречаю в pull request'ах. Каждый пункт — повод для комментария «Request changes».
— detach() без обоснования. Почти всегда означает «я не знаю, как остановить этот поток».
— std::thread в коде на C++20. Используйте std::jthread, если нет конкретной причины.
— Захват [&] в лямбде потока, который живёт дольше текущей области видимости. Особенно в циклах: счётчик цикла, захваченный по ссылке, — классическая гонка.
— Поток, который нельзя остановить. Бесконечный цикл без проверки stop_token или блокирующий вызов без способа его разбудить.
— Исключения, вылетающие из функции потока. Это std::terminate, а не «обработается где-нибудь».
— sleep_for как способ синхронизации. «Подождём 100 мс, поток наверняка успеет» — не синхронизация, а надежда.
— Создание потока на каждый запрос. Работает на тестах, умирает под нагрузкой.
— Чтение результатов потока без join() или другой синхронизации. Это data race, даже если «там просто int».
1.11. Что спросят на собеседовании
Что произойдёт, если не вызвать join() или detach() у std::thread? (middle) Деструктор вызовет std::terminate. Объяснение «почему» ценится больше, чем сам факт: у деструктора нет безопасного способа решить, ждать или отпустить поток.
Чем std::jthread отличается от std::thread? (middle) Деструктор делает request_stop() и join() вместо terminate; встроенная кооперативная отмена через stop_source/stop_token; автоматическая передача stop_token в функцию потока.
Как остановить поток? (middle) Только кооперативно: поток периодически проверяет stop_token или его будят через stop_callback. Убить поток снаружи в стандартном C++ нельзя, и это правильно. Сильный ответ отдельно разбирает поток, заблокированный в системном вызове.
Почему detach() опасен? (middle) Нельзя узнать, когда поток закончится, а значит, нельзя гарантировать время жизни данных, которые он использует. Плюс проблема разрушения статических объектов при выходе из программы.
Как передать исключение из потока в вызывающий код? (middle) std::exception_ptr через std::current_exception()/std::rethrow_exception(), либо std::promise/std::future, которые делают то же самое.
Как передать в поток аргумент по ссылке и чем это опасно? (junior/middle) std::ref или захват по ссылке в лямбде. Опасно тем, что объект должен пережить поток. Бонус: рассказать про преобразование char* в std::string, которое происходит уже в новом потоке.
Сколько потоков стоит создавать? (senior) Для вычислительной работы — порядка hardware_concurrency(). Для работы с ожиданием I/O больше, но лучше асинхронный I/O (глава 10). Сеньор говорит «зависит от профиля нагрузки» и сразу объясняет, как это измерить.
Что произойдёт, если отпущенный поток работает в момент выхода из main? (senior) exit() разрушит статические объекты, пока поток ими пользуется: UB. Правильное решение — останавливать и дожидаться всех потоков до выхода.
1.12. Сквозной проект shardkv, шаг 1: поток на соединение
Пора писать сервер. Напомню: shardkv — in-memory key-value хранилище с текстовым протоколом в духе Redis. В течение книги оно пройдёт путь от наивной версии до архитектуры, которую не стыдно обсуждать на senior-собеседовании. На каждом шаге мы делаем, проверяем и меряем.
Что делаем на шаге 1:
— скелет проекта: CMake с пресетами debug, release, tsan, asan;
— однопоточное хранилище на std::unordered_map;
— протокол: PING, GET, SET, DEL, SETNX, INCR;
— TCP-сервер на блокирующих сокетах, по потоку std::jthread на каждое соединение;
— корректную остановку: сервер выходит, даже если клиенты подключены и молчат.
Что специально оставляем сломанным: хранилище не защищено от одновременного доступа. Несколько соединений одновременно меняют один unordered_map. Это data race, и в главе 2 мы начнём именно с того, что ThreadSanitizer его найдёт.
Что меряем: ничего. Мерить сломанный код рано.
Как устроена остановка
Это главная многопоточная часть шага. Поток сервера почти всё время висит в accept(), а потоки соединений — в recv(). Проверка stop_requested() в цикле их не разбудит. Поэтому:
— сервер регистрирует stop_callback, который вызывает shutdown() на слушающем сокете. В Linux это заставляет accept() вернуть ошибку, и цикл приёма заканчивается;
— у сервера есть собственный std::stop_source для соединений. Он срабатывает и когда остановку попросили снаружи, и когда accept() сломался сам по себе. Без этого при фатальной ошибке accept сервер вышел бы из цикла и навсегда завис бы в ожидании соединений, которые никто не разбудил;
— каждое соединение регистрирует свой stop_callback, который делает shutdown() своего сокета. recv() возвращает 0, цикл чтения заканчивается;
— объекты Connection хранят потоки соединений, и при выходе из run() все они дожидаются через деструкторы jthread.
Отдельно посмотрите на порядок объявления в serve(): stop_callback объявлен после сокета, а значит, разрушается раньше. Деструктор stop_callback подождёт, если колбэк выполняется в другом потоке. Поэтому shutdown() никогда не попадёт в уже закрытый дескриптор.
Ещё одна деталь: сервер убирает отработавшие соединения из списка (reap_finished). Флаг done читается из потока сервера и пишется из потока соединения, поэтому он std::atomic с порядками release/acquire. Что это значит, мы подробно разберём в главе 5, а пока примите как данность: без атомика это была бы ещё одна гонка.
Ключевой код
Заголовок сервера:


Листинг 1.8 — TCP-сервер shardkv, шаг 1 (server.hpp)
Реализация:
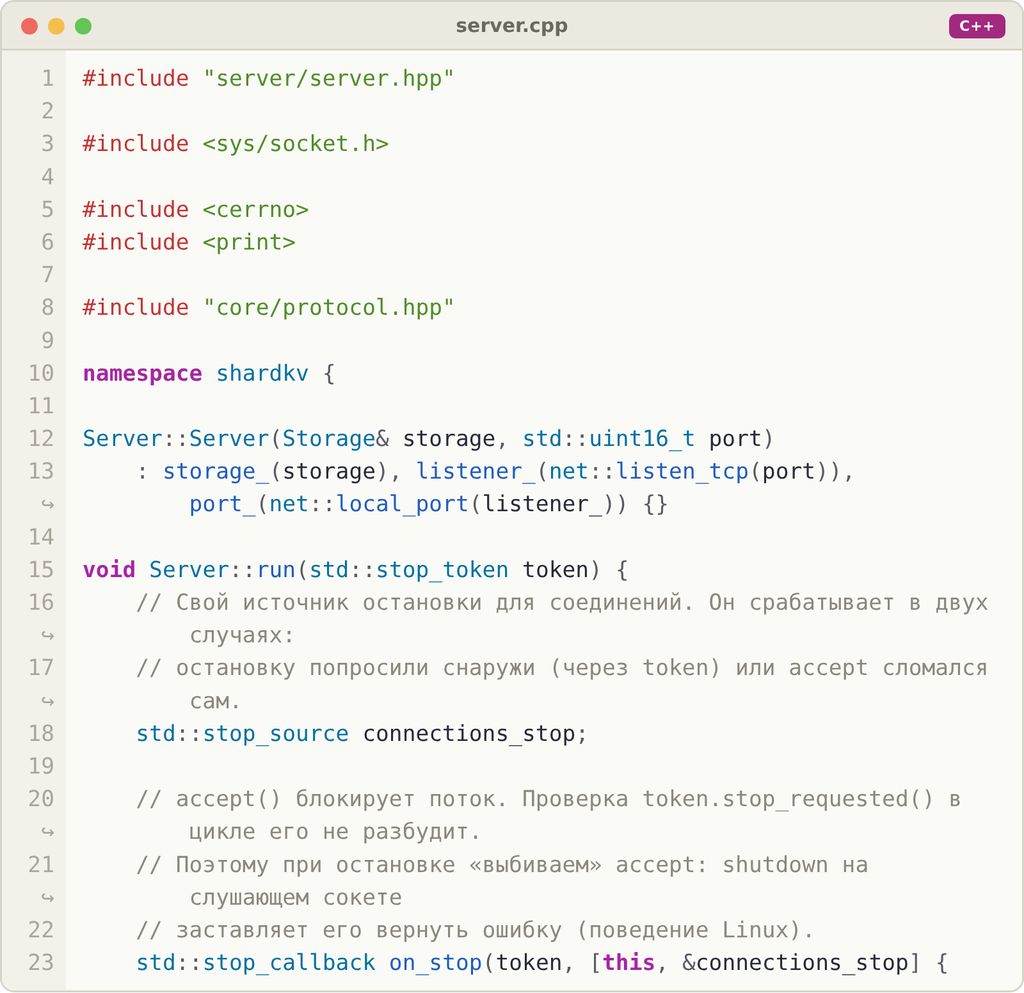


Листинг 1.9 — реализация (server.cpp)
Точка входа. Обработку SIGTERM мы добавим в главе 4, пока сервер останавливается по Enter:


Листинг 1.10 — точка входа shardkv, шаг 1 (main.cpp)
Сборка, запуск, проверка
Сборка и тесты под ThreadSanitizer, десять прогонов подряд:

Листинг 1.11 — сборка и тесты под TSan, десять прогонов подряд
Тесты проверяют протокол и две вещи про потоки: сервер отвечает и корректно останавливается, а остановка будит соединения, которые подключились и молчат. Если остановка сломана, тест не упадёт, а повиснет, поэтому у тестов стоит таймаут.
Запуск руками:

Листинг 1.12 — ручная проверка сервера через nc
Тизер главы 2
Теперь запустим сервер под TSan и подключим четыре клиента, которые одновременно делают INCR одного ключа:

Листинг 1.13 — четыре клиента одновременно делают INCR
В логе сервера появится:

Листинг 1.14 — отчёт TSan в логе сервера
Это не ложное срабатывание. Четыре потока одновременно меняют один unordered_map. В release-сборке без санитайзера такой код может терять инкременты, возвращать мусор или упасть посреди перехеширования таблицы. Как это чинить и почему «оно же почти всегда работает» — не аргумент, разберём в следующей главе.
Полный код шага 1
Для тех, кто собирает проект с нуля, — остальные файлы. В них нет ничего многопоточного: хранилище, протокол и RAII-обёртка над сокетами.


Листинг 1.15 — хранилище shardkv, шаг 1 (storage.hpp)

Листинг 1.16 — реализация (storage.cpp)

Листинг 1.17 — текстовый протокол shardkv (protocol.hpp)


Листинг 1.18 — реализация (protocol.cpp)
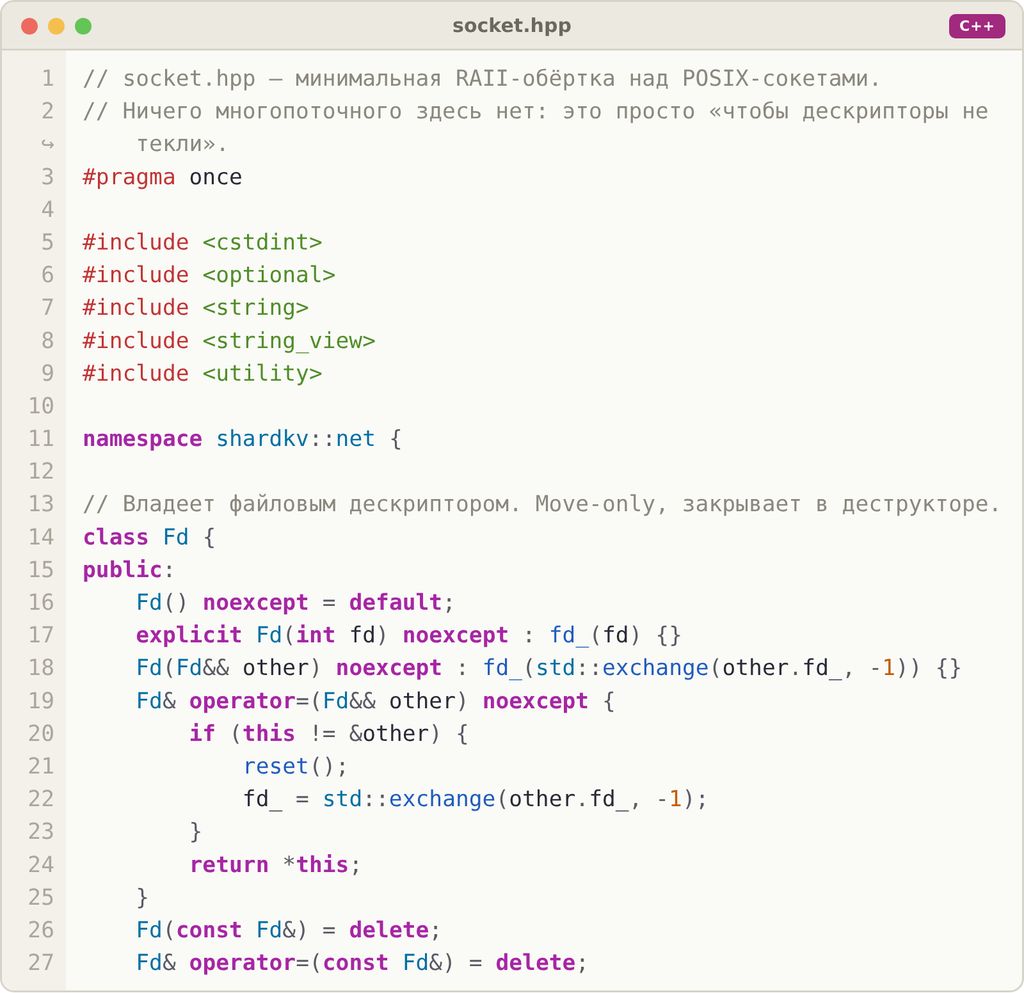

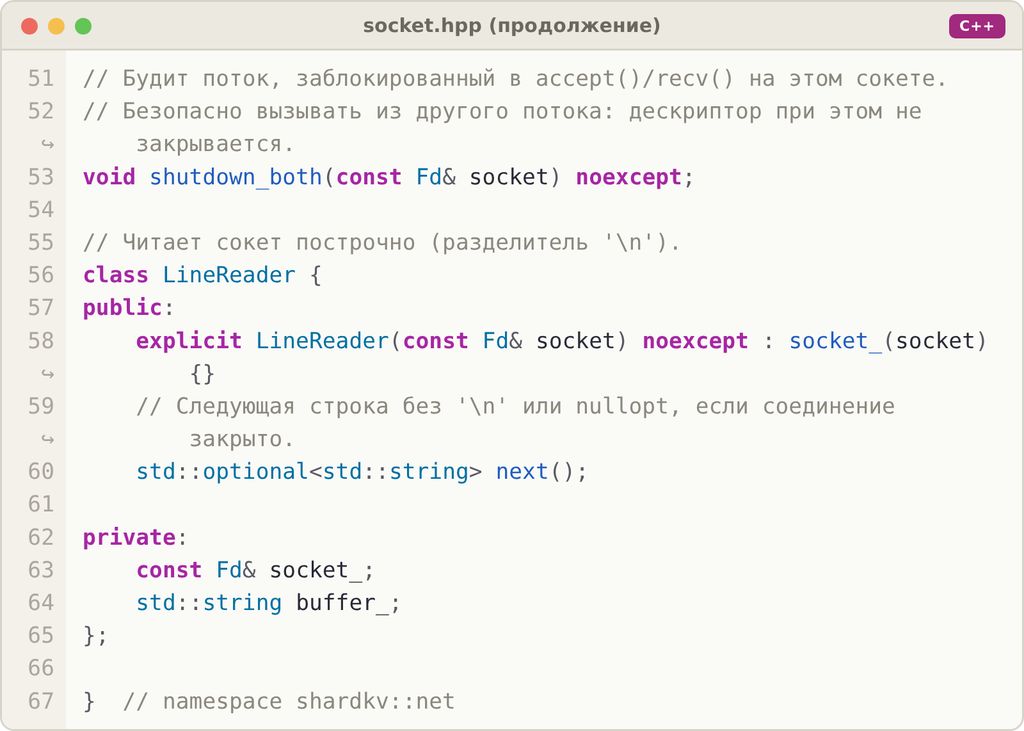
Листинг 1.19 — минимальная RAII-обёртка над POSIX-сокетами (socket.hpp)

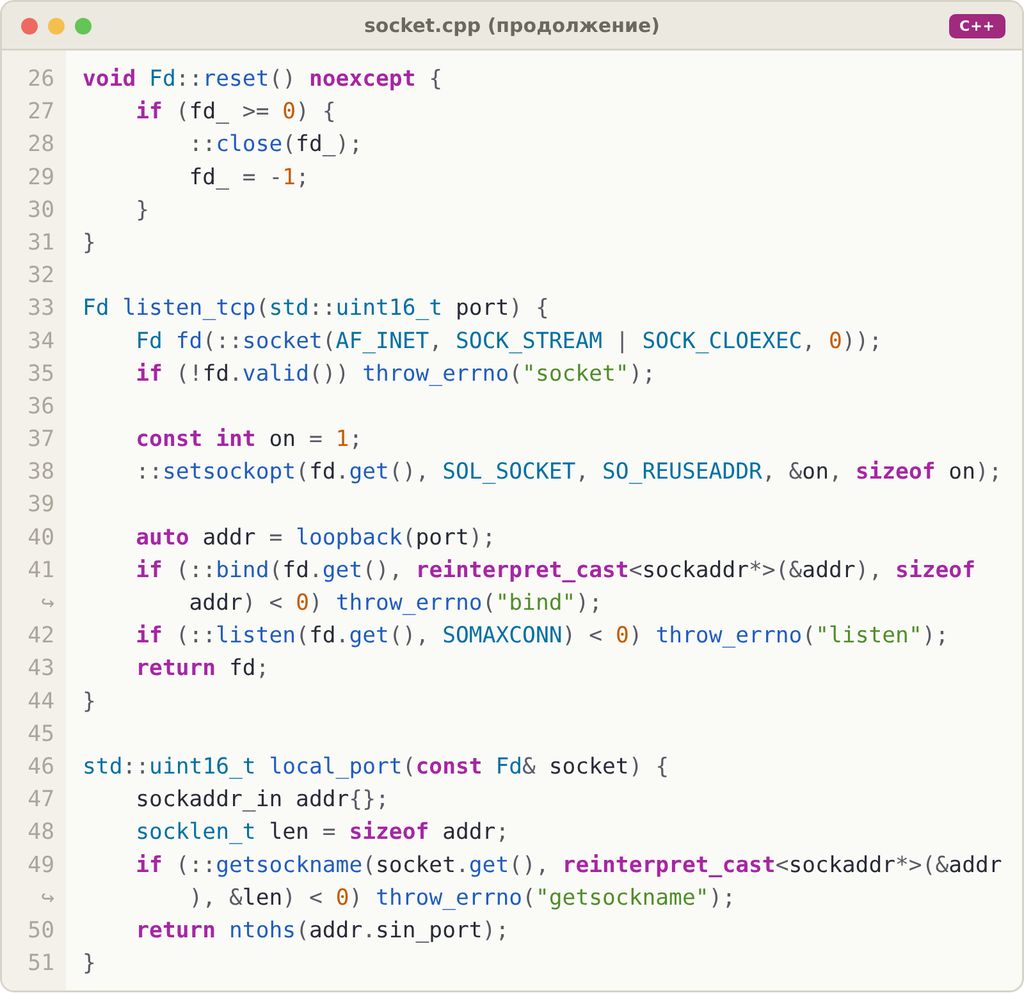


Листинг 1.20 — реализация (socket.cpp)
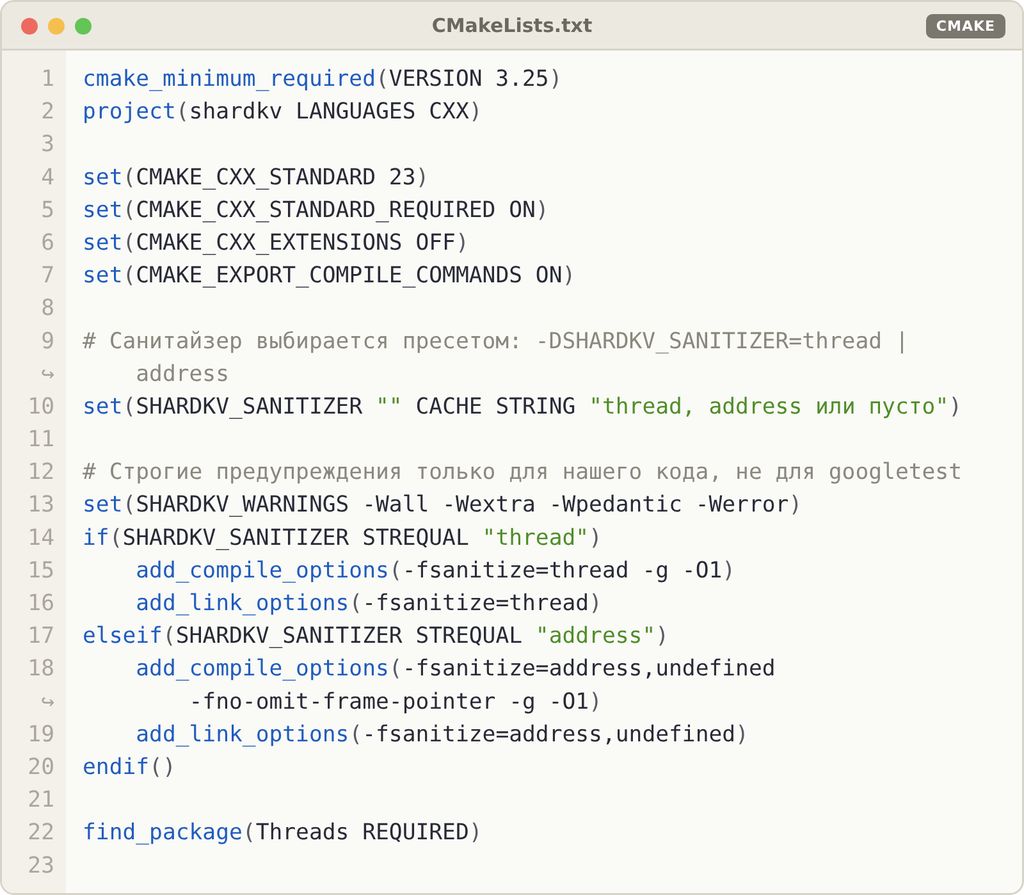

Листинг 1.21 — файл сборки CMake (CMakeLists.txt)


Листинг 1.22 — пресеты сборки CMake (CMakePresets.json)


Листинг 1.23 — тесты (test_protocol.cpp)


Листинг 1.24 — тесты (test_server.cpp)
Задачки для разминки мозгов
Правило самопроверки для всех задач книги: решение засчитывается, только если тесты проходят под TSan и ASan десять раз подряд (ctest --repeat until-fail:10). Многопоточный тест, прошедший один раз, ничего не доказывает.
Задача 1.1 (лёгкая). Найди три бага
В этом коде три бага. Код компилируется без предупреждений. Иногда даже печатает то, что нужно.
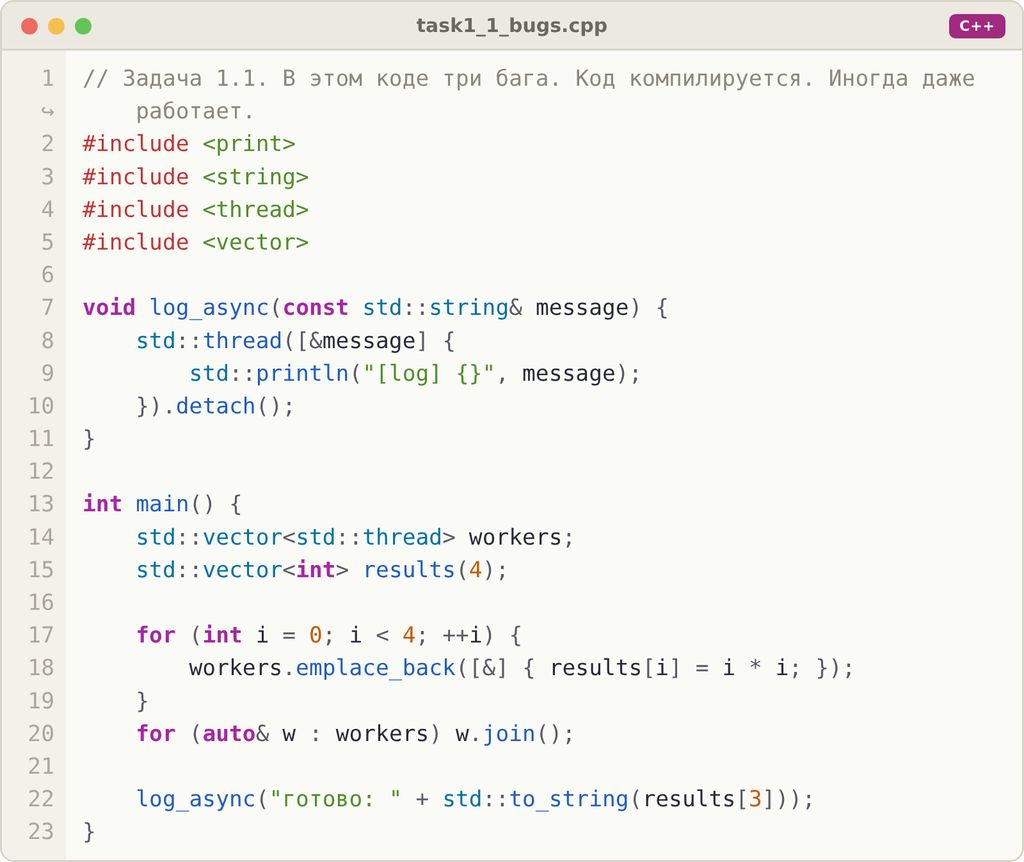
Листинг 1.25 — код к задаче 1.1 (task1_1_bugs.cpp)
Найдите все три бага. Для каждого объясните в одной фразе, что именно сломается и при каких условиях. Затем перепишите код на std::jthread так, чтобы он был корректным, а log_async по-прежнему не блокировал вызывающий код.
Проверка: исправленный код чист под ASan и TSan; объяснение каждого бага укладывается в одну фразу и называет конкретную причину (не «потому что многопоточность»).
Задача 1.2 (средняя). parallel_sum с доставкой исключений
Реализуйте функцию:

Листинг 1.26 — сигнатура функции parallel_sum
Функция применяет transform к каждому элементу и возвращает сумму результатов. Работа делится на threads примерно равных частей, каждая обрабатывается в своём потоке. Каждый поток пишет результат в свою ячейку, без общего счётчика. Если transform бросает исключение в любом потоке, parallel_sum дожидается всех потоков и бросает это исключение вызывающему коду.
Учтите граничные случаи: пустой data, threads == 0, threads больше, чем элементов.
Проверка: результат совпадает с std::transform_reduce на случайных данных; тест, в котором transform бросает на одном элементе, получает именно это исключение; ни один поток не остаётся работать после выхода из функции.
Задача 1.3 (сложная). Сервис, который нельзя сломать деструктором
Напишите класс TickService:
— конструктор принимает число воркеров N и запускает N потоков;
— каждый воркер увеличивает свою ячейку в std::vector<std::uint64_t>, который является членом класса, пока его не остановят;
— метод stop_and_total() останавливает всех воркеров и возвращает сумму ячеек;
— деструктор корректно останавливает воркеров, даже если stop_and_total() не вызывался;
— для остановки используется один общий std::stop_source.
Главное требование: класс должен быть корректным при любом сценарии использования, включая «создали и сразу уничтожили». Подсказка: обратите внимание, в каком порядке разрушаются члены класса и что из этого следует для потоков, которые к ним обращаются. Объясните, почему ваш порядок членов правильный, а обратный — нет.
Проверка: тест «создать и сразу уничтожить» 1000 раз подряд проходит под ASan и TSan; тест stop_and_total() возвращает ненулевую сумму после короткой работы; повторный вызов stop_and_total() не ломает объект.
Решения и разбор ваших неизбежных ошибок — в главе «Ответы к задачам» в конце книги.
Глава 2. Data race, мьютексы и тот самый deadlock
«Там же просто int, что может пойти не так?» — надпись на надгробии одного сервиса.
В прошлой главе мы оставили shardkv с бомбой внутри: несколько потоков одновременно меняют один std::unordered_map. На тестах всё работает. Под четырьмя клиентами ThreadSanitizer кричит «data race». Сегодня мы разберёмся, почему это не «предупреждение, которое можно игнорировать», а неопределённое поведение, и научимся его лечить.
Лекарство — мьютексы. У лекарства есть побочные эффекты: дедлоки, медленный код и интерфейсы, которые потокобезопасны по отдельности и сломаны вместе. Их мы тоже разберём.
К концу главы вы:
— будете отличать data race от race condition (на собеседованиях их путают постоянно);
— научитесь выбирать между lock_guard, unique_lock, scoped_lock и shared_lock;
— поймёте, почему защищать нужно данные и инварианты, а не строчки кода;
— научитесь проектировать интерфейс, в котором нельзя устроить гонку снаружи;
— узнаете четыре условия дедлока и как сломать хотя бы одно;
— выясните, что в стандартной библиотеке потокобезопасно, а что только притворяется;
— сделаете хранилище shardkv потокобезопасным и впервые измерите сервер нагрузкой.
2.1. Data race: почему это UB, а не «иногда не то значение»
Начнём с самой короткой гонки в мире:


Листинг 2.1 — самая короткая гонка данных в мире и её последствия (ex01_race.cpp)
Четыре потока по миллиону раз делают ++counter. Ожидаем 4 000 000. На моей машине в сборке -O0 получилось 2 176 855. Почти половина инкрементов исчезла.
Почему? ++counter — это не одна операция, а три: прочитать значение из памяти в регистр, увеличить регистр, записать обратно. Два потока читают 41, оба увеличивают до 42, оба записывают 42. Один инкремент потерян.
Но объяснение «операции перемешались» — это только половина правды, и, честно говоря, менее страшная половина. Стандарт C++ определяет data race так: два обращения к одной ячейке памяти из разных потоков, хотя бы одно из них — запись, хотя бы одно не атомарное, и между ними нет отношения happens-before (то есть никакой синхронизации). И дальше стандарт говорит: программа с data race имеет неопределённое поведение.
Не «может вернуть неправильное значение». Неопределённое поведение. Компилятор оптимизирует код, исходя из предположения, что гонок нет. Он может держать переменную в регистре и никогда не перечитывать её из памяти. Может свернуть цикл в одну запись. Может переставить операции местами. Поэтому с -O2 этот же пример иногда выдаёт ровно 4 000 000: компилятор превратил цикл в counter += 1000000, и окно для гонки стало крошечным. Это не исправление. Это UB, которому сегодня повезло.
Классический пример того, как это стреляет:

Листинг 2.2 — гонка на обычном bool
Компилятор видит цикл, в котором ready не меняется (по его мнению, ведь гонок нет), выносит чтение из цикла, и поток 1 зависает навсегда. На -O0 работает, на -O2 висит. Отлаживать такое в продакшене — отдельный вид удовольствия.
Вывод: data race — это не «маленькая неточность», а ошибка того же класса, что выход за границу массива. Её не терпят «потому что значение не критичное». Её исправляют.
Data race и race condition — разные вещи
— Data race — формальное понятие стандарта: несинхронизированный конкурентный доступ с записью. Всегда UB. Ловится ThreadSanitizer.
— Race condition — логическая ошибка: результат зависит от того, в каком порядке выполнились потоки, и некоторые порядки дают неправильный результат. Может существовать без всякого data race: все обращения под мьютексом, а логика всё равно сломана. TSan такие ошибки не ловит.
Пример race condition без data race будет в разделе 2.4. Запомните разницу сейчас: на собеседовании вас о ней спросят.
2.2. std::mutex и RAII-обёртки
Мьютекс (mutual exclusion) — объект, который в каждый момент может быть захвачен только одним потоком. Остальные, кто пытается его захватить, ждут. Код между захватом и освобождением называется критической секцией: в ней в каждый момент находится не больше одного потока.


Листинг 2.3 — тот же счётчик, но честный (ex02_mutex.cpp)
Теперь результат всегда 4 000 000. Мьютекс даёт сразу две гарантии, и вторая важнее, чем кажется:
— взаимное исключение: в критической секции один поток;
— видимость: всё, что поток записал до unlock(), гарантированно увидит поток, который после этого сделал lock(). Освобождение мьютекса синхронизируется с его следующим захватом. Без этой гарантии второй поток мог бы прочитать устаревшее значение из кеша процессора или регистра. Формально это то самое отношение happens-before, разберём его в главе 5.
Руками вызывать m.lock() и m.unlock() не нужно: если между ними вылетит исключение или кто-то добавит ранний return, мьютекс останется захваченным навсегда, и следующий поток повиснет. Для этого есть RAII-обёртки:
— std::lock_guard — захватывает в конструкторе, освобождает в деструкторе. Ничего больше не умеет, и это хорошо. Выбор по умолчанию для одного мьютекса.
— std::unique_lock — может отпустить мьютекс раньше конца области видимости, захватить позже (std::defer_lock), попробовать захватить с таймаутом, передать владение. Нужен для condition_variable (глава 3). Чуть дороже lock_guard: хранит флаг владения.
— std::scoped_lock (C++17) — захватывает один или несколько мьютексов сразу, без риска дедлока. Для одного мьютекса работает как lock_guard, поэтому многие используют его везде.
— std::shared_lock — разделяемый захват shared_mutex (раздел 2.6).
Благодаря CTAD (вывод аргументов шаблона класса) тип мьютекса писать не нужно: std::lock_guard lock(m) вместо std::lock_guard<std::mutex> lock(m).
Сколько стоит мьютекс
Незахваченный мьютекс в Linux стоит очень дёшево: одна атомарная операция на захват и одна на освобождение, без системных вызовов (как это устроено через futex, разберём в главе 4). Дорогим мьютекс становится при конкуренции (contention): когда потоки постоянно сталкиваются на нём, они уходят спать в ядро, просыпаются, переключают контекст. Отсюда главное правило:
Держите мьютекс как можно меньше. Всё, что можно сделать до захвата (аллокации, вычисления, разбор строк) или после освобождения (логирование, отправка по сети), делайте снаружи критической секции. В хранилище shardkv мы так и сделаем: строки для ключа и значения создаются до захвата лока.
2.3. Защищайте данные, а не код
Типичная ошибка новичка: «вот эта функция вызывается из нескольких потоков, обложу-ка её мьютексом». Мьютекс защищает не функцию, а данные и инварианты. Если те же данные меняются в другой функции без того же мьютекса, защита первой бессмысленна.
Правило: у каждого общего изменяемого объекта должен быть ровно один мьютекс, который его охраняет, и это должно быть очевидно из кода. Лучший способ сделать это очевидным — не давать доступа к данным без мьютекса вообще:


Листинг 2.4 — защищаем данные, а не код (ex03_synchronized.cpp)
Synchronized<T> — маленькая обёртка, которая делает «забыть мьютекс» невозможным: до данных можно добраться только через with_lock, а он захватывает мьютекс. Подобные классы есть в folly (folly::Synchronized) и Boost (boost::synchronized_value).
Но и тут есть дыра: если функция вернёт ссылку или указатель на защищённые данные, этот указатель будет жить после освобождения мьютекса. Любое обращение через него — data race. Правило: из-под лока выносят копии, а не ссылки. То же относится к хранилищу shardkv: get() возвращает копию строки, а не const std::string&.
Ещё одна дыра — вызов пользовательского кода под локом. Если вы под мьютексом вызываете колбэк, а колбэк вызывает метод того же объекта, который захватывает тот же мьютекс, это дедлок (std::mutex нерекурсивен). А если колбэк захватывает другой мьютекс, вы получаете неконтролируемый порядок захвата (раздел 2.5). Правило: не вызывайте под локом код, которого не контролируете.
2.4. Потокобезопасный интерфейс: когда каждый метод безопасен, а класс сломан
Вот обещанный пример race condition без data race:
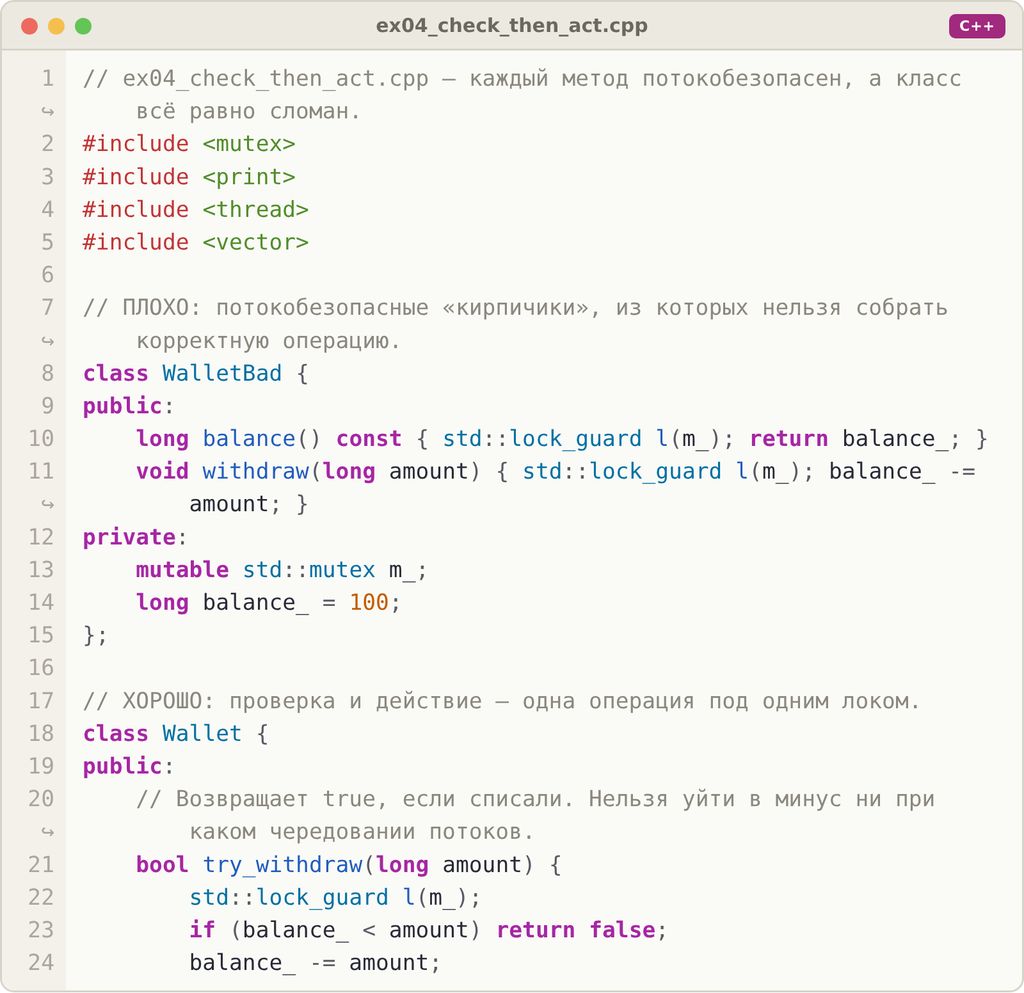


Листинг 2.5 — каждый метод потокобезопасен, а класс всё равно сломан (ex04_check_then_act.cpp)
У WalletBad каждый метод захватывает мьютекс. Data race нет, TSan промолчит. Но код «проверь баланс, потом спиши» состоит из двух операций, и между ними другой поток успевает списать деньги. Восемь покупателей одновременно видят баланс 100, и каждый списывает 30. Итог −140.
Это ошибка проектирования интерфейса, а не реализации. Мьютекс внутри методов не может защитить последовательность вызовов снаружи. Решение — сделать операцию, которую нужно выполнить атомарно, одним методом: try_withdraw проверяет и списывает под одним захватом.
Классический пример того же класса ошибок — стек или очередь с методами empty(), top() и pop():

Листинг 2.6 — проверка и действие по отдельности не атомарны
Каждый метод может быть потокобезопасным, а связка всё равно сломана. Правильный интерфейс объединяет проверку и действие: std::optional<T> try_pop(). Именно такой стек вы напишете в задаче 2.2.
Признаки сломанного потокобезопасного интерфейса на ревью:
— методы-«вопросы» (empty, size, contains, count), результат которых используется для принятия решения;
— методы, возвращающие ссылки на внутренние данные;
— необходимость вызвать два метода подряд, чтобы выполнить одно логическое действие.
В shardkv по этой причине INCR и SETNX реализованы внутри хранилища под одним захватом, а не через get() + set() в обработчике протокола.
2.5. Deadlock: четыре условия и как сломать хотя бы одно
Дедлок — ситуация, когда потоки ждут друг друга по кругу и никто не может продвинуться. Программа не падает, не пишет ошибок, не жрёт CPU. Она просто стоит. Мониторинг в это время показывает, что «всё зелёное», потому что процесс жив.
Дедлок возможен, только если одновременно выполнены четыре условия Коффмана:
1. Взаимное исключение: ресурс может держать только один поток.
2. Удержание и ожидание: поток держит один ресурс и ждёт другой.
3. Нет принудительного освобождения: ресурс нельзя отобрать, его можно только отдать.
4. Циклическое ожидание: A ждёт B, B ждёт A (или длиннее цикл).
Первые три для мьютексов выполнены всегда, по определению. Значит, бороться можно только с четвёртым: не допускать циклов.


Листинг 2.7 — два мьютекса, два потока, вечность ожидания (ex05_deadlock.cpp)
Функция merge_bad захватывает мьютексы в порядке аргументов. Поток 1 вызывает merge_bad(a, b), поток 2 — merge_bad(b, a). Поток 1 захватил a и ждёт b, поток 2 захватил b и ждёт a. Цикл.
Способы не допустить цикла:
— std::scoped_lock с несколькими мьютексами (или std::lock). Внутри используется алгоритм, который захватывает мьютексы так, чтобы дедлок был невозможен при любом порядке аргументов: если не удаётся захватить все, он отпускает уже захваченные и пробует снова. Самый простой и надёжный способ, когда все нужные мьютексы известны заранее.
— Глобальный порядок захвата. Все мьютексы упорядочены (например, по идентификатору объекта), и любой код захватывает их только по возрастанию. Тогда цикл невозможен. Работает, даже когда мьютексы захватываются в разных функциях в разное время, но требует дисциплины.
— Иерархия блокировок. Каждому мьютексу назначается уровень, и поток, держащий мьютекс уровня N, может захватывать только мьютексы уровня ниже N. Нарушение сразу видно, а не «когда-нибудь под нагрузкой». Такой мьютекс вы напишете в задаче 2.3.
— Не держать два мьютекса одновременно. Самый надёжный способ. Если архитектура позволяет — лучшее решение.
Отдельно про вызов merge(a, a): попытка захватить std::mutex, который уже держит текущий поток, — это UB (на практике обычно дедлок). Поэтому в merge есть проверка на один и тот же объект.
2.6. shared_mutex: много читателей, редкий писатель
Если данные в основном читают и редко меняют, обычный мьютекс заставляет читателей ждать друг друга, хотя читать одновременно безопасно. std::shared_mutex позволяет захватить его двумя способами:
— разделяемо (std::shared_lock) — сколько угодно читателей одновременно;
— эксклюзивно (std::unique_lock или std::lock_guard) — один писатель, читателей нет.

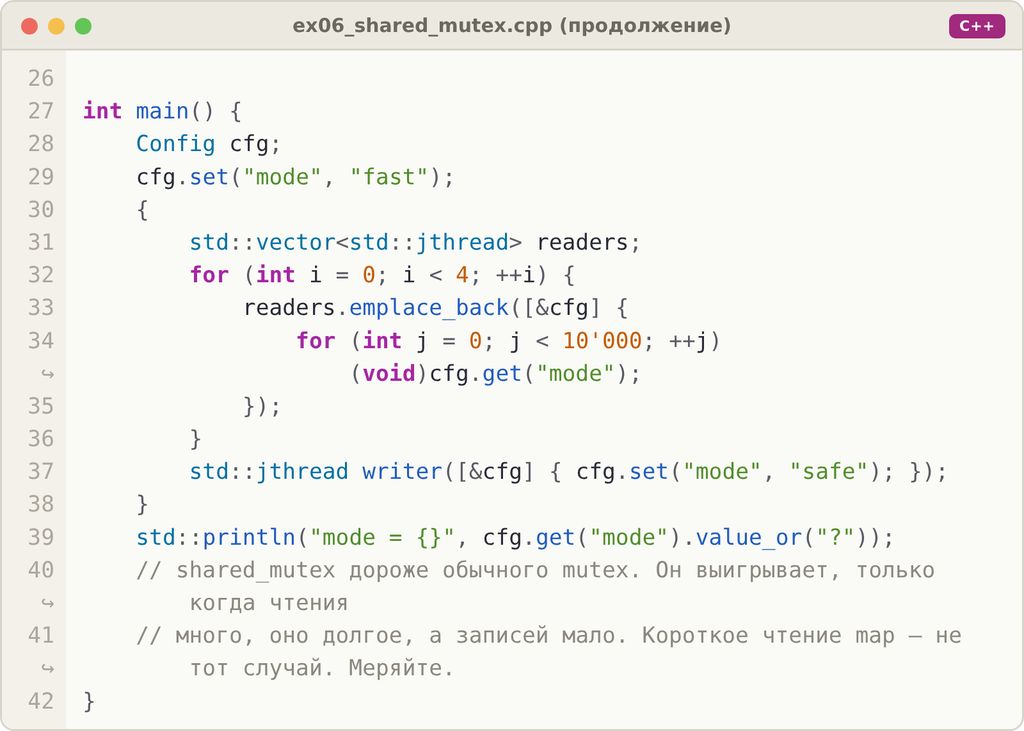
Листинг 2.8 — много читателей, редкий писатель (ex06_shared_mutex.cpp)
Звучит как бесплатное ускорение, но это не так:
— shared_mutex дороже обычного: даже разделяемый захват меняет общий счётчик читателей, и при большом числе ядер этот счётчик сам становится горячей точкой (почему — в главе 4);
— если критическая секция короткая (поиск в хеш-таблице), накладные расходы shared_mutex могут съесть весь выигрыш;
— поведение при постоянном потоке читателей зависит от реализации: писатель может долго ждать.
Правило: shared_mutex выигрывает, когда чтение долгое, читателей много, а записи редкие. Во всех остальных случаях — меряйте. В главе 4 мы сделаем это на shardkv.
2.7. recursive_mutex — запах кода
std::recursive_mutex позволяет одному потоку захватить мьютекс несколько раз (и отпустить столько же раз). Обычно его берут, когда публичный метод под локом вызывает другой публичный метод, который тоже берёт лок.
Это почти всегда признак плохой структуры: класс не понимает, в каком состоянии его инварианты в момент вызова. Если метод A захватил мьютекс и временно нарушил инвариант, а потом вызвал метод B, рассчитывающий на целый инвариант, recursive_mutex этот баг не исправит, а спрячет.
Правильное решение: разделить методы на публичные (берут лок) и приватные (предполагают, что лок уже взят, часто с суффиксом _locked). Публичные вызывают приватные, приватные никогда не вызывают публичные.
2.8. Таймауты: timed_mutex и правильные часы
Иногда ждать мьютекс вечно нельзя: лучше сообщить «занято» и попробовать позже. Для этого есть std::timed_mutex с методами try_lock_for и try_lock_until:
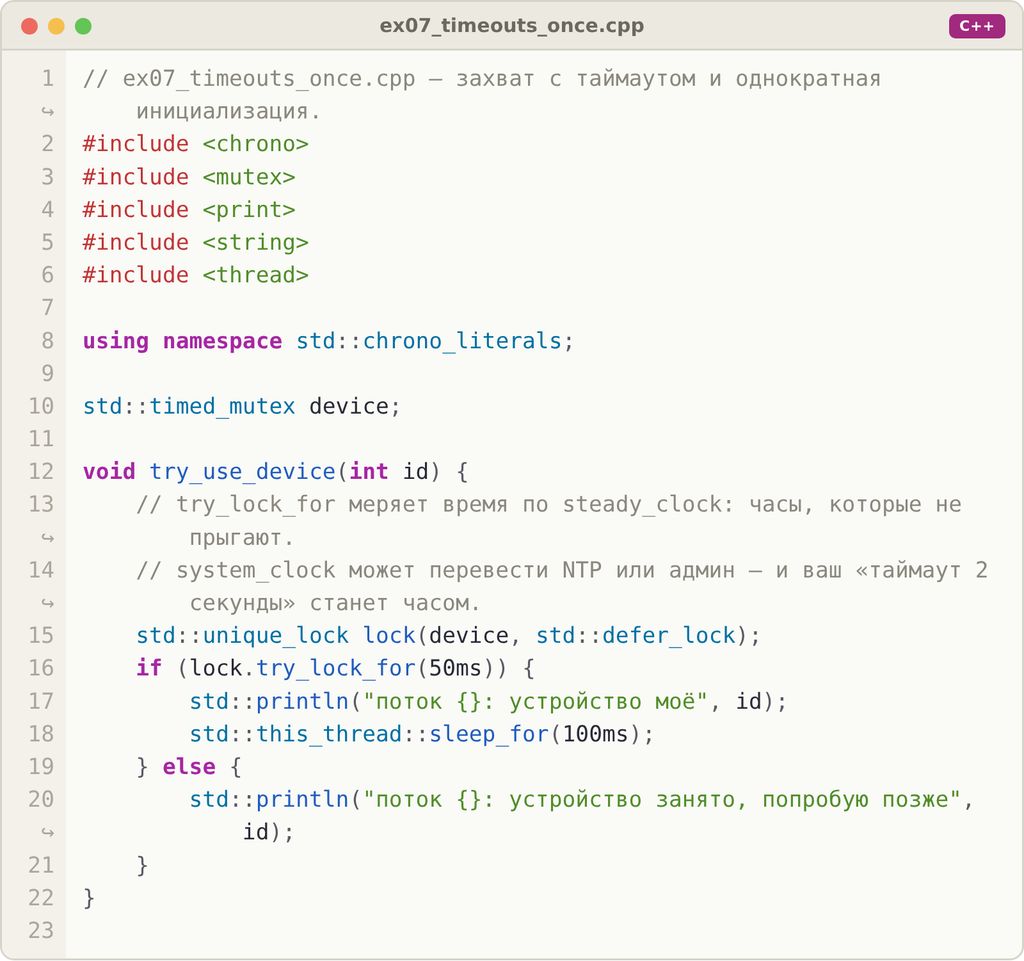
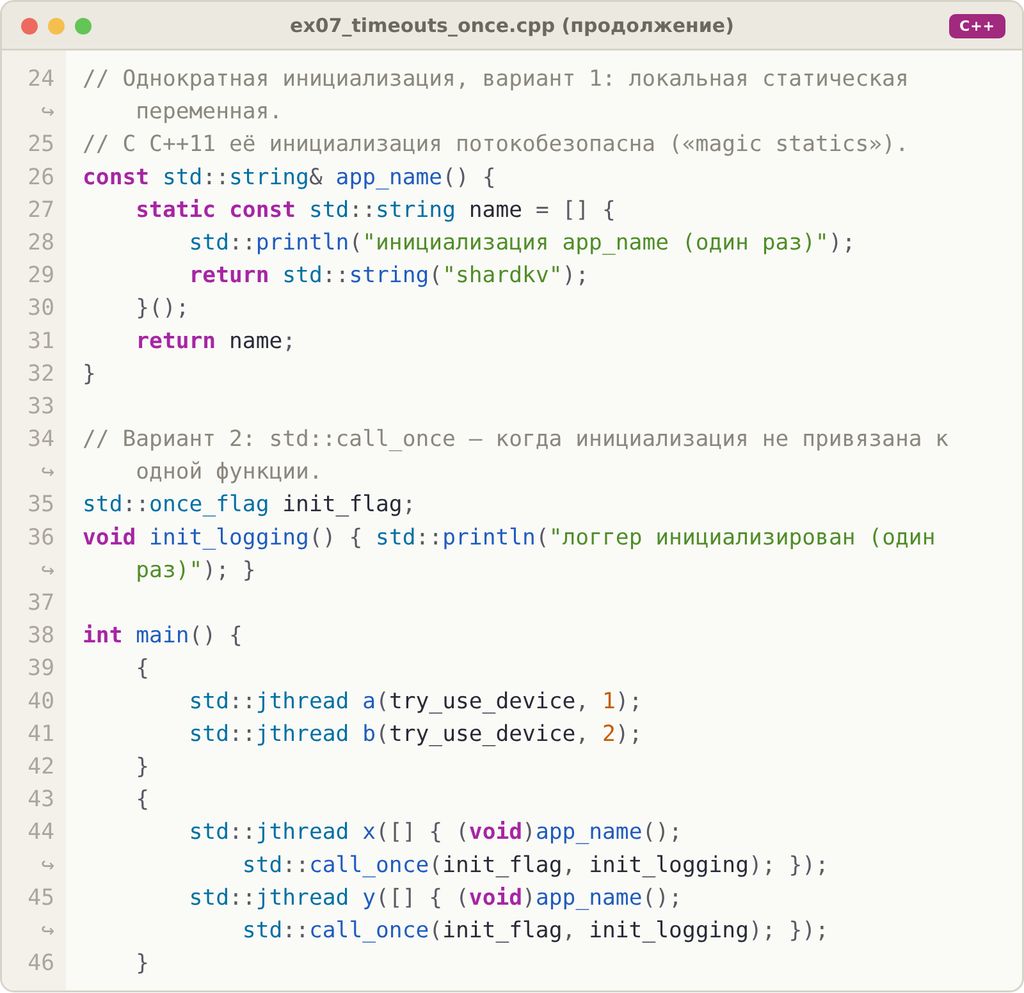

Листинг 2.9 — захват с таймаутом и однократная инициализация (ex07_timeouts_once.cpp)
Две важные детали.
Используйте steady_clock для таймаутов. std::chrono::system_clock — это «настенные часы»: их может перевести NTP, администратор или переход на летнее время. Таймаут «до 12:00:05» превратится в час ожидания, если часы откатили назад. steady_clock монотонны и не прыгают. try_lock_for с длительностью сам использует steady_clock, а вот в try_lock_until вы передаёте момент времени, и часы выбираете сами — выбирайте steady_clock.
Таймаут на мьютексе — часто симптом. Если поток не может дождаться мьютекса за разумное время, обычно проблема в том, что кто-то держит его слишком долго. Таймаут — способ деградировать, а не способ лечить.
И практическая ремарка про инструменты. В некоторых связках GCC и libtsan этот пример вызывает ложное срабатывание TSan: «unlock of an unlocked mutex». Причина: try_lock_for в libstdc++ вызывает pthread_mutex_clocklock, а libtsan этот вызов не перехватывает и не знает, что мьютекс был захвачен. Это ошибка инструмента, а не кода. Лечится обновлением тулчейна или файлом подавлений:

Листинг 2.10 — файл подавлений TSan (tsan.supp)
Листинг 2.11 — запуск с файлом подавлений
Подавления — это последнее средство: каждая строка в таком файле должна иметь комментарий, почему это ложное срабатывание. Подробнее о работе с TSan в CI поговорим в главе 13.
2.9. Однократная инициализация
Ленивая инициализация («создадим объект при первом обращении») — классическое место для гонок. Два потока одновременно видят, что объекта ещё нет, и оба его создают.
С C++11 есть два правильных способа (оба в примере выше):
— локальная статическая переменная. Стандарт гарантирует, что её инициализация выполнится ровно один раз, даже если функцию вызывают из многих потоков одновременно; остальные потоки подождут. Это называют «magic statics». Самый простой способ, и почти всегда достаточный;
— std::call_once с std::once_flag — когда инициализация не привязана к одной функции, или флаг должен быть членом класса.
И отдельно о том, чего делать не надо: «блокировка с двойной проверкой» (double-checked locking) на обычном указателе. Это data race на чтении указателя без лока. Правильная версия требует атомиков, и мы разберём её в главе 5. А пока: magic statics.
2.10. Что потокобезопасно в стандартной библиотеке
Общее правило стандарта: конкурентный вызов const-методов одного объекта безопасен, если тип не говорит обратного; конкурентная запись или запись одновременно с чтением — гонка. Разные объекты можно использовать из разных потоков свободно.

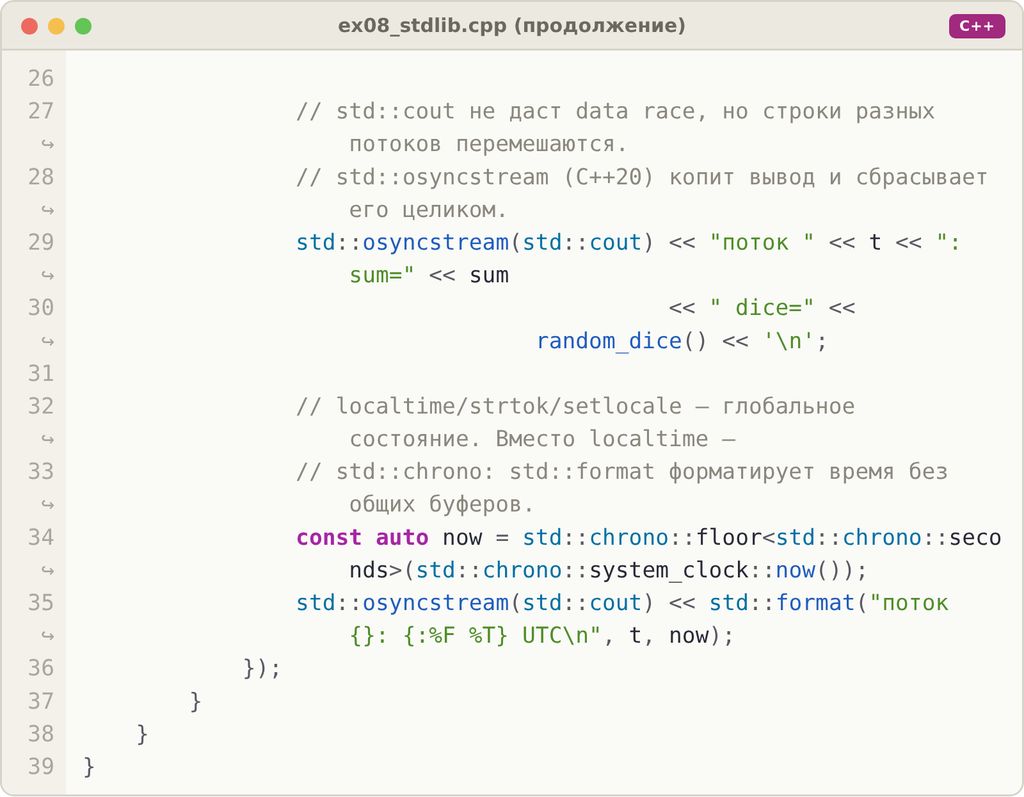
Листинг 2.12 — что в стандартной библиотеке потокобезопасно, а что притворяется (ex08_stdlib.cpp)
Конкретно:
— Контейнеры. Читать один std::vector или std::map из многих потоков можно, если никто в это время не пишет. Осторожно с «читающими» методами, которые на самом деле пишут: operator[] у std::map вставляет элемент, если ключа нет.
— std::cout и другие стандартные потоки. Data race не будет, но вывод разных потоков может перемешаться посимвольно. std::osyncstream (C++20) накапливает вывод и сбрасывает его одним куском.
— rand(). Использует скрытое глобальное состояние, не потокобезопасен. Используйте генератор из <random>, по одному на поток (thread_local).
— localtime(), gmtime(), strtok(), setlocale(), getenv() при одновременном setenv(). Работают с глобальным или статическим состоянием. Для времени используйте std::chrono и std::format, вместо strtok — std::string_view и std::views::split.
— std::shared_ptr. Тут хитро: счётчик ссылок атомарный, а объект и сам указатель — нет. Это отдельный большой разговор в главе 5.
2.11. ThreadSanitizer: первый запуск
ThreadSanitizer (TSan) — инструмент, встроенный в GCC и Clang, который находит data race во время выполнения программы. Он отслеживает каждое обращение к памяти и каждую синхронизацию и сообщает, если два обращения не упорядочены через happens-before.
Как включить:

Листинг 2.13 — сборка и запуск под TSan вручную
В нашем проекте это пресет tsan:

Листинг 2.14 — пресет tsan: сборка и десять прогонов тестов
Как читать отчёт:
— WARNING: ThreadSanitizer: data race — тип проблемы;
— Write of size 8… by thread T2 и стек вызовов — первое обращение;
— Previous read/write… by thread T1 и стек — второе, конфликтующее обращение;
— Location is … — где находится память (глобальная переменная, куча, стек какого потока);
— Thread T2 created at — где был создан каждый поток.
Что нужно знать про TSan:
— он находит только гонки, которые реально произошли в этом запуске. Если код с гонкой не выполнился, TSan промолчит. Поэтому тесты под TSan гоняют многократно и под нагрузкой;
— он не находит race condition без data race (как WalletBad);
— замедляет программу в 5–15 раз и увеличивает потребление памяти в 5–10 раз — в продакшен его не ставят, только в тесты и CI;
— TSan нельзя совмещать с ASan в одной сборке, поэтому у нас два отдельных пресета;
— ложные срабатывания редки, но бывают (раздел 2.8). Ложным срабатывание можно считать только после того, как вы можете объяснить, какая синхронизация его исключает.
2.12. Грабли с ревью
— «Это просто bool/int, гонка тут безвредна». Безвредных data race не бывает, бывает UB, которое ещё не выстрелило.
— Мьютекс, который защищает функцию, а не данные. Те же данные меняются в другом месте без лока.
— Ссылка или указатель на данные, вынесенные из-под лока.
— Пары «проверка + действие» через два публичных вызова. empty() + pop(), contains() + insert(), get() + set().
— Вызов колбэков, виртуальных функций или чужого кода под локом.
— Захват двух мьютексов по очереди через два lock_guard. Используйте std::scoped_lock.
— Тяжёлая работа под локом: логирование, сетевые вызовы, аллокации, которые можно вынести.
— recursive_mutex «чтобы не думать».
— Таймауты на system_clock.
— Ручные m.lock()/m.unlock() вне RAII-обёрток.
2.13. Что спросят на собеседовании
Что такое data race и чем он отличается от race condition? (middle) Data race — несинхронизированный конкурентный доступ к одной памяти, хотя бы один из которых запись; по стандарту UB. Race condition — логическая зависимость результата от порядка выполнения; может быть и без data race. Хороший ответ приводит пример второго без первого.
Почему ++counter из двух потоков — это не просто «потеря инкрементов»? (middle/senior) Это UB: компилятор оптимизирует код в предположении, что гонок нет, и может, например, вынести чтение из цикла. Потеря инкрементов — лишь одно из проявлений.
Чем lock_guard отличается от unique_lock и scoped_lock? (junior/middle) lock_guard — простейший RAII; unique_lock — гибкий (отложенный захват, ранний unlock, таймауты, передача владения, нужен для condition_variable); scoped_lock — несколько мьютексов без дедлока.
Назовите условия дедлока и способы его избежать. (middle) Четыре условия Коффмана; на практике ломаем циклическое ожидание: std::scoped_lock, глобальный порядок захвата, иерархия блокировок, отказ от удержания двух мьютексов.
Почему интерфейс стека с empty(), top(), pop() плох в многопоточном коде? (middle) Последовательность вызовов не атомарна, между ними другой поток меняет состояние. Решение — try_pop(), возвращающий std::optional<T>.
Когда shared_mutex медленнее обычного mutex? (senior) При коротких критических секциях и большом числе ядер: разделяемый захват всё равно пишет в общий счётчик, кеш-линия с ним прыгает между ядрами. Сильный ответ: «меряю, а не угадываю».
Потокобезопасна ли инициализация локальной статической переменной? (middle) Да, с C++11 (magic statics). Бонус: рассказать, почему double-checked locking на обычном указателе — data race.
Можно ли читать std::vector из нескольких потоков одновременно? (junior/middle) Да, через const-методы, если никто не пишет. Бонус: operator[] у std::map пишет.
2.14. Сквозной проект shardkv, шаг 2: глобальный мьютекс и первый бенчмарк
Что делаем:
— убеждаемся, что TSan видит гонку шага 1 (мы это сделали в конце главы 1);
— делаем Storage потокобезопасным: один мьютекс на всё хранилище;
— INCR и SETNX выполняются внутри Storage под одним захватом — проверка и изменение не разделены;
— добавляем стресс-тесты под TSan;
— пишем первую версию нагрузочного клиента kvbench и впервые меряем сервер.
Что проверяем:
— 8 потоков по 5000 INCR дают ровно 40 000;
— 8 потоков одновременно делают SETNX одного ключа — ровно один выигрывает, 200 раундов подряд;
— 6 клиентов через настоящий TCP-сервер делают INCR — ни один не потерян;
— всё это под TSan и ASan, 10 прогонов подряд.
Что меряем: пропускную способность сервера в зависимости от числа клиентов.
Новое хранилище
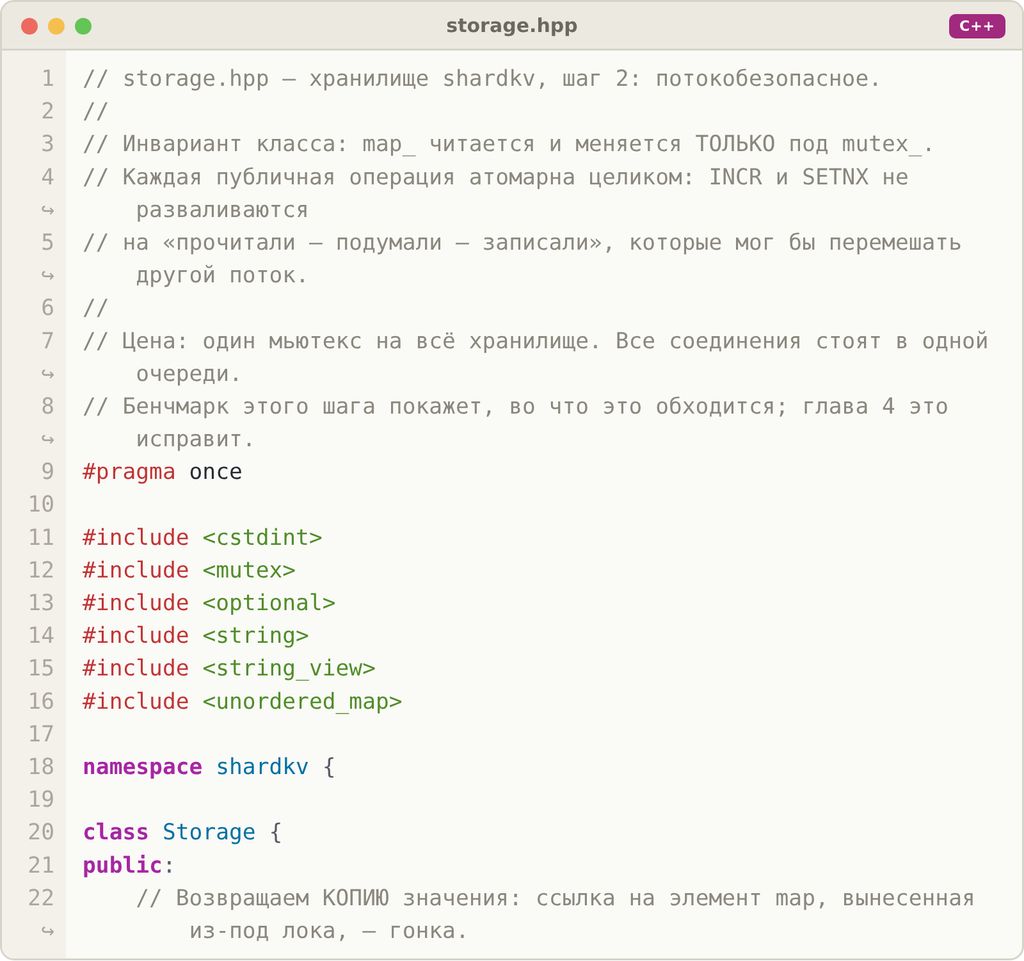


Листинг 2.15 — хранилище shardkv, шаг 2 (storage.hpp)


Листинг 2.16 — реализация (storage.cpp)
Обратите внимание на три приёма из этой главы:
— мьютекс mutable, потому что захватывается и в const-методах;
— строки ключа и значения создаются до захвата лока, чтобы аллокации не выполнялись в критической секции;
— get() возвращает копию, а не ссылку.
В server.cpp из шага 1 меняется только комментарий над вызовом execute: гонки больше нет.
Стресс-тесты


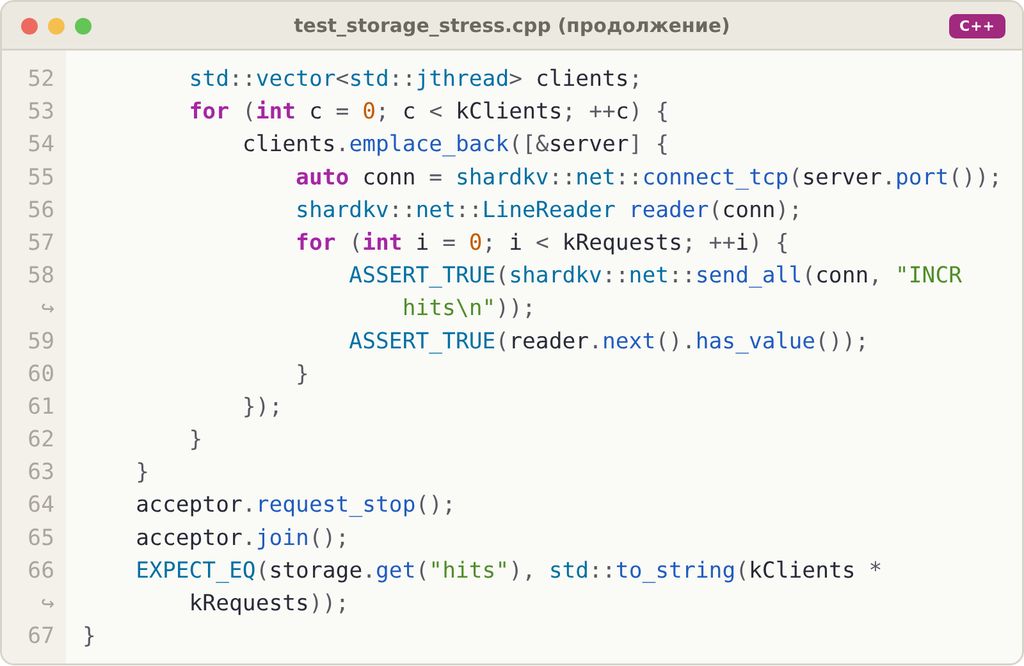
Листинг 2.17 — тесты (test_storage_stress.cpp)
В тесте SetnxHasExactlyOneWinner используется std::atomic<int> для подсчёта победителей. Пока считайте его «int, который можно безопасно увеличивать из многих потоков»; подробно атомики разберём в главе 5.
kvbench, версия 1


Листинг 2.18 — нагрузочный клиент shardkv (kvbench.cpp)
Каждый клиент — отдельный поток со своим соединением. Обратите внимание: клиенты пишут статистику каждый в свою ячейку вектора, а читаем мы её только после join всех потоков. Общих изменяемых данных нет, синхронизация не нужна. Это лучший вид синхронизации.
Первые замеры
Сборка release, сервер и kvbench на одной машине, режим mix (90% GET, 10% SET), 20 000 запросов на клиента:

Листинг 2.19 — сборка release и запуск сервера
Результаты на моей машине:

Листинг 2.20 — kvbench версии 1: пропускная способность и средняя задержка
Что видно:
— до 4 клиентов пропускная способность растёт;
— дальше начинается плато, а на 16 клиентах она падает;
— задержка растёт быстрее, чем пропускная способность: с 8 до 16 клиентов задержка выросла почти втрое, а ops/s упали.
Честная оговорка, без которой замеры ничего не стоят: эти цифры сняты в контейнере с двумя ядрами, где сервер и kvbench делят одни и те же два ядра. На такой машине плато наступает уже из-за нехватки CPU, и отделить его от конкуренции за мьютекс по этим цифрам нельзя. Прогоните бенчмарк на своей машине с 8+ ядрами: там картина «пропускная способность упёрлась, хотя ядра простаивают» будет видна отчётливо. Как доказать, что виноват именно лок, а не CPU, мы научимся в главе 13 (off-CPU профилирование). А в главе 4 уберём глобальный мьютекс и сравним цифры.
Сохраните свои результаты в bench/results/step02.txt. Вся книга построена на сравнении «было/стало», и без «было» сравнивать будет не с чем.
Полный код шага 2
Остальные файлы не изменились по сравнению с шагом 1, кроме CMakeLists.txt (добавлены kvbench и стресс-тесты):


Листинг 2.21 — файл сборки CMake (CMakeLists.txt)
Задачки для разминки мозгов
Напоминаю правило самопроверки: решение засчитывается, только если тесты проходят под TSan и ASan десять раз подряд.
Задача 2.1 (лёгкая). Банк, который зависает


Листинг 2.22 — код к задаче 2.1 (task2_1_bank.cpp)
Эта программа зависает (у меня — каждый раз). Найдите дедлок и опишите конкретную последовательность событий, которая к нему приводит. Исправьте функцию transfer двумя способами:
1. через std::scoped_lock;
2. через захват мьютексов в порядке возрастания id счёта.
Объясните, почему оба способа корректны. Отдельно подумайте: что должно происходить при transfer(alice, alice, 10)?
Проверка: программа завершается за секунды, итоговая сумма денег в банке равна 2 000 000; TSan чист; перевод самому себе не приводит ни к дедлоку, ни к UB.
Задача 2.2 (средняя). ThreadSafeStack без гонок в интерфейсе
Напишите шаблон ThreadSafeStack<T> с интерфейсом:

Листинг 2.23 — интерфейс ThreadSafeStack<T>
Требования:
— никаких методов empty() + top() + pop(), которые нужно вызывать связкой;
— исключение в конструкторе копирования или перемещения T не должно оставить стек в некорректном состоянии и не должно потерять элемент;
— нельзя возвращать ссылки на внутренние данные.
Напишите стресс-тест: 4 потока кладут по 100 000 уникальных чисел, 4 потока одновременно забирают, пока не заберут все. Каждое число должно быть извлечено ровно один раз.
Проверка: стресс-тест проходит под TSan 10 раз подряд; вы можете объяснить, почему size() в многопоточном коде годится только для статистики.
Задача 2.3 (сложная). hierarchical_mutex
Напишите класс hierarchical_mutex: мьютекс с числовым уровнем. Правило: поток, который держит мьютекс уровня N, может захватить только мьютекс с уровнем строго меньше N. Попытка нарушить порядок бросает std::logic_error сразу, до захвата, а не приводит к дедлоку когда-нибудь потом.
Требования:
— методы lock(), unlock(), try_lock(), чтобы класс работал с std::lock_guard и std::unique_lock;
— текущий уровень потока хранится в thread_local переменной;
— после unlock() уровень потока восстанавливается до предыдущего (поток может держать несколько мьютексов по иерархии);
— подумайте, что делать, если мьютексы отпускают не в обратном порядке захвата.
Проверка: тесты на захват по правильной иерархии; на исключение при нарушении порядка; на корректное восстановление уровня после цепочки lock/unlock; тест с несколькими потоками под TSan.
Решения и разбор ваших неизбежных ошибок — в главе «Ответы к задачам» в конце книги.
Глава 3. Condition variables и потокобезопасная очередь
«Добавил sleep(100), и баг пропал». Баг не пропал. Он ушёл в отпуск и вернётся в пятницу.
Мьютекс отвечает на вопрос «как не мешать друг другу». Но потокам нужно ещё и ждать друг друга: потребитель ждёт, пока в очереди появится задача; фоновый поток ждёт ближайшего дедлайна; главный поток ждёт, пока загрузится конфиг. Делать это через while (!ready) sleep_for(…) — путь в никуда: либо реакция запаздывает на время сна, либо CPU сгорает на холостых проверках.
Правильный инструмент — condition variable (условная переменная). У неё самая коварная семантика из всех примитивов стандартной библиотеки: ошибиться в ней можно тремя разными способами, и все три проявляются раз в сто тысяч запусков. Сегодня мы разберём все три, напишем блокирующую очередь, которая не теряет элементы и умеет закрываться, и научим shardkv удалять ключи по времени жизни.
К концу главы вы:
— поймёте, почему condition variable всегда используется вместе с мьютексом и предикатом;
— научитесь распознавать spurious wakeup и lost wakeup;
— разберётесь, когда звать notify_one, когда notify_all и почему уведомлять лучше после освобождения лока;
— научитесь ждать с таймаутом и дедлайном и узнаете, почему дедлайн лучше;
— освоите condition_variable_any вместе с stop_token;
— напишете блокирующую очередь с закрытием и корректной остановкой;
— добавите в shardkv EXPIRE/TTL с фоновым потоком, который спит ровно до ближайшего дедлайна.
3.1. Как ждать правильно
Condition variable — это механизм «усни, пока тебя не разбудят». Сама по себе она ничего не хранит и ничего не знает о состоянии программы. Это ключевая мысль, из которой следует всё остальное: состояние хранится в обычных переменных под мьютексом, а condition variable лишь будит тех, кто этого состояния ждёт.
Минимальный правильный шаблон выглядит так:
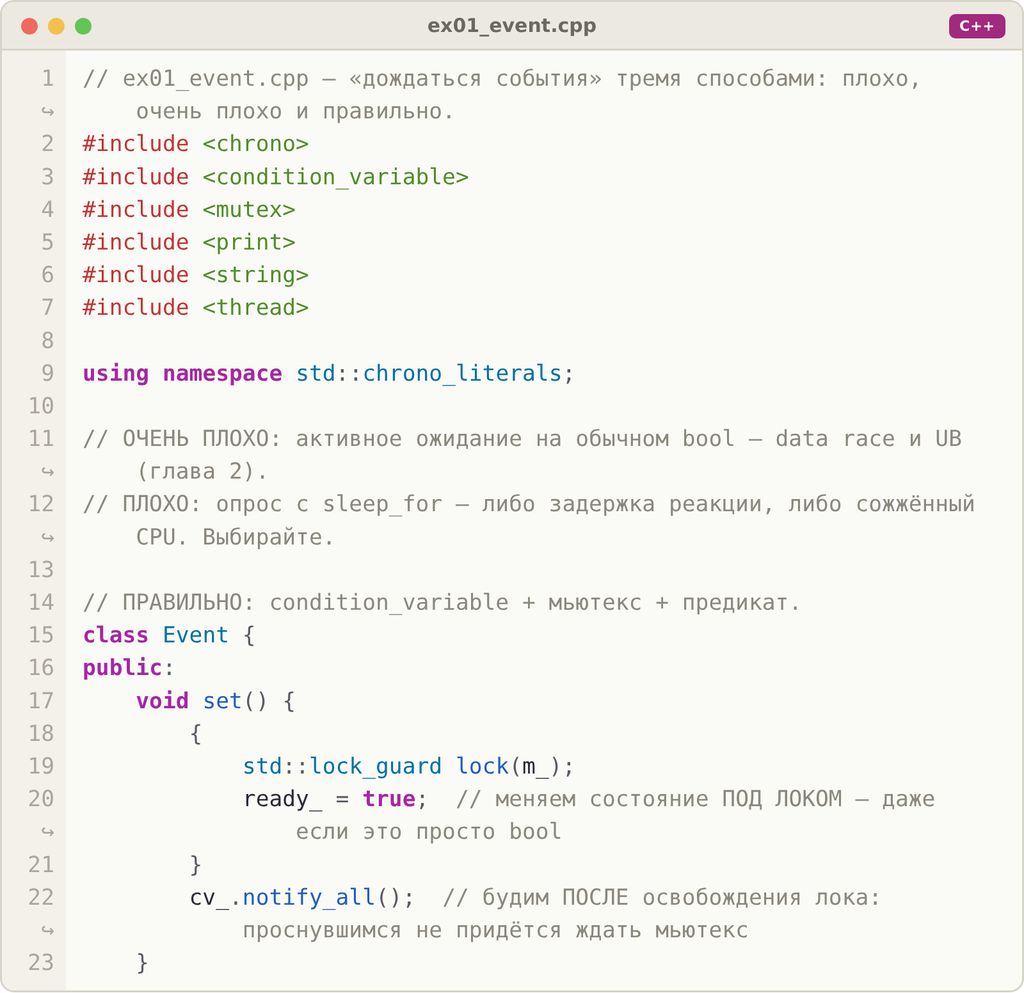

Листинг 3.1 — «дождаться события» тремя способами (ex01_event.cpp)
Три обязательных элемента:
1. Состояние (здесь ready_) — обычная переменная, которую читают и меняют только под мьютексом. Даже если это bool.
2. Мьютекс — один и тот же для изменения состояния и для ожидания.
3. Предикат в wait — функция, которая проверяет состояние.
Что происходит внутри cv.wait(lock, pred):
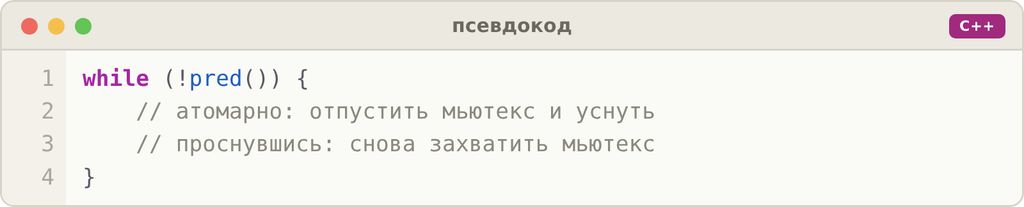
Листинг 3.2 — что делает cv.wait(lock, pred)
Слово «атомарно» здесь критично: между освобождением мьютекса и засыпанием нет окна, в которое могло бы проскочить уведомление. Поэтому wait принимает именно unique_lock: ему нужно отпускать и снова захватывать мьютекс, а lock_guard так не умеет.
3.2. Три способа ошибиться
Ошибка 1: wait без предиката и spurious wakeup
У condition variable есть официально разрешённое право проснуться без всякого notify. Это называется spurious wakeup (ложное пробуждение). Причины — детали реализации ОС: так дешевле реализовать примитив. Стандарт явно разрешает такое поведение.
Если код выглядит так:
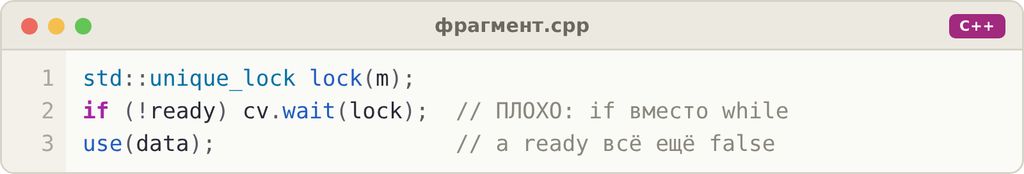
Листинг 3.3 — if вместо while
то после ложного пробуждения он пойдёт дальше, считая, что событие произошло. Лечится просто: всегда используйте перегрузку wait с предикатом (или явный цикл while). Предикат перепроверит состояние после любого пробуждения.
Есть и вторая причина для цикла, совсем не экзотическая. Даже при честном пробуждении к моменту, когда поток снова захватил мьютекс, состояние могло измениться: другой потребитель успел забрать элемент из очереди. Проснулся — не значит, что условие выполняется.
Ошибка 2: lost wakeup — уведомление, которое никто не услышал
Condition variable не запоминает уведомления. Если notify случился, когда никто не ждал, он просто пропал. Поэтому ждущий поток обязан проверить состояние до засыпания, и проверка с засыпанием должны быть атомарны относительно изменения состояния. Это обеспечивает мьютекс — но только если и изменение состояния идёт под ним.
Вот как это ломается:

Листинг 3.4 — потерянное пробуждение: два потока по времени
Поток B поменял флаг и уведомил в окне между проверкой и засыпанием потока A. Если бы B менял ready под тем же мьютексом, он не смог бы попасть в это окно: A держит мьютекс от проверки до момента, когда wait атомарно отпускает его и засыпает.
Самое неприятное: эта ошибка не лечится тем, что ready объявлен как std::atomic<bool>. Атомарность флага убирает data race, но не закрывает окно между проверкой и засыпанием. В задаче 3.1 вас ждёт именно такой код.
Правило: изменение состояния, которого ждут через condition variable, выполняется под тем же мьютексом, что и ожидание. Без исключений, даже для атомиков.
Ошибка 3: разные мьютексы или состояние вне мьютекса
Вариации предыдущей ошибки: ждут под одним мьютексом, а состояние меняют под другим; или предикат читает данные, которые защищены совсем другим локом. Результат тот же — окно для потерянного уведомления, плюс data race в предикате. Одна condition variable — один мьютекс — одно защищаемое состояние.
3.3. notify_one, notify_all и где их вызывать
notify_one будит одного ждущего (какого — не определено). Используйте, когда изменение состояния может обработать ровно один поток: в очередь положили один элемент.
notify_all будит всех. Используйте, когда изменение важно для всех: очередь закрыли, конфиг загружен, наступил момент «всем стоп». Не используйте его «на всякий случай» в горячем пути: при 32 ждущих потоках один элемент в очереди разбудит всех 32, один заберёт элемент, 31 проверит предикат и снова уснёт. Это называется thundering herd (паническое стадо), и на нагруженных системах оно стоит заметных процентов CPU.
Ошибка в обратную сторону опаснее: notify_one там, где нужен notify_all. Если очередь закрыли и разбудили одного из восьми ждущих потребителей, остальные семь будут ждать вечно.
Уведомлять под локом или после? Оба варианта корректны, если состояние менялось под локом. Но если вызвать notify под локом, проснувшийся поток сразу упрётся в мьютекс, который уведомляющий ещё держит, и уснёт снова, теперь уже на мьютексе. Поэтому обычно делают так:
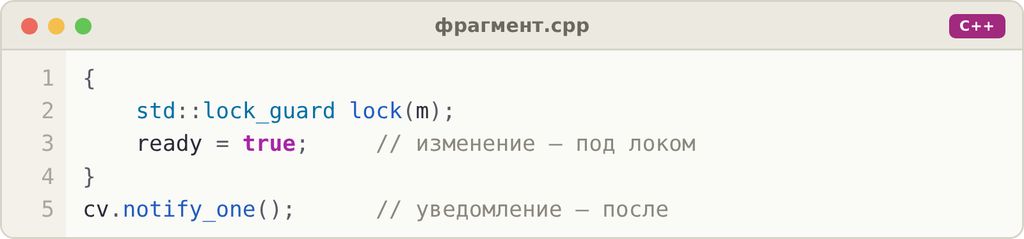
Листинг 3.5 — изменить состояние под локом, уведомить после
Есть одно исключение. Если сразу после уведомления condition variable может быть уничтожена (например, ждущий поток проснётся, увидит флаг и удалит объект, содержащий cv), то notify после освобождения лока может обратиться к уже уничтоженной cv. В таких сценариях уведомляют под локом. Это редкость, но это ровно тот тип бага, который находят в продакшене.
3.4. Ожидание с таймаутом: wait_for и wait_until
Ждать вечно можно не всегда. Для ожидания с ограничением есть две функции:
— wait_for(lock, duration, pred) — ждать не дольше заданной длительности;
— wait_until(lock, time_point, pred) — ждать до заданного момента.
Обе с предикатом возвращают bool: true, если предикат стал истинным, false, если время вышло, а предикат так и остался ложным.

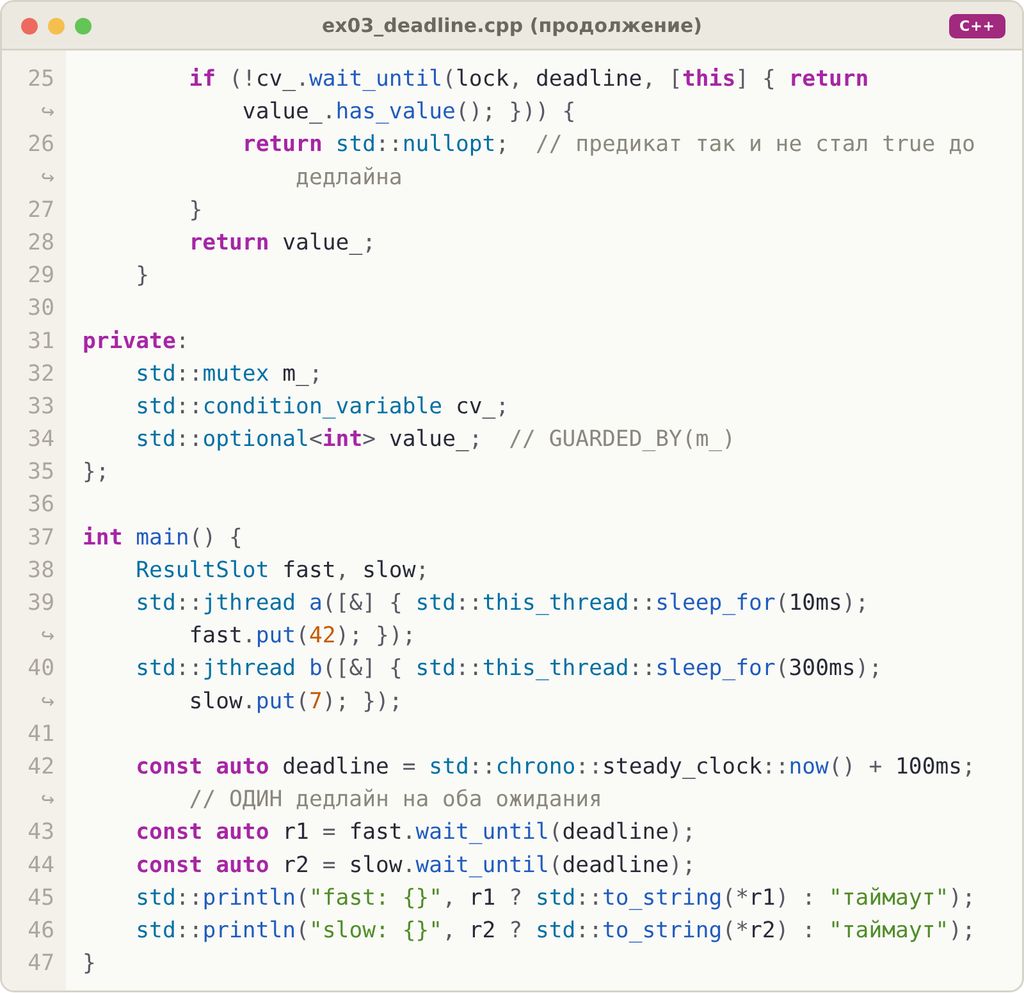
Листинг 3.6 — ожидание с дедлайном (ex03_deadline.cpp)
Почему дедлайн лучше длительности. Представьте функцию, которой дано 100 мс на всё, а она ждёт несколько событий подряд. Если каждое ожидание делать через wait_for(100ms), общая длительность может стать 300 мс. Правильно вычислить дедлайн один раз в начале и ждать до него во всех вызовах. Так и сделано в примере: один дедлайн на оба ожидания.
Та же логика внутри одного ожидания: если вы реализуете цикл ожидания сами и после ложного пробуждения снова зовёте wait_for с той же длительностью, отсчёт начинается заново, и под постоянными ложными пробуждениями поток может не выйти никогда. wait_until с фиксированным моментом от этого защищён. (Перегрузки с предикатом из стандартной библиотеки сделаны правильно, но если пишете цикл руками — помните.)
И, как всегда для таймаутов, используйте steady_clock (глава 2, раздел 2.8).
3.5. condition_variable_any и stop_token
В главе 1 мы увидели проблему: поток, заснувший в блокирующем вызове, не узнает о запросе остановки, пока его не разбудят. Для condition variable в C++20 есть готовое решение. std::condition_variable_any — более общая версия condition_variable, которая работает с любым типом лока и, главное, умеет ждать с stop_token:

Листинг 3.7 — ожидание с stop_token
Такое ожидание просыпается, когда предикат стал истинным или запрошена остановка. Возвращаемое значение — результат предиката: если вернулось false, значит, вас разбудила остановка (или дедлайн), а не событие.
Внутри это сделано через stop_callback, который будит condition variable при request_stop() — ровно тот приём, который мы писали руками для сокетов в главе 1. Плата за удобство — condition_variable_any чуть тяжелее обычной condition_variable (у неё свой внутренний мьютекс). В большинстве случаев это несущественно, но в очень горячих путях имейте в виду.
3.6. Блокирующая очередь
Очередь «производитель — потребитель» — самый распространённый многопоточный паттерн: одни потоки создают задачи, другие их выполняют. Соберём её из всего, что знаем:


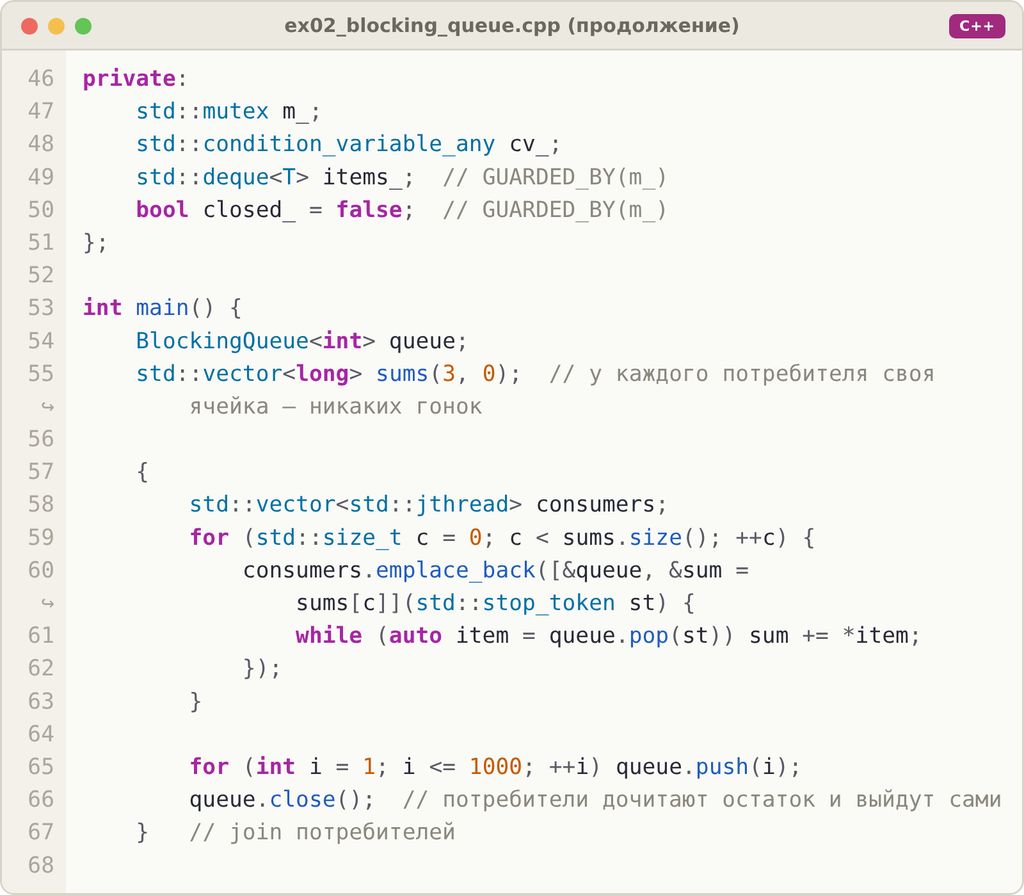
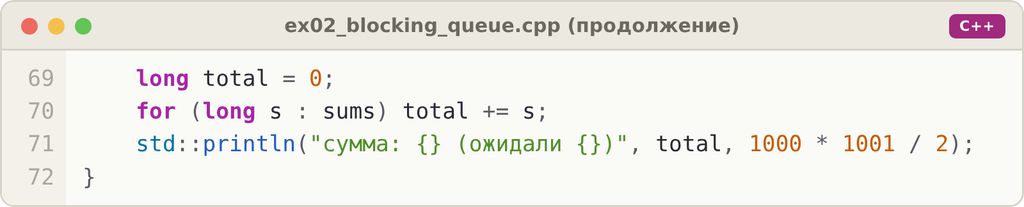
Листинг 3.8 — производитель-потребитель на неограниченной очереди с закрытием (ex02_blocking_queue.cpp)
На что обратить внимание:
— pop возвращает std::optional<T>. Проверка «не пусто ли» и извлечение — одна операция под одним локом (урок главы 2).
— push уведомляет одного, close — всех. Новый элемент может забрать один потребитель; о закрытии должны узнать все.
— После close элементы можно дочитать. Предикат просыпается, если есть элементы ИЛИ очередь закрыта, а pop возвращает nullopt, только когда очередь закрыта и пуста. Ни одна принятая задача не теряется.
— pop принимает stop_token. Потребителя можно остановить, даже если очередь не закрыта и пуста.
— Каждый потребитель пишет результат в свою ячейку. Общий счётчик потребовал бы ещё одного мьютекса; отдельные ячейки, которые читаются после join, — нет.
У этой очереди один серьёзный недостаток: она неограниченная. Если производитель быстрее потребителей, очередь растёт, пока не закончится память. В продакшене это классический сценарий падения под нагрузкой: сервис не тормозит, а копит задачи в памяти, пока его не убьёт OOM killer. Ограниченную очередь, которая заставляет производителя ждать, вы напишете в задаче 3.2, а о стратегиях работы с переполнением (backpressure) поговорим в главе 12.
3.7. Graceful shutdown: как остановить систему потоков
Корректная остановка — одна из самых недооценённых задач. Сервис, который при деплое теряет запросы, зависает на остановке (и его убивают по таймауту через SIGKILL) или падает в деструкторах, — это сервис, который боятся деплоить. А сервис, который боятся деплоить, деплоят в пятницу вечером, когда «ну наконец-то всё готово».
Общая схема для системы «производители → очередь → потребители»:
1. Перестать принимать новую работу. Производители останавливаются (или закрываются входные соединения).
2. Закрыть очередь. close() будит всех потребителей.
3. Дочитать остаток. Потребители обрабатывают то, что уже в очереди, и выходят, когда pop вернул nullopt.
4. Дождаться потребителей. join (в нашем случае — деструкторы jthread).
5. Только после этого разрушать общие ресурсы, которыми пользовались потоки.
Если нужно остановиться быстро и потерять остаток допустимо, вместо шага 3 используется stop_token: потребители выходят сразу, не дочитывая. Какая стратегия правильная, решает бизнес: потерять задачу «отправить письмо» неприятно, потерять задачу «списать деньги» недопустимо.
Порядок шагов важен. Закрыть очередь до остановки производителей — значит, часть задач отвергнется (push вернёт false), и производители должны уметь это обработать. Разрушить ресурсы до join потребителей — use-after-free, о котором мы говорили в главе 1.
3.8. Грабли с ревью
— wait без предиката (или через if, а не while).
— Изменение состояния без мьютекса, «потому что оно атомарное».
— notify_one при закрытии или остановке, когда ждущих может быть несколько.
— notify_all на каждый элемент в горячем пути.
— Предикат, который читает данные под другим мьютексом или вообще без него.
— wait_for в цикле с той же длительностью вместо дедлайна.
— Ожидание, которое нельзя прервать при остановке сервиса.
— Неограниченная очередь между компонентами с разной скоростью.
— sleep_for как синхронизация: «подождём, пока поток успеет».
3.9. Что спросят на собеседовании
Зачем condition variable нужен мьютекс? (middle) Чтобы проверка состояния и засыпание были атомарны относительно изменения состояния. Без этого возможен lost wakeup. Мьютекс защищает состояние, cv только будит.
Что такое spurious wakeup и как с ним бороться? (middle) Пробуждение без notify, разрешённое стандартом. Бороться — всегда проверять предикат в цикле (перегрузка wait с предикатом).
Что такое lost wakeup? (middle/senior) Уведомление, отправленное, когда ещё никто не ждал. Возникает, если состояние меняется без того мьютекса, под которым ждут. Хороший ответ: «атомарный флаг не спасает» — и объяснение, почему.
notify_one или notify_all? (middle) notify_one, когда событие может обработать один поток; notify_all, когда событие важно всем (закрытие, остановка). Бонус: thundering herd.
Уведомлять под локом или после? (senior) Оба корректны; после — эффективнее (проснувшийся не упрётся в мьютекс); под локом — когда cv может быть уничтожена сразу после пробуждения ждущего.
Почему wait_until лучше wait_for? (senior) Дедлайн не сдвигается при повторных ожиданиях и ложных пробуждениях. Общий бюджет времени на операцию соблюдается.
Как корректно остановить пул потребителей? (senior) Перестать принимать работу, закрыть очередь, разбудить всех, дочитать остаток (или выйти по stop_token), дождаться потоков, потом освобождать ресурсы. Сильный ответ обсуждает, какие задачи допустимо потерять.
3.10. Сквозной проект shardkv, шаг 3: TTL и поток, который спит ровно сколько нужно
Что делаем:
— команды EXPIRE и PEXPIRE (время жизни в секундах и миллисекундах), TTL и PTTL (сколько осталось) с семантикой Redis: −2 — ключа нет, −1 — ключ без времени жизни;
— SET снимает время жизни, INCR сохраняет;
— ленивое истечение: любая операция с ключом сначала проверяет, не истёк ли он;
— активное истечение: фоновый поток удаляет истёкшие ключи, даже если к ним никто не обращается. Без этого ключи с TTL, которые больше никто не читает, копились бы в памяти вечно.
Изначально в плане книги этот шаг включал и ограниченную очередь между приёмом соединений и обработчиками. Я перенёс её в главу 7, где появится пул потоков: сейчас она потребовала бы переделать модель «поток на соединение», а заодно выдала бы решение задачи 3.2.
Как устроен фоновый поток
Наивное решение — проверять все ключи раз в секунду. Оно плохое по двум причинам: при миллионе ключей каждая проверка дорогая, а точность истечения — до секунды. Правильное решение:
— дедлайны хранятся в мин-куче (std::priority_queue), на вершине — ближайший;
— поток спит через wait_until ровно до ближайшего дедлайна;
— если появился дедлайн раньше текущего ближайшего, expire() будит поток через notify, и тот пересчитывает время сна;
— если дедлайн стал не ближайшим, будить поток не нужно: он и так проснётся вовремя;
— остановка через stop_token работает, даже если поток спит до дедлайна через час.
Тонкость: запись в куче может устареть. Ключу назначили TTL, а потом его перезаписали через SET (TTL снят) или назначили новый TTL. Удалять запись из середины priority_queue нельзя, поэтому мы оставляем её и при извлечении сверяем: совпадает ли дедлайн в куче с текущим expires_at ключа. Не совпадает — запись просто выбрасывается.
Код хранилища
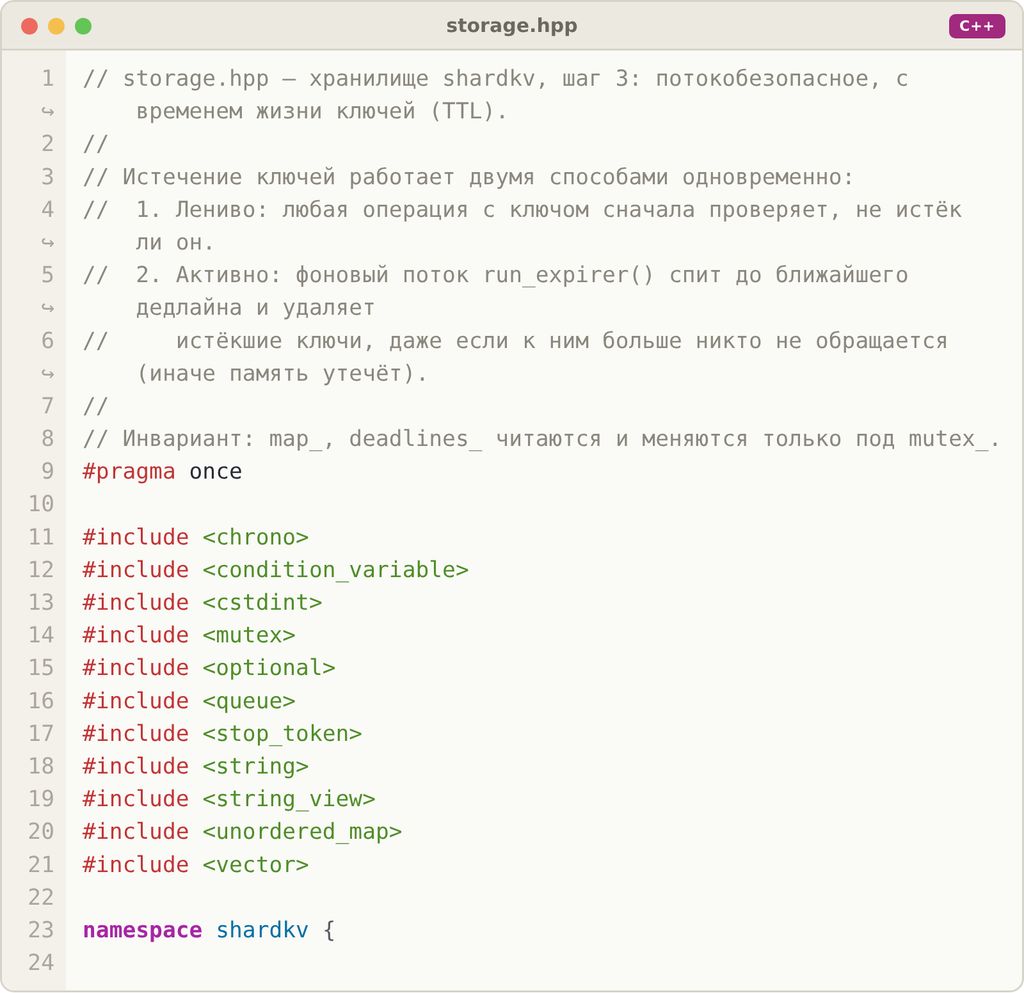

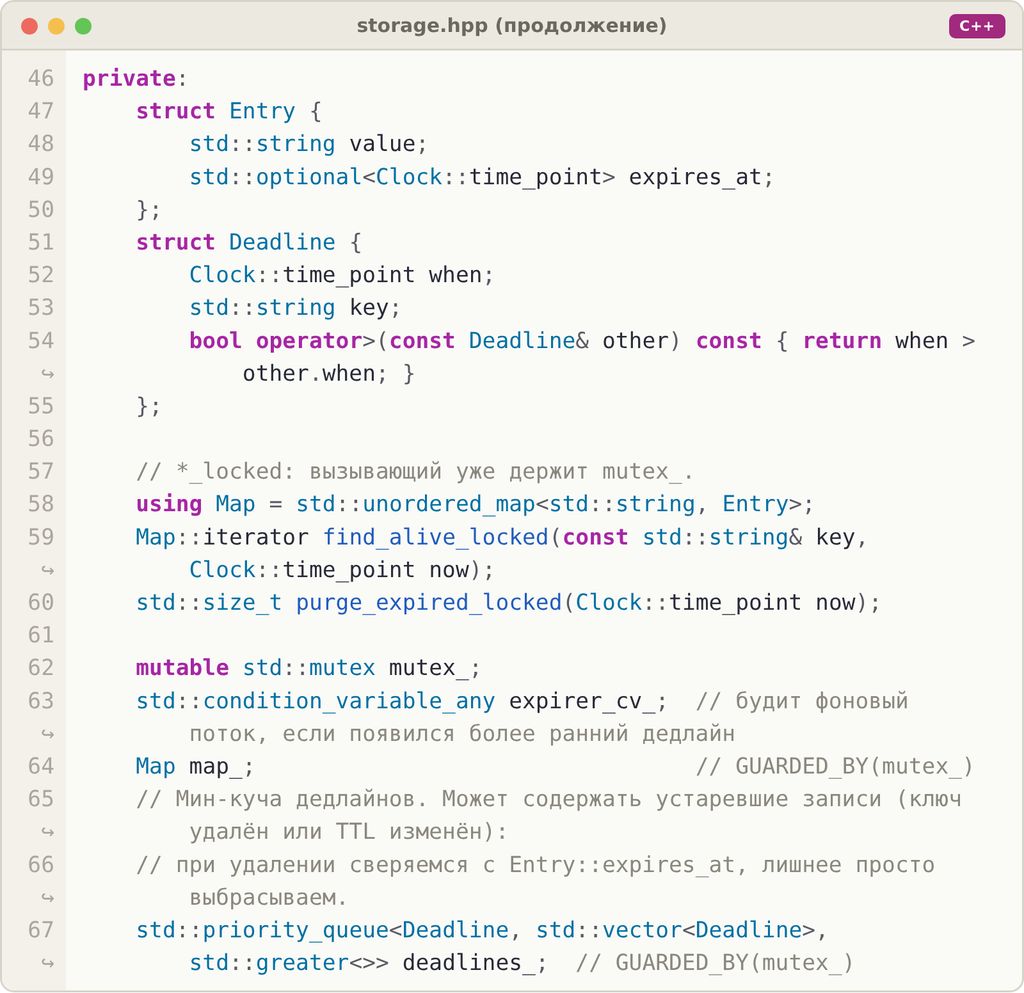

Листинг 3.9 — хранилище shardkv, шаг 3 (storage.hpp)
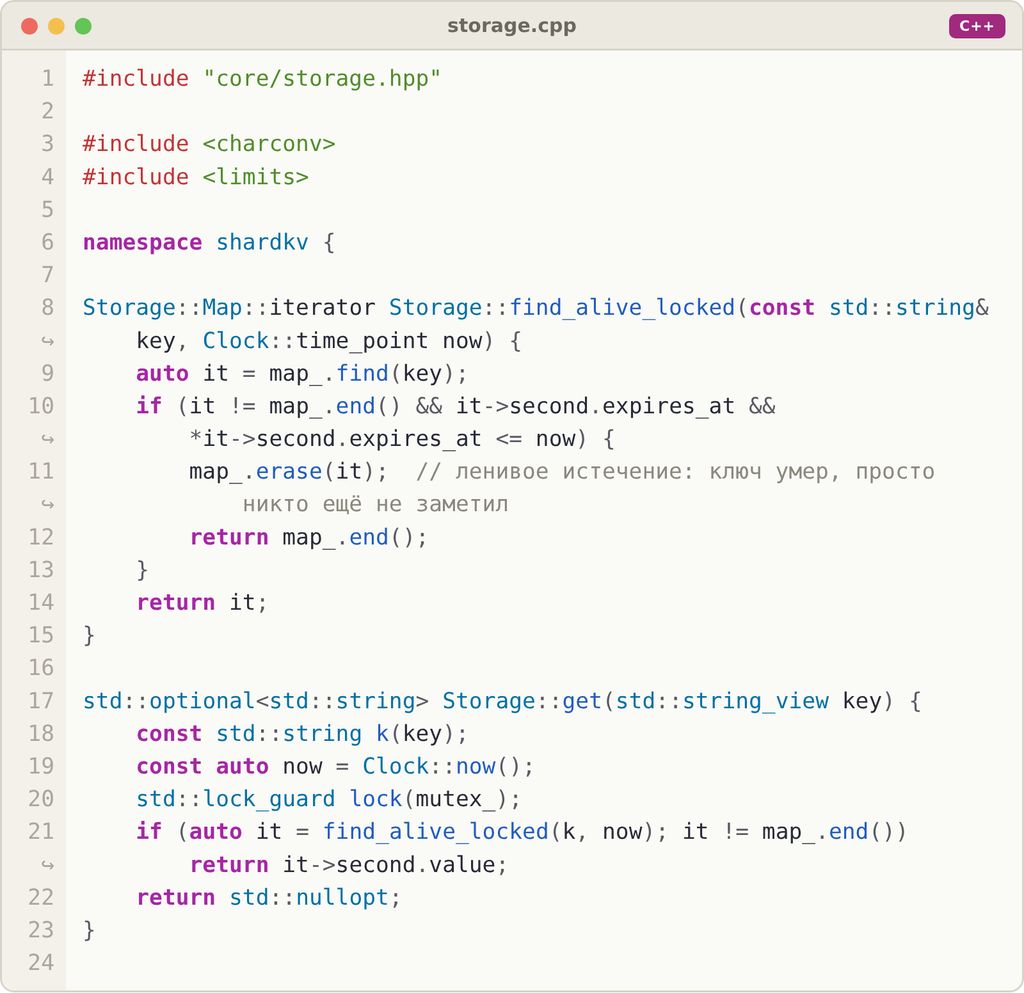
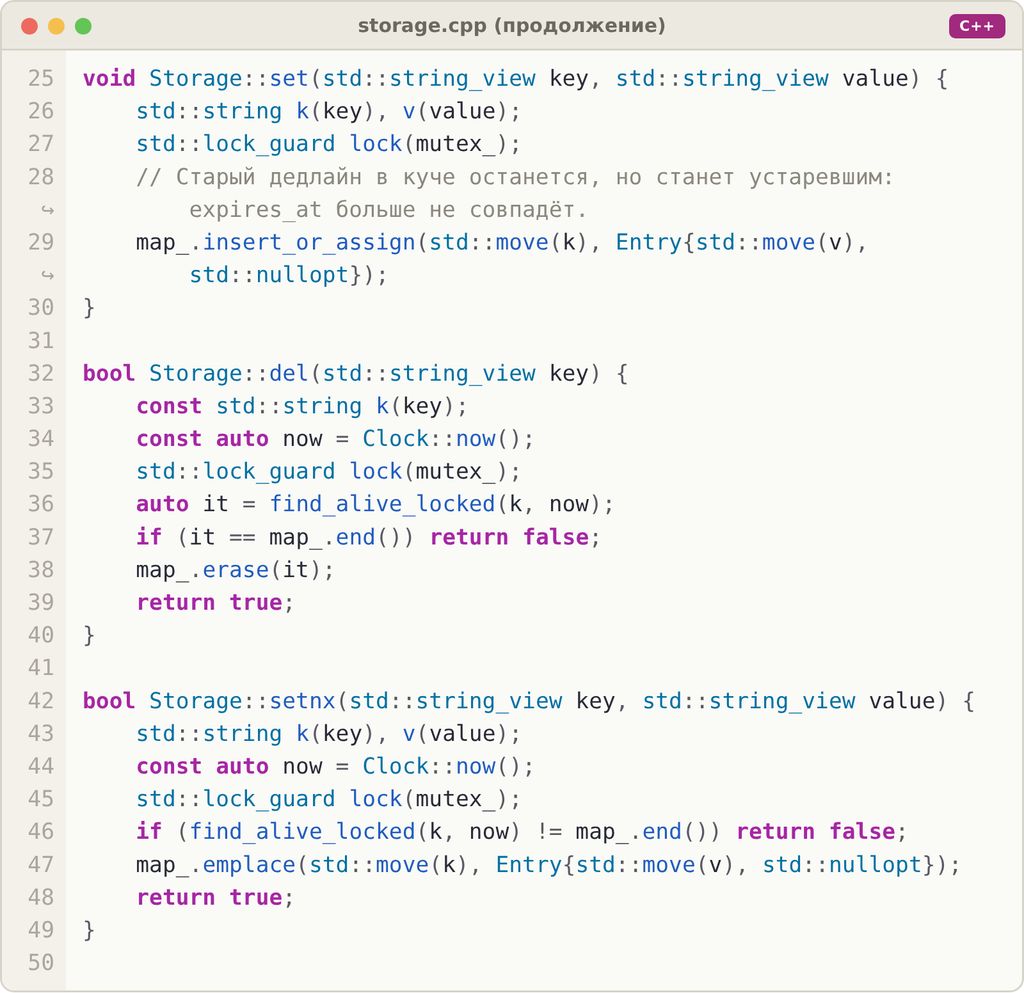
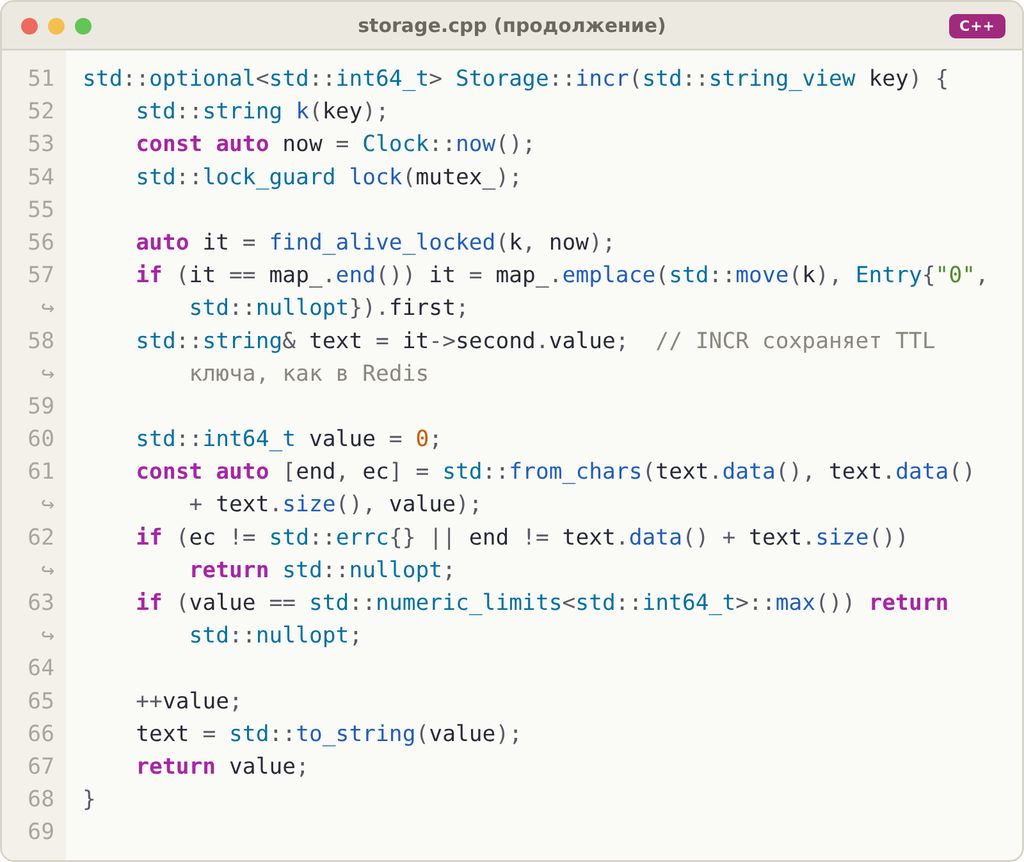

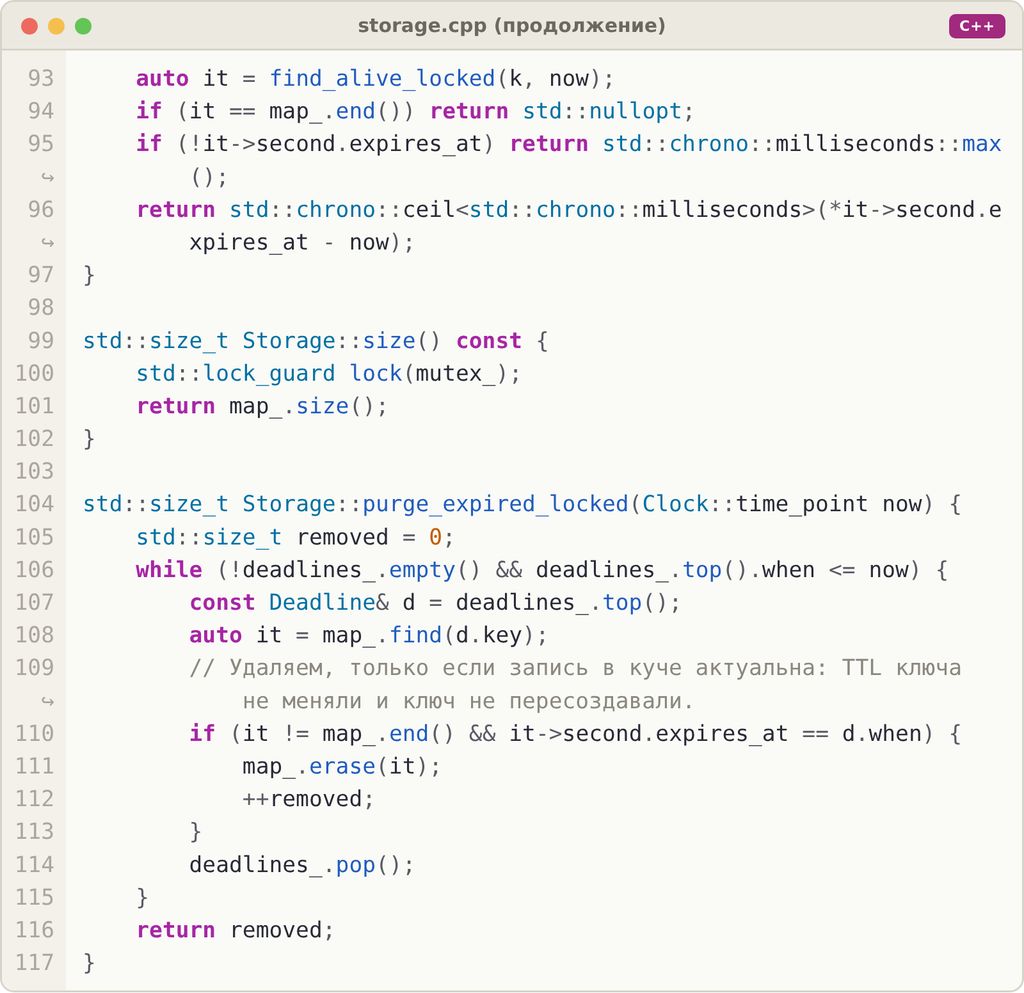
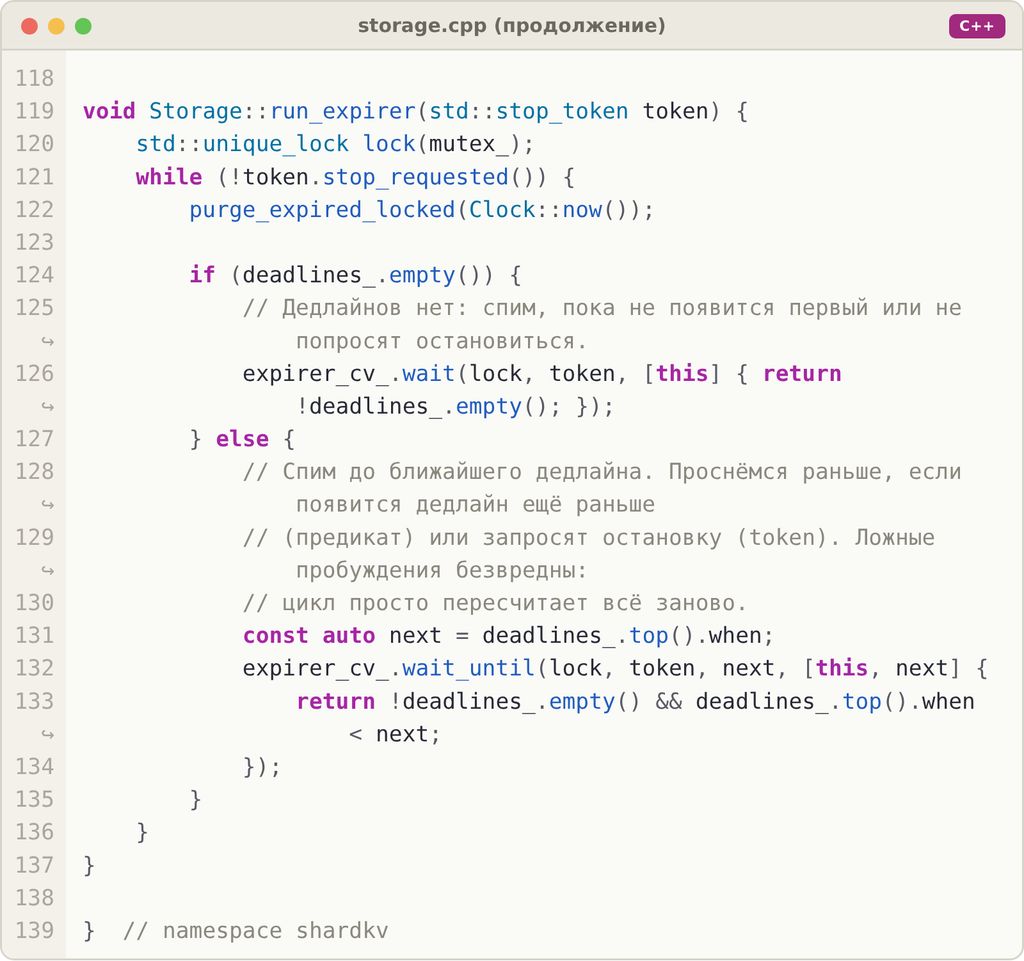
Листинг 3.10 — реализация (storage.cpp)
Что стоит разобрать подробно:
— run_expirer держит мьютекс почти всё время, кроме сна. wait_until отпускает его на время сна, поэтому клиенты не блокируются. Но очистка (purge_expired_locked) идёт под мьютексом, и если одновременно истечёт миллион ключей, все клиенты подождут. В Redis эту проблему решают, ограничивая работу за один проход; для нашего масштаба это преждевременная оптимизация, но держите её в голове.
— expire будит поток только при новом ближайшем дедлайне и делает notify после освобождения лока.
— Предикат в wait_until — «появился дедлайн раньше того, до которого я сплю». Если поток проснулся ложно или по таймауту, цикл просто пересчитает всё заново: purge, затем новое ожидание.
— get теперь не const. Ленивое истечение удаляет ключ, то есть get может менять хранилище. Делать map_ mutable ради сохранения const было бы обманом: const-метод, который меняет видимое состояние, сбивает с толку и тех, кто читает код, и тех, кто рассуждает о потокобезопасности.
Протокол и запуск
В протокол добавлены команды EXPIRE, PEXPIRE, TTL, PTTL (полный код — в архиве главы). В main.cpp появился фоновый поток:
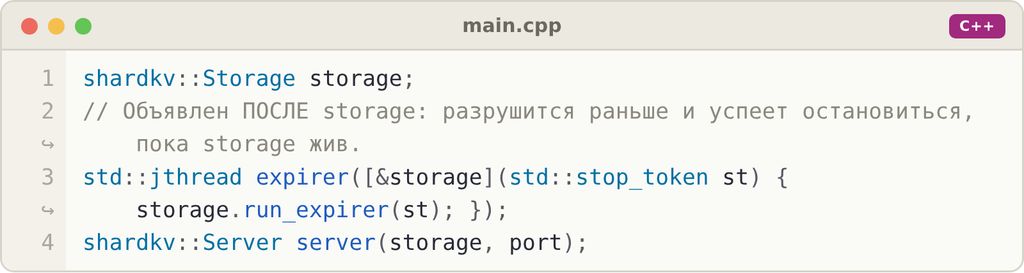
Листинг 3.11 — порядок объявления storage и expirer (main.cpp)
Порядок объявления — опять тот же урок, что в главе 1: поток должен разрушиться раньше данных, которыми пользуется.
Тесты
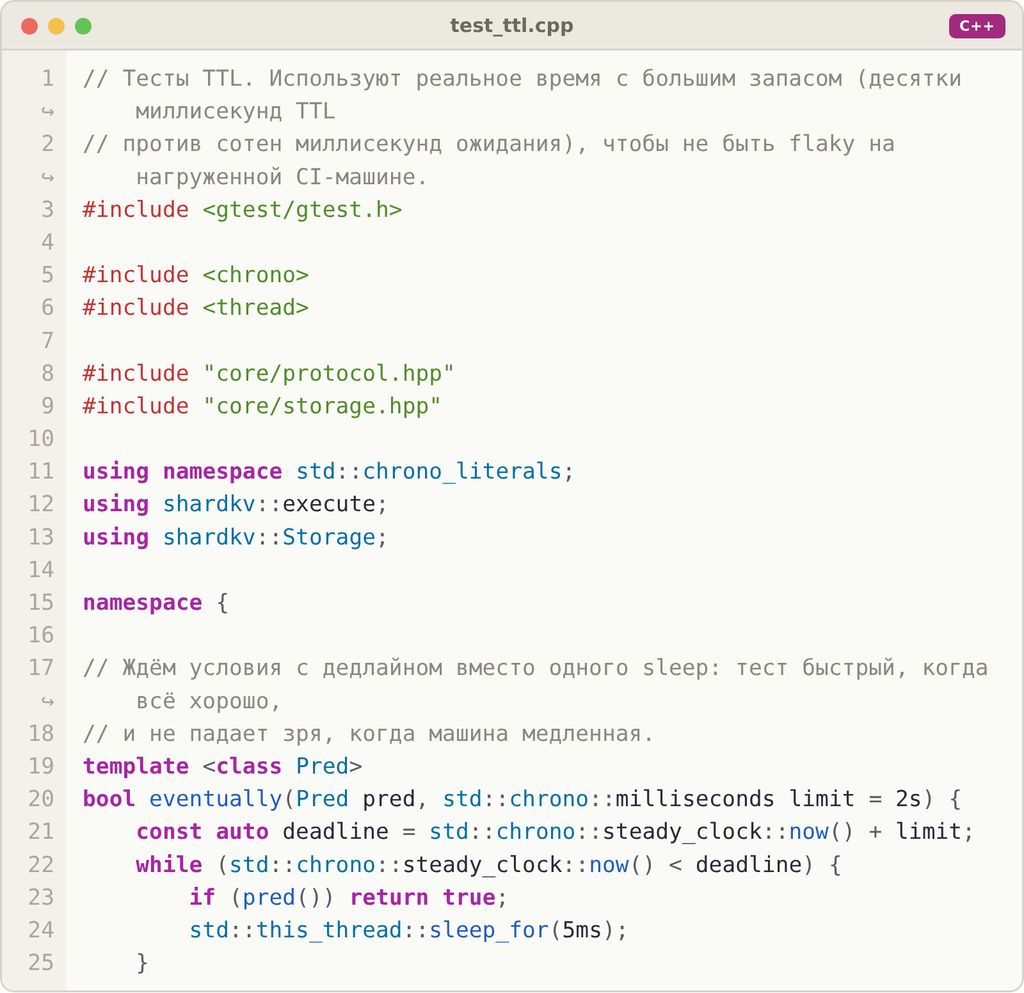
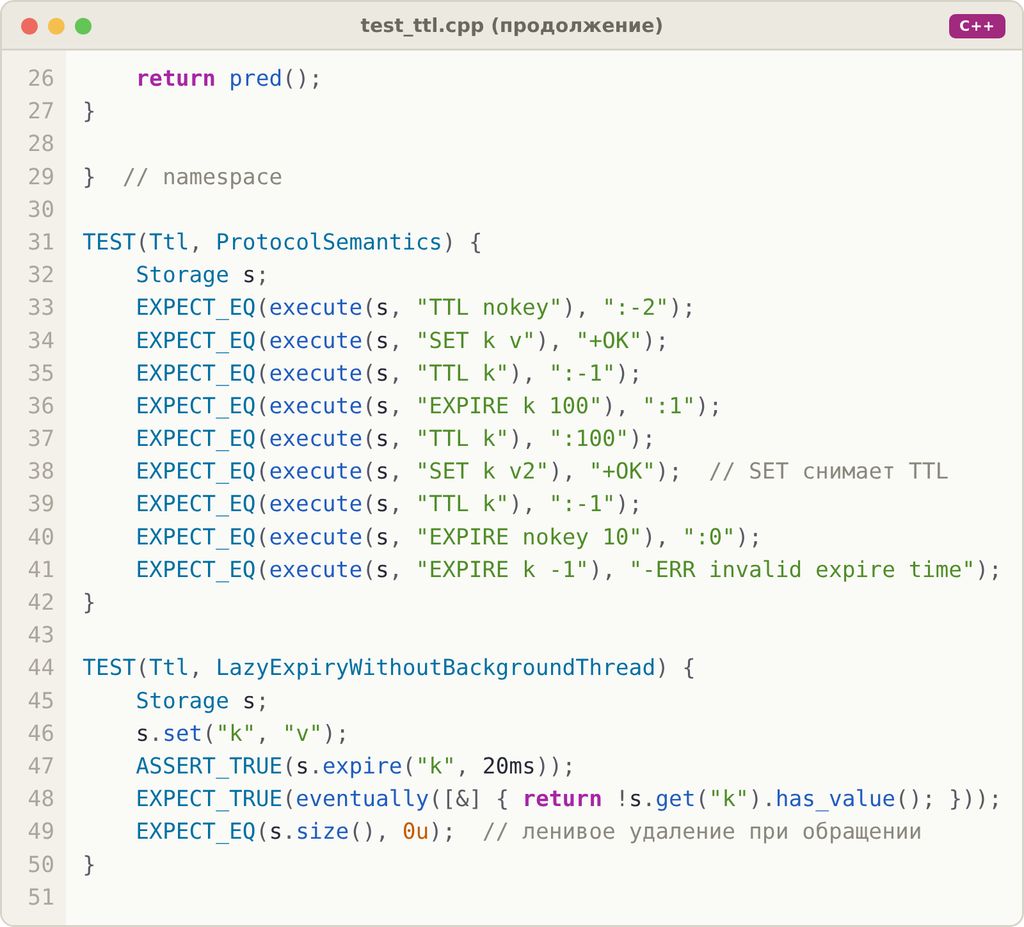
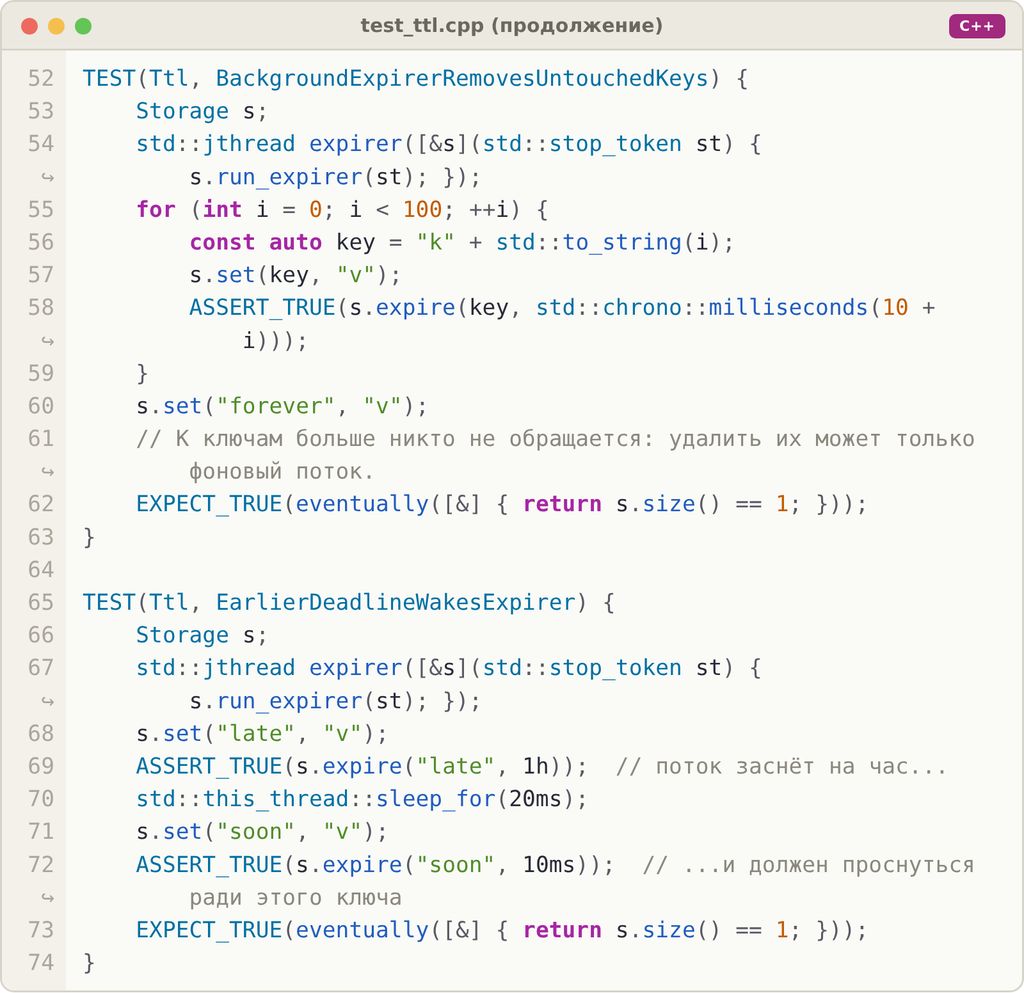
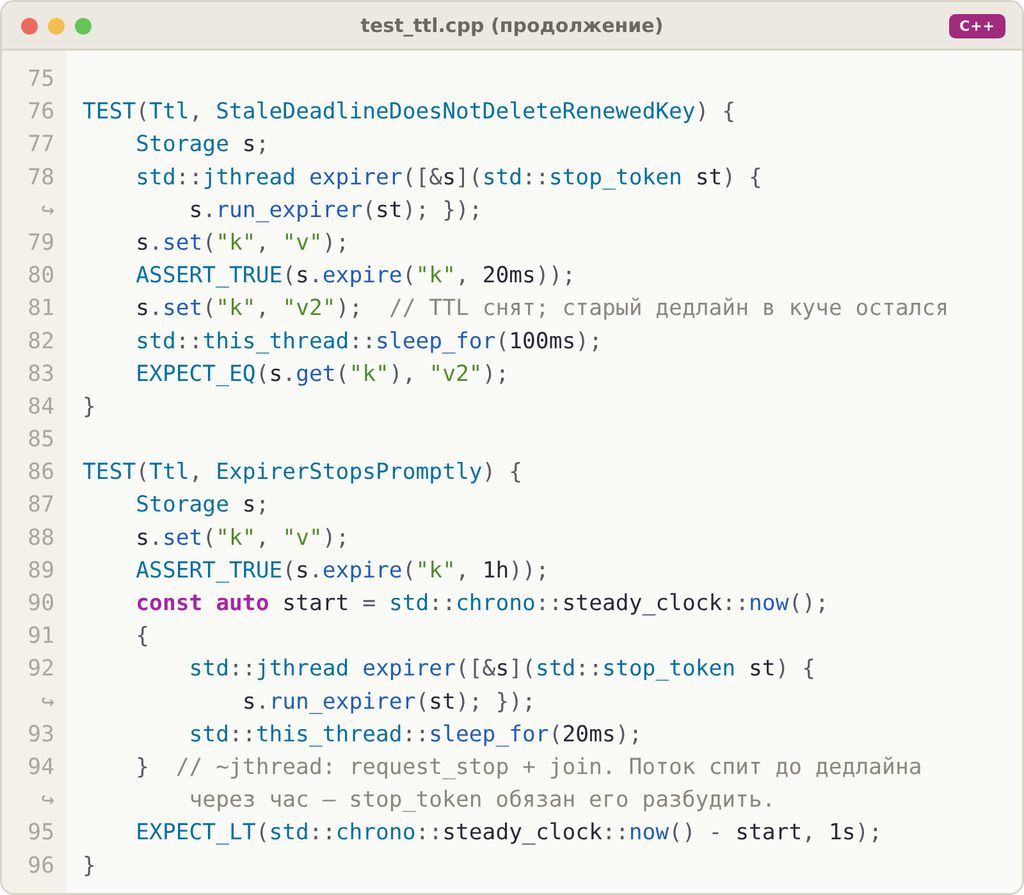
Листинг 3.12 — тесты (test_ttl.cpp)
Обратите внимание на функцию eventually. Тесты, завязанные на время, — главный источник flaky-тестов. Плохой вариант: sleep_for(100ms), потом проверка. На медленной CI-машине 100 мс не хватит, и тест упадёт. Хороший вариант: проверять условие в цикле до щедрого дедлайна. Когда всё работает, тест заканчивается за миллисекунды; когда машина медленная, тест подождёт, а не упадёт зря.
Тест EarlierDeadlineWakesExpirer проверяет главную многопоточную логику: поток заснул на час, а потом появился ключ, который истекает через 10 мс. Если expire не разбудит поток, тест не дождётся удаления. А ExpirerStopsPromptly проверяет, что stop_token будит поток, спящий до далёкого дедлайна.
Все тесты проходят под TSan и ASan 10 раз подряд.
Замеры
Добавили ли TTL накладные расходы на обычные GET и SET? Сравним шаг 2 и шаг 3 тем же kvbench (4 клиента, режим mix, три прогона подряд):

Таблица 3.1 — накладные расходы TTL: шаг 2 и шаг 3, ops/s
Вывод: разница между шагами меньше, чем разброс между прогонами одной и той же версии (от 102 до 141 тысячи). Значит, по этим данным мы не можем сказать, что TTL что-то замедлил. Это нормальный и важный результат. Типичная ошибка — запустить бенчмарк по разу, увидеть 141 против 106 и написать в отчёте «оптимизация дала +33%». Без нескольких прогонов и оценки разброса любые цифры бенчмарка — гадание на кофейной гуще.
Задачки для разминки мозгов
Задача 3.1 (лёгкая). Потерянное пробуждение


Листинг 3.13 — код к задаче 3.1 (task3_1_lost_wakeup.cpp)
Эта программа зависает. У меня — каждый запуск, но на вашей машине может понадобиться несколько. Флаг атомарный, notify вызывается — почему поток спит вечно?
Нарисуйте трассу событий двух потоков (как в разделе 3.2), которая приводит к зависанию. Найдите все проблемы в коде (их больше одной) и исправьте.
Проверка: исправленная программа проходит 100 000 итераций без зависаний, 10 запусков подряд, под TSan; трасса показывает конкретное окно, в которое попадает notify.
Задача 3.2 (средняя). BoundedQueue
Напишите шаблон ограниченной блокирующей очереди BoundedQueue<T> с ёмкостью, заданной в конструкторе:

Листинг 3.14 — интерфейс BoundedQueue<T>
Требования:
— push блокируется, когда очередь заполнена, и просыпается, когда место освободилось;
— после close() оставшиеся элементы можно дочитать, затем pop возвращает nullopt;
— производители, ждущие свободного места, при close() просыпаются и получают false;
— подумайте, сколько condition variable вам нужно и почему.
Проверка: тесты на порядок элементов (FIFO для одного производителя), на блокировку при заполнении, на таймаут try_pop_for, на закрытие при ждущих производителях и потребителях; стресс-тест 4 на 4 потока, ёмкость 8, каждый элемент получен ровно один раз; всё под TSan 10 раз подряд.
Задача 3.3 (средняя). Пинг-понг и хоровод
Два потока по очереди печатают ping и pong, N раз каждый, строго чередуясь: ping, pong, ping, pong…
Затем обобщите: K потоков с номерами 0..K−1 печатают свои номера строго по кругу (0, 1, 2, …, K−1, 0, 1, …), всего N кругов.
Требования: никакого активного ожидания (sleep в цикле или пустой цикл не годятся), никаких глобальных переменных.
Проверка: вывод собирается в вектор и сравнивается в тесте с ожидаемой последовательностью; при K = 8, N = 10 000 загрузка CPU во время работы низкая (потоки спят, а не крутятся); TSan чист. Подумайте, что произойдёт с производительностью при notify_all и при notify_one, и объясните, почему в одном из этих вариантов программа может зависнуть.
Решения и разбор ваших неизбежных ошибок — в главе «Ответы к задачам» в конце книги.
Глава 4. Железо и ОС: что на самом деле происходит под std::mutex
«Гонок нет, локов нет, а работает в шесть раз медленнее». Добро пожаловать в мир кеш-линий.
Первые три главы мы работали с абстракциями: поток, мьютекс, условная переменная. Абстракции хороши, пока не начинаешь мерить. А когда начинаешь, выясняется, что два потока, которые не делят ни одной переменной, мешают друг другу в шесть раз; что незахваченный мьютекс стоит наносекунды, а захваченный — микросекунды; что сигнал SIGTERM прилетает в случайный поток и может прервать его посреди malloc.
Эта глава — экскурсия на один уровень вниз: процессор, кеши, планировщик, сигналы. Не ради эрудиции, а потому что без этой модели в голове невозможно ни объяснить модель памяти C++ (глава 5), ни понять результаты бенчмарков, ни ответить на senior-собеседовании на вопрос «почему ваш шардированный кеш не масштабируется дальше 8 ядер».
К концу главы вы:
— поймёте, как устроены кеши и почему процессор работает с кеш-линиями, а не байтами;
— научитесь находить и устранять false sharing;
— узнаете, что такое store buffer и почему процессор «переставляет» операции с памятью;
— поймёте, как устроен мьютекс в Linux (futex) и сколько он стоит;
— освоите законы Амдала и Густафсона — главные «отрезвители» в разговорах о масштабировании;
— научитесь привязывать потоки к ядрам и узнаете, когда это вредно;
— поймёте, чем опасен fork() в многопоточной программе;
— научитесь правильно обрабатывать сигналы в многопоточном процессе;
— разобьёте хранилище shardkv на шарды и научите сервер останавливаться по SIGTERM.
4.1. Кеши и кеш-линии
Обращение к оперативной памяти занимает порядка 100 нс. За это время современное ядро могло бы выполнить сотни инструкций. Поэтому между ядром и памятью стоит иерархия кешей:
— L1 — свой у каждого ядра, десятки килобайт, доступ за несколько тактов;
— L2 — обычно свой у каждого ядра, от сотен килобайт до пары мегабайт, около десятка тактов;
— L3 — общий для всех ядер процессора, десятки мегабайт, несколько десятков тактов;
— память — гигабайты, сотни тактов.
Главное, что нужно запомнить: кеш работает блоками фиксированного размера — кеш-линиями. На x86-64 и большинстве ARM это 64 байта (на Apple M-серии — 128). Когда вы читаете один байт, процессор загружает всю линию, в которой он лежит. Когда вы пишете один байт, процессор должен получить всю линию в своё эксклюзивное владение.
Это легко увидеть:

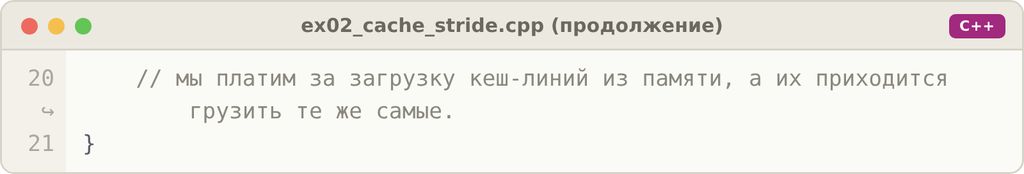
Листинг 4.1 — процессор читает память кеш-линиями, а не байтами (ex02_cache_stride.cpp)
На моей машине:
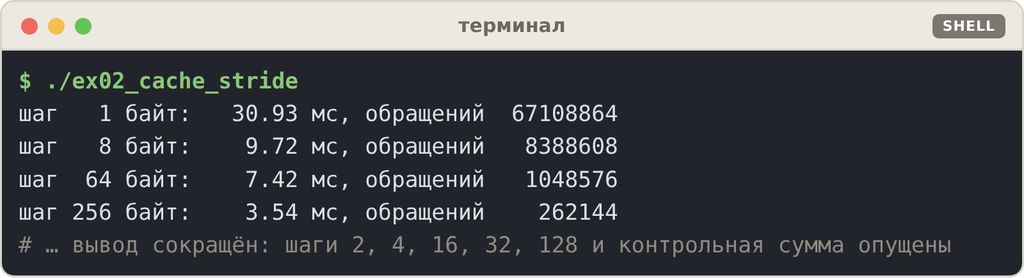
Листинг 4.2 — стоимость обращений с разным шагом
От шага 1 до шага 64 обращений стало в 64 раза меньше, а время упало только в 4 раза. Потому что мы платим не за обращения, а за загрузку кеш-линий, и их приходится загружать те же самые. (После шага 64 время продолжает падать, но не пропорционально: в игру вступает аппаратный префетчер, который угадывает следующие линии заранее. Железо сложнее любой модели, поэтому мы и меряем.)
Отсюда первое правило производительности: данные, которые используются вместе, должны лежать рядом (массив структур, std::vector вместо std::list). А в многопоточном коде появляется второе правило, и оно хитрее.
4.2. Когерентность кешей и false sharing
Если у каждого ядра свой кеш, что будет, когда два ядра работают с одной и той же линией? Процессор гарантирует когерентность: все ядра видят согласованное содержимое каждой линии. На x86 для этого используется протокол семейства MESI. Каждая линия в каждом кеше находится в одном из состояний:
— Modified — линия изменена этим ядром и есть только у него;
— Exclusive — линия есть только у этого ядра, не изменена;
— Shared — линия есть у нескольких ядер, только для чтения;
— Invalid — копия недействительна.
Чтобы записать в линию, ядро должно перевести её в Modified, а для этого — инвалидировать копии во всех остальных кешах. Если два ядра поочерёдно пишут в одну линию, она постоянно «перепрыгивает» между ними: каждая запись требует обмена сообщениями между ядрами. Это называют ping-pong кеш-линии.
Самое коварное: ядрам не обязательно писать в одну и ту же переменную. Достаточно писать в разные переменные, которые лежат в одной линии. Это и есть false sharing (ложное разделение):


Листинг 4.3 — у каждого потока свой счётчик (ex01_false_sharing.cpp)
Результат на моей машине:
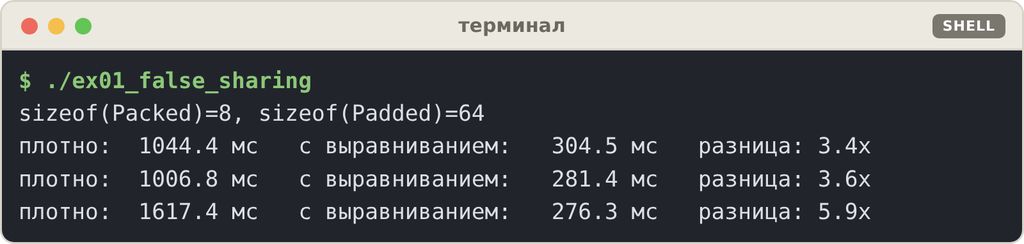
Листинг 4.4 — false sharing: плотные и выровненные счётчики
Два потока, у каждого свой счётчик, никаких общих данных с точки зрения программы, — и разница в 3,4–6 раз. Лечение — разложить данные, которые пишут разные потоки, по разным кеш-линиям: alignas(64) или явный padding.
hardware_destructive_interference_size
В C++17 появилась константа std::hardware_destructive_interference_size из <new> — минимальное расстояние между объектами, чтобы избежать false sharing. Две оговорки:
— не все стандартные библиотеки её предоставляют (проверяйте макрос __cpp_lib_hardware_interference_size);
— GCC предупреждает при её использовании (-Winterference-size): значение зависит от флагов -mtune/-mcpu, и если оно попадёт в ABI (например, в размер структуры в заголовке библиотеки), разные единицы трансляции могут разойтись.
Практичное решение — своя константа с запасным значением:
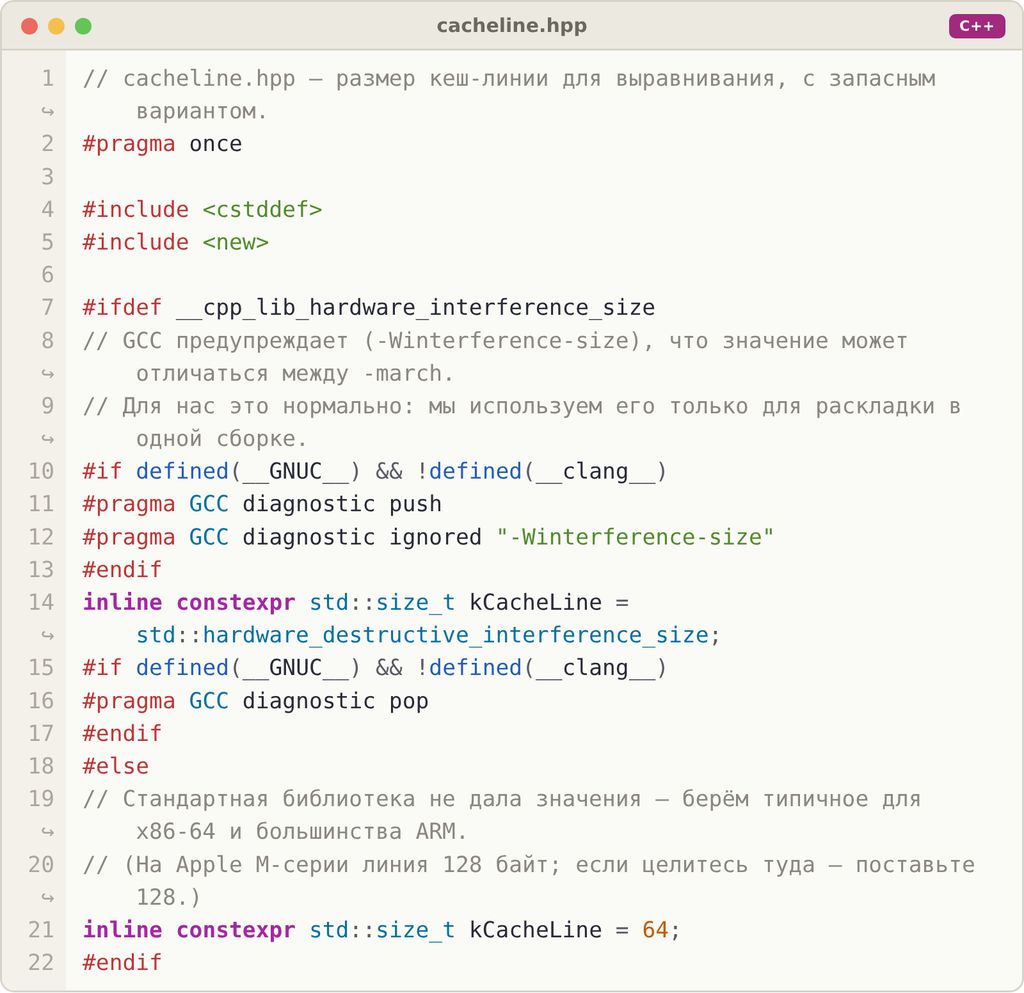
Листинг 4.5 — размер кеш-линии для выравнивания, с запасным вариантом (cacheline.hpp)
Где искать false sharing
— массивы структур «по одной на поток»: счётчики, статистика, локальные буферы;
— мьютекс и защищаемые им данные рядом с мьютексом другого объекта (массив шардов, у каждого свой мьютекс — наш случай в шаге 4);
— флаг остановки рядом с часто изменяемыми полями;
— атомарный счётчик ссылок рядом с данными, которые читают все (это одна из причин, почему std::shared_ptr под нагрузкой бывает медленным).
И не нужно выравнивать всё подряд: каждая структура размером 64 байта вместо 8 — это в 8 раз больше памяти и меньше данных в кеше. Выравнивают только то, что разные потоки часто пишут.
4.3. Store buffer: почему процессор «переставляет» операции
Запись в память даже через кеш — дорогая операция: нужно получить линию в эксклюзивное владение. Чтобы не ждать, каждое ядро складывает записи в свой store buffer — маленькую очередь, — и продолжает выполнять следующие инструкции. Запись попадает в кеш (и становится видна другим ядрам) чуть позже.
Последствие: другое ядро может увидеть ваши операции не в том порядке, в котором они написаны в программе. Классический пример (store-load reordering):
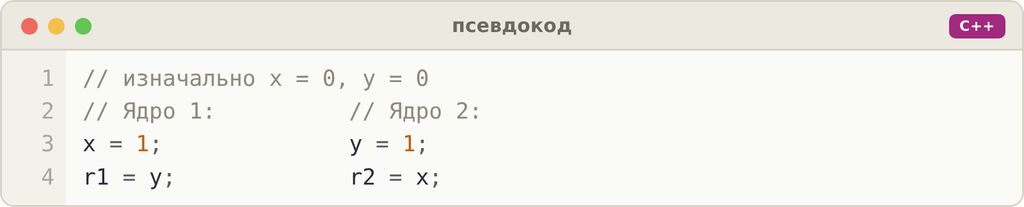
Листинг 4.6 — переупорядочивание записи и чтения на двух ядрах
Интуиция говорит: хотя бы одно из r1, r2 будет равно 1. Но на реальном x86 возможен результат r1 == 0 и r2 == 0: обе записи ещё лежат в store buffer'ах, а чтения уже выполнились из кеша. Вы поймаете этот эффект своими руками в задаче 4.2.
Разные архитектуры разрешают разные перестановки. x86 довольно строгий: он переставляет только «запись, потом чтение другого адреса». ARM и POWER разрешают почти всё. Поэтому код, который «годами работал на x86», ломается при переезде на ARM-сервера или Apple Silicon.
Но писать код под конкретный процессор не нужно. Модель памяти C++ абстрагирует всё это: вы описываете, какие гарантии упорядочивания нужны (memory_order), а компилятор вставляет нужные барьеры для конкретной архитектуры. Мьютексы делают это за вас автоматически. Подробно — в главе 5.
4.4. Как устроен мьютекс в Linux: futex
Как можно сделать мьютекс, который почти ничего не стоит, когда свободен? В Linux ответ — futex (fast userspace mutex). Идея:
— состояние мьютекса — обычное целое число в памяти процесса (0 — свободен, 1 — захвачен, 2 — захвачен и есть ждущие);
— захват без конкуренции: одна атомарная операция compare-and-swap 0 → 1, полностью в пространстве пользователя. Никаких системных вызовов;
— захват при конкуренции: если CAS не удался, поток (обычно после короткого активного ожидания) вызывает системный вызов futex(FUTEX_WAIT), и ядро усыпляет его;
— освобождение: атомарная запись 0; если были ждущие — системный вызов futex(FUTEX_WAKE), чтобы разбудить одного.
Померим:
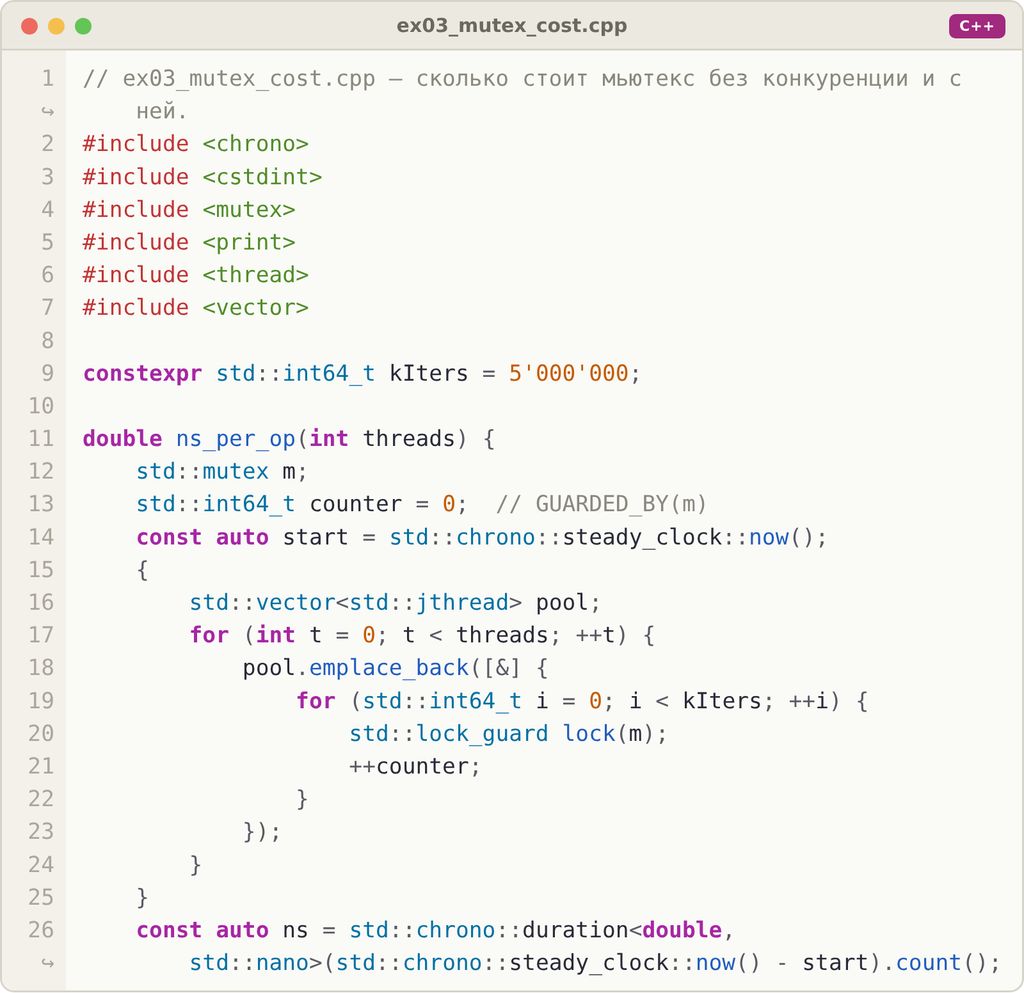

Листинг 4.7 — сколько стоит мьютекс без конкуренции и с ней (ex03_mutex_cost.cpp)
(Цифры с виртуальной машины; на голом железе захват без конкуренции обычно в разы быстрее.) Даже на этом простом примере видно: при конкуренции каждая операция дороже в 2–3 раза, а ведь критическая секция здесь — один инкремент. Когда секции длиннее, а потоки засыпают в ядре, разница достигает микросекунд: переключение контекста, холодные кеши после пробуждения.
Отсюда вывод для проектирования: проблема не в мьютексах, а в конкуренции за них. Сотня мьютексов, на которых никто не сталкивается, дешевле одного, на котором толкаются все. Это ровно та идея, на которой построен шаг 4 проекта.
4.5. Законы Амдала и Густафсона
Закон Амдала. Если доля работы p распараллеливается идеально, а доля (1 − p) выполняется последовательно, то максимальное ускорение на N ядрах:
S(N) = 1 / ((1 — p) + p / N)
Если 95% работы параллельны, то на бесконечном числе ядер ускорение не превысит 1 / 0,05 = 20. Если параллельно 90% — не больше 10. Последовательная часть программы (в том числе критические секции под глобальным мьютексом!) задаёт потолок, который не пробить никаким количеством ядер.
Практический смысл: глобальный мьютекс в shardkv из шага 2 — это последовательная часть. Все операции с хранилищем выполнялись по одной. Сколько ни добавляй ядер, быстрее одного ядра хранилище работать не будет.
Закон Густафсона — оптимистичный взгляд с другой стороны: на практике с ростом числа ядер растёт и объём задачи (больше пользователей, больше данных), а последовательная часть часто остаётся прежней. Тогда ускорение на «большей задаче» почти линейно.
Оба закона верны, они отвечают на разные вопросы. Амдал: «насколько быстрее станет та же задача?» Густафсон: «насколько бо́льшую задачу я решу за то же время?» На собеседовании полезно знать оба и уметь сказать, какой из них применим в обсуждаемой ситуации.
4.6. NUMA
На серверах с несколькими процессорными сокетами память физически разделена: у каждого сокета своя «ближняя» память. Обращение к «дальней» памяти (подключённой к другому сокету) заметно дороже. Это называется NUMA (non-uniform memory access).
Что важно знать:
— Linux по умолчанию выделяет физическую память на том узле, где поток впервые к ней обратился (first touch). Если главный поток инициализировал огромный массив, вся память оказалась на его узле, и рабочие потоки на другом сокете будут постоянно ходить в дальнюю память;
— поток, который планировщик перенёс на другой сокет, теряет и кеши, и близость к своей памяти;
— false sharing между сокетами стоит ещё дороже, чем внутри одного процессора.
Инструменты: numactl для запуска с политикой размещения, lscpu и numactl --hardware для просмотра топологии. На ноутбуке и в большинстве облачных виртуалок NUMA-узел один (у меня тоже), и эти эффекты не видны. На двухсокетном сервере базы данных — ещё как видны.
4.7. Планировщик, приоритеты и привязка к ядрам
Стандартный C++ ничего не знает о приоритетах потоков и ядрах. Когда это нужно, используется native_handle() — нативный дескриптор потока (в Linux — pthread_t), с которым работают системные API:

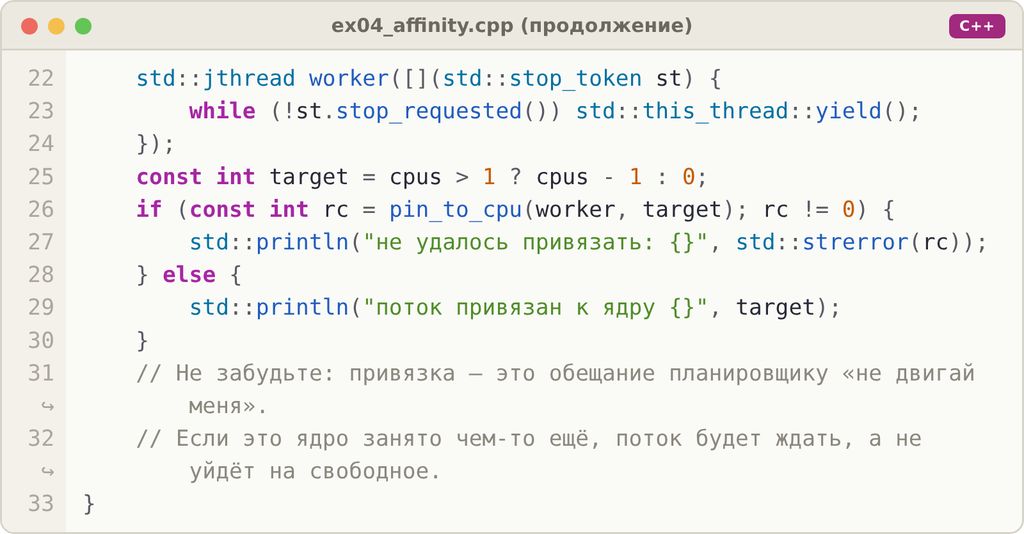
Листинг 4.8 — привязка потока к ядру через native_handle() (ex04_affinity.cpp)
Когда привязка (affinity) полезна:
— задачи с жёсткими требованиями к задержкам: поток на изолированном ядре не вытесняется и не теряет кеши (подробнее о real-time — в главе 12);
— архитектура thread-per-core, где каждое ядро обслуживает свою часть данных (тоже глава 12);
— NUMA: держать поток рядом с его памятью.
Когда вредна — почти во всех остальных случаях. Планировщик Linux неплохо балансирует нагрузку сам. Привязанный поток не может уйти на свободное ядро, если его ядро занято. Привязка, которая дала +10% на бенчмарке, может дать −50% в продакшене, где рядом крутятся другие процессы.
Про приоритеты: обычные политики планирования Linux (SCHED_OTHER) почти не дают гарантий; real-time политики (SCHED_FIFO, SCHED_RR) дают, но требуют прав и аккуратности — поток с real-time приоритетом в бесконечном цикле может заморозить систему. Это тема главы 12.
4.8. fork() в многопоточном процессе
fork() создаёт копию процесса. Но в дочернем процессе оказывается только один поток — тот, который вызвал fork(). Все остальные потоки просто исчезают. А память, включая состояние всех мьютексов, копируется как есть.
Сценарий катастрофы:
1. Поток A захватил мьютекс внутри malloc (у аллокатора есть внутренние блокировки).
2. Поток B в этот момент вызывает fork().
3. В дочернем процессе мьютекс аллокатора «захвачен», но потока A, который должен его отпустить, там нет.
4. Дочерний процесс вызывает malloc и зависает навсегда.
То же самое с любыми мьютексами: логгер, пул соединений, ваш собственный кеш.
Правило: в многопоточном процессе после fork() в дочернем процессе можно вызывать только async-signal-safe функции до вызова exec(). Фактически — только сразу заменить процесс через exec. Если нужно запустить внешнюю программу, используйте posix_spawn() — он сделан именно для этого. Если нужен fork без exec (например, для снапшота памяти, как в Redis), делайте его до создания потоков или проектируйте систему так, чтобы дочерний процесс не трогал ничего, что могло быть захвачено.
4.9. Сигналы и потоки
Сигналы — механизм UNIX, придуманный задолго до потоков. В многопоточной программе с ними три проблемы.
Кому достанется сигнал. Процессно-направленный сигнал (например, SIGTERM от kill) доставляется любому потоку, у которого он не заблокирован. Какому именно — решает ядро.
Обработчик прерывает поток в произвольной точке. Например, посреди malloc или посреди критической секции с захваченным мьютексом. Поэтому внутри обработчика сигнала можно вызывать только async-signal-safe функции (их список есть в man signal-safety): никакого malloc, никакого printf, никаких мьютексов. Если обработчик попытается захватить мьютекс, который уже держит прерванный поток, это мгновенный дедлок: прерванный поток не продолжится, пока не закончится обработчик.
Что можно сделать в обработчике. Почти ничего: записать в переменную типа volatile std::sig_atomic_t или в lock-free std::atomic, и выйти. Это единственный законный случай для volatile в многопоточной теме (подробнее в главе 5).
Правильный шаблон: выделенный поток сигналов
Вместо асинхронных обработчиков используем синхронное ожидание:
1. в самом начале main, до создания любых потоков, блокируем нужные сигналы через pthread_sigmask. Маска сигналов наследуется, поэтому все потоки, созданные дальше, тоже их блокируют;
2. создаём выделенный поток, который ждёт сигналы через sigwait (или sigtimedwait);
3. sigwait возвращает номер сигнала как обычное значение функции, и дальше это обычный код: можно брать мьютексы, логировать, аллоцировать;
4. поток сигналов переводит сигнал в понятный остальной программе механизм — например, request_stop() на общем stop_source.


Листинг 4.9 — сигналы в многопоточной программе (ex05_signal_thread.cpp)
Почему sigtimedwait, а не sigwait: чтобы поток сигналов мог выйти сам, когда программа завершается по другой причине (например, из-за фатальной ошибки). sigwait ждал бы вечно, и деструктор jthread повис бы на join.
Рабочие потоки при этом ничего не знают о сигналах — только о stop_token. Это правильное разделение: обработка ОС-специфичных событий в одном месте, остальной код переносим.
4.10. Грабли с ревью
— Массив счётчиков или структур «по одной на поток» без выравнивания.
— Выравнивание всего подряд «на всякий случай» — память и кеш тоже не бесплатные.
— Код, который полагается на порядок операций с памятью без синхронизации («на x86 же работает»).
— Один горячий мьютекс на весь сервис и надежда, что ядра помогут.
— Привязка потоков к ядрам без замеров в реальном окружении.
— fork() без немедленного exec() в многопоточной программе.
— printf, malloc, мьютексы или логирование внутри обработчика сигнала.
— Обработка сигналов через signal() в многопоточной программе вместо выделенного потока.
4.11. Что спросят на собеседовании
Что такое false sharing и как его найти? (middle/senior) Разные потоки пишут в разные переменные в одной кеш-линии, линия прыгает между ядрами. Найти — профилировщиком (perf c2c на Linux) или по симптому «нет общих данных, а не масштабируется». Лечить — разносить по линиям.
Что такое кеш-линия и почему это важно для многопоточности? (middle) Единица обмена между памятью и кешем (обычно 64 байта); когерентность работает на уровне линий, поэтому записи соседних данных разными ядрами конфликтуют.
Почему процессор может переставить операции с памятью? (senior) Store buffer, внеочередное исполнение, оптимизации компилятора. x86 переставляет store-load, ARM почти всё. Модель памяти C++ абстрагирует это.
Сколько стоит мьютекс? (senior) Без конкуренции — атомарная операция в пространстве пользователя (futex), при конкуренции — системные вызовы и переключение контекста. Проблема в конкуренции, а не в мьютексе.
Что говорит закон Амдала? (middle) Последовательная доля ограничивает ускорение. Бонус: Густафсон и разница вопросов.
Чем опасен fork() в многопоточной программе? (senior) В дочернем процессе только один поток, мьютексы, захваченные другими потоками, остаются захваченными навсегда. Только exec сразу после fork, или posix_spawn.
Как правильно обрабатывать SIGTERM в многопоточном сервере? (senior) Заблокировать сигналы до создания потоков, выделенный поток с sigwait, перевод в stop_token. Обработчики сигналов — только с async-signal-safe функциями.
4.12. Сквозной проект shardkv, шаг 4: шарды, кеш-линии и SIGTERM
Что делаем:
— разбиваем хранилище на N шардов (по умолчанию 16), ключ попадает в шард по хешу;
— каждый шард — бывший Storage из шага 3 со своим мьютексом, своей хеш-таблицей и своей кучей дедлайнов;
— мьютекс шарда — shared_mutex: GET и TTL берут разделяемый захват;
— шарды выровнены по кеш-линии, чтобы мьютексы соседних шардов не попадали в одну линию;
— остановка сервера по SIGINT/SIGTERM через выделенный поток сигналов вместо Enter в консоли.
Что проверяем: все тесты прошлых шагов (API хранилища не изменился); SIGTERM под нагрузкой приводит к чистому завершению под TSan.
Что меряем: глобальный мьютекс (шаг 3) против 1 шарда против 16 шардов, на смешанной нагрузке и на одном горячем ключе.
Шард

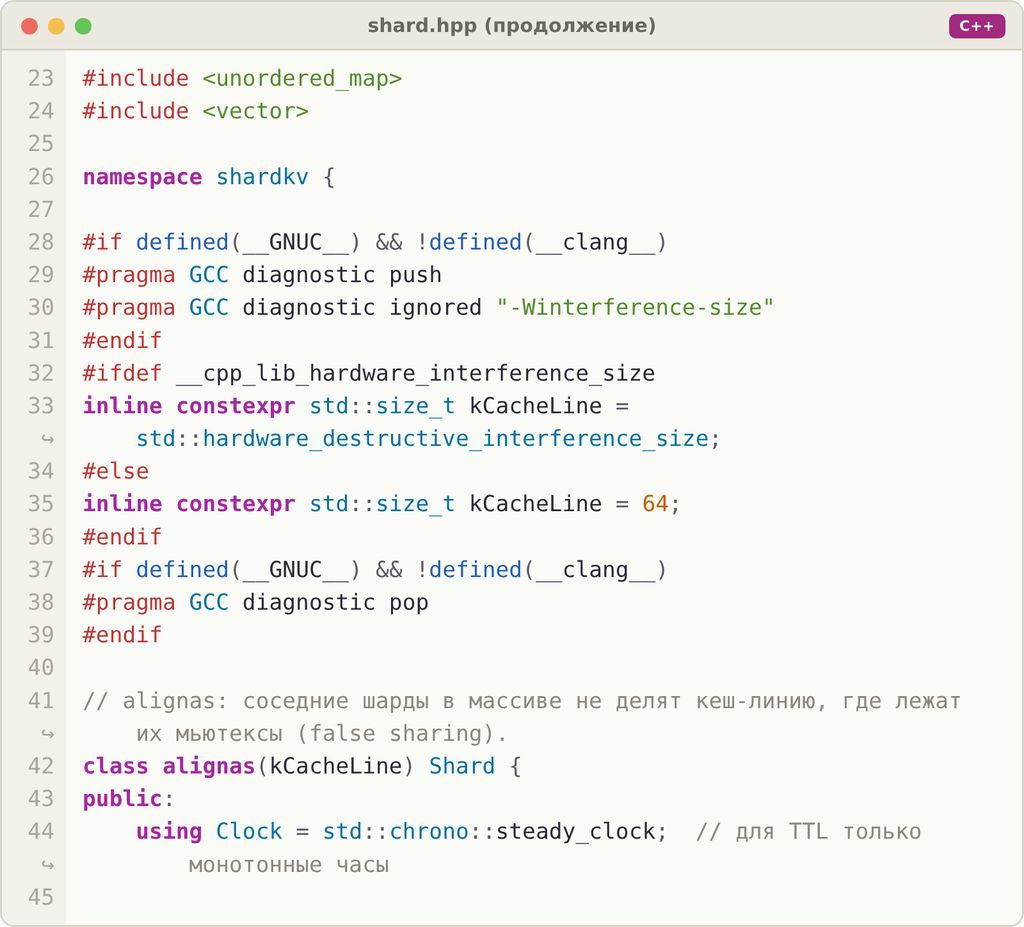
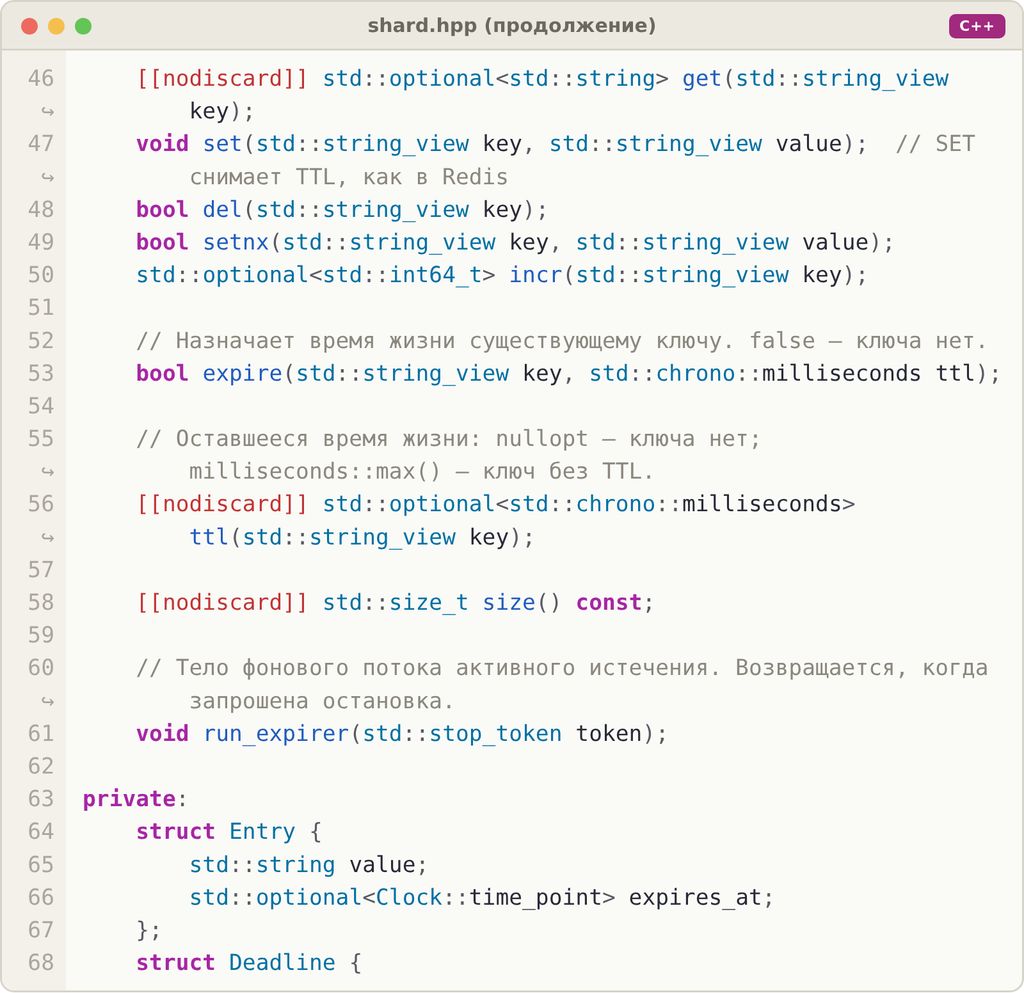


Листинг 4.10 — один шард хранилища shardkv (шаг 4) (shard.hpp)
Главное изменение в реализации — GET с разделяемым захватом:
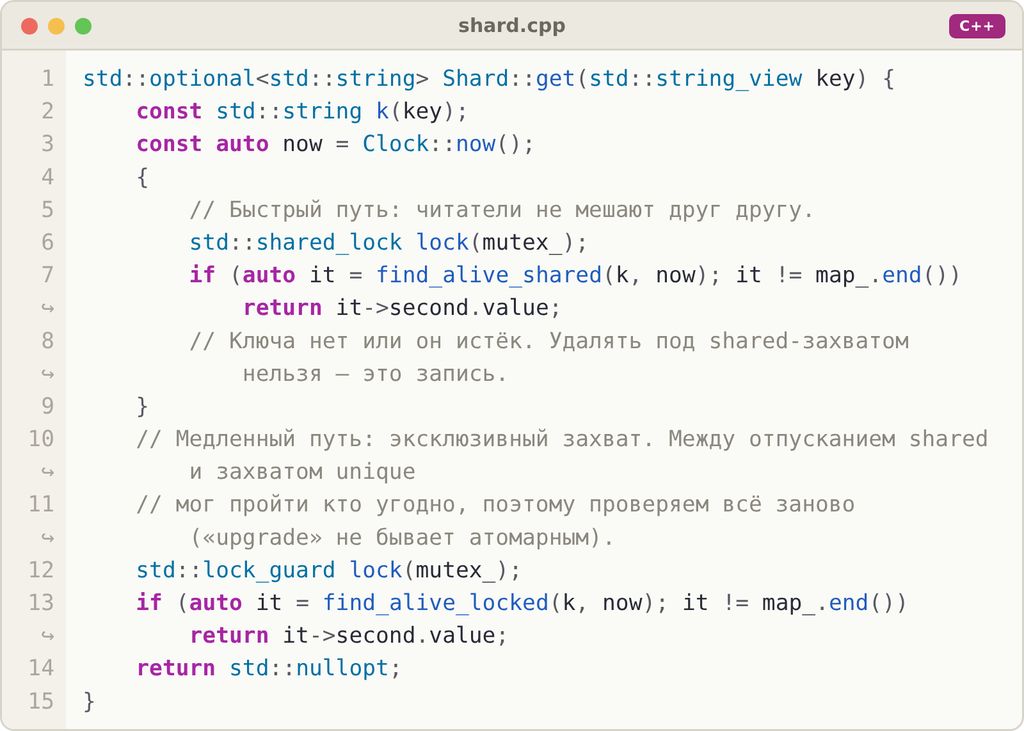
Листинг 4.11 — GET с разделяемым захватом (shard.cpp)
Это важный приём, который стоит запомнить: повышение разделяемого захвата до эксклюзивного не бывает атомарным. Между освобождением shared_lock и захватом unique_lock другой поток может изменить что угодно, поэтому после захвата всё проверяется заново. Классическая ошибка — проверить под shared_lock, отпустить, захватить unique_lock и действовать на основе первой проверки.
Полный код shard.cpp — в архиве главы; он отличается от storage.cpp шага 3 только этим и разделяемыми захватами в ttl() и size().
Фасад хранилища


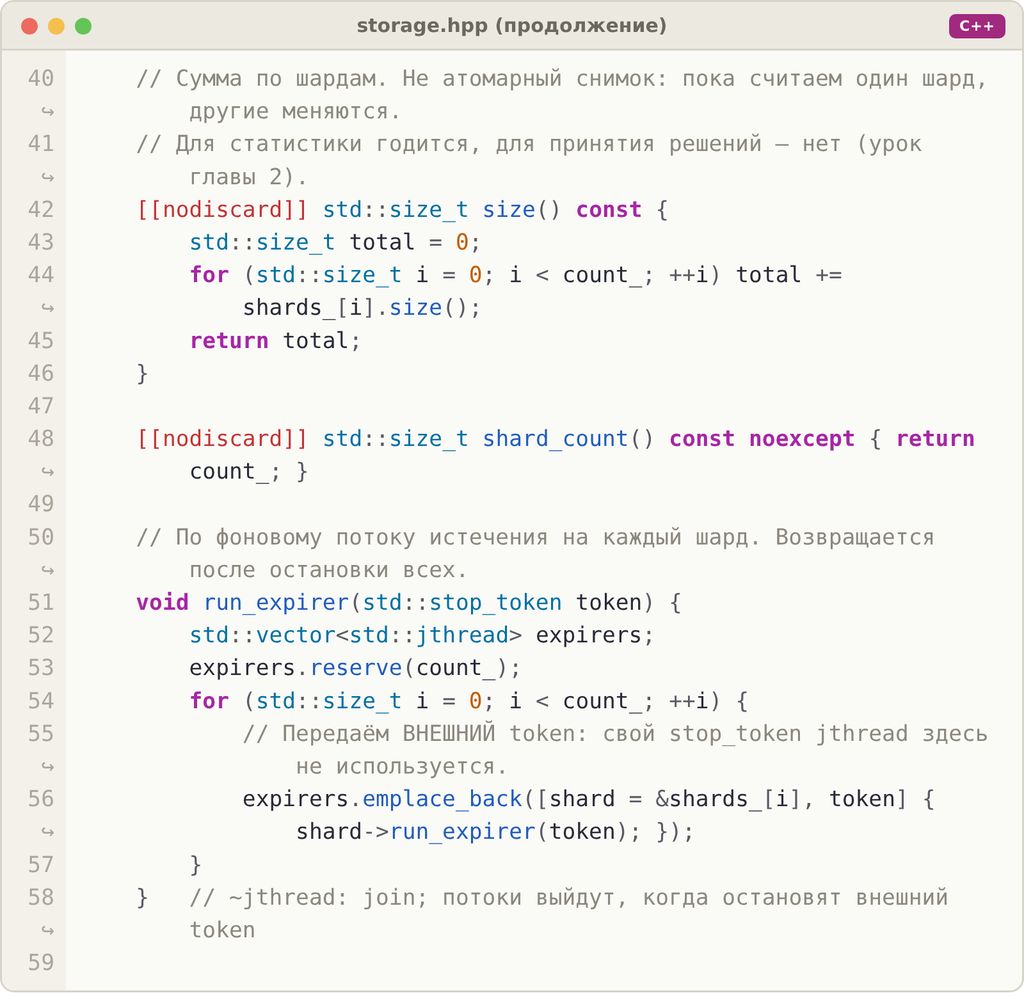
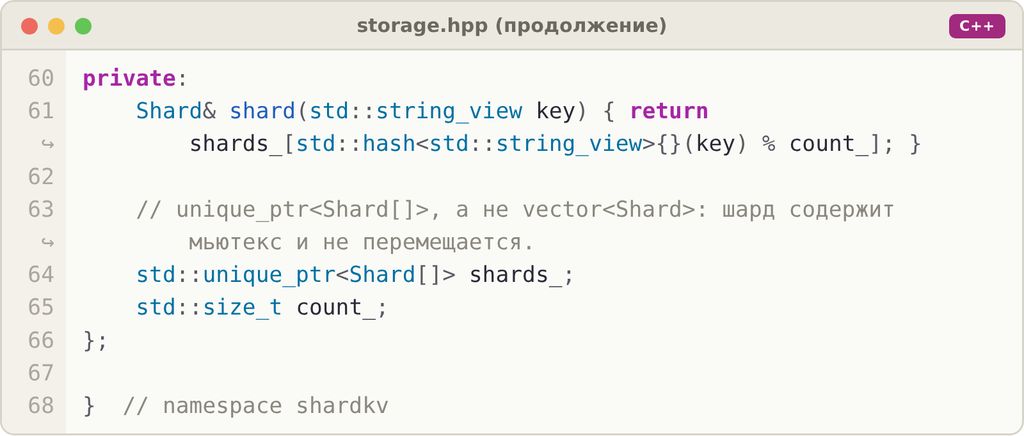
Листинг 4.12 — хранилище shardkv, шаг 4 (storage.hpp)
Обратите внимание:
— шарды лежат в std::unique_ptr<Shard[]>, а не в std::vector: шард содержит мьютекс и не может перемещаться, а vector требует перемещаемых элементов при росте;
— size() суммирует шарды по очереди — это не атомарный снимок, а статистика. Урок главы 2: такие методы нельзя использовать для принятия решений;
— run_expirer запускает по потоку на шард. 16 потоков, которые почти всегда спят, — нормальная цена. Если шардов станет 1024, это решение придётся пересмотреть.
Остановка по сигналу

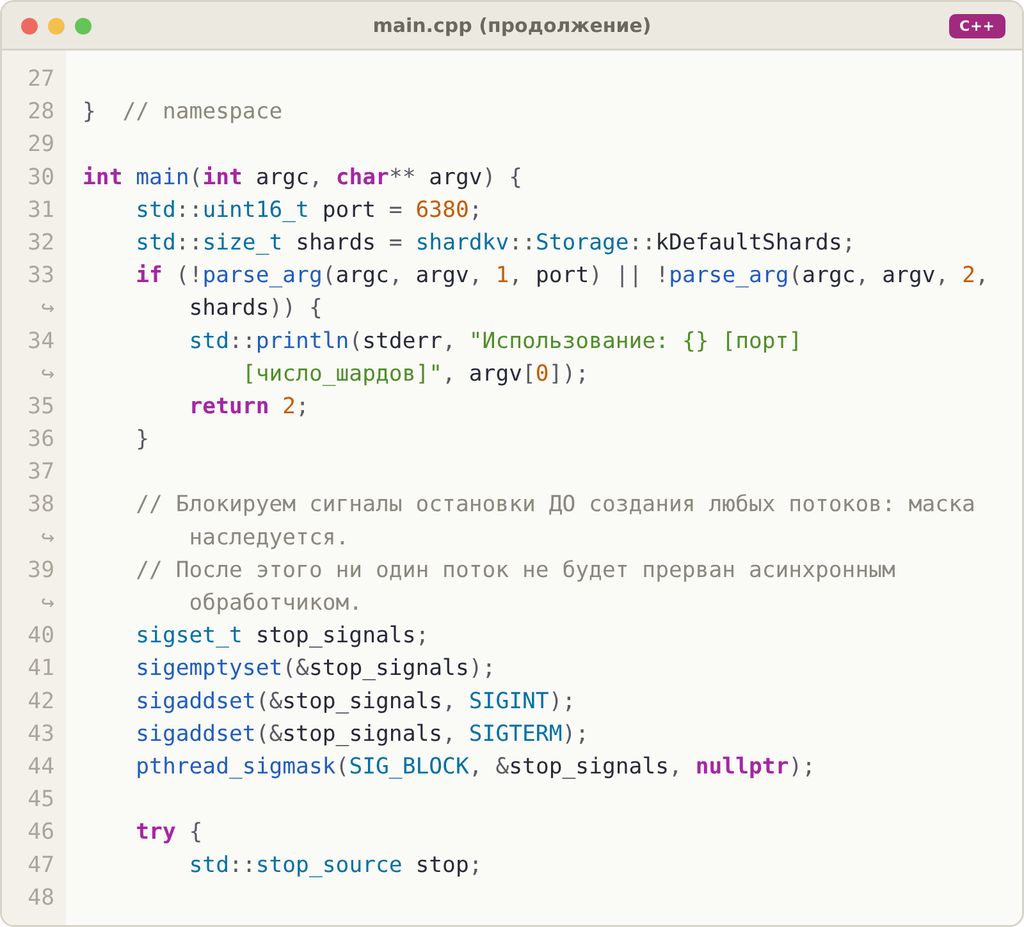


Листинг 4.13 — точка входа shardkv, шаг 4 (main.cpp)
Сервер теперь работает в главном потоке: server.run() вернётся после остановки. Поток сигналов выходит и при получении сигнала, и при остановке по другой причине — его цикл проверяет общий stop_source.
Проверка под нагрузкой: сервер в сборке tsan, 4 клиента kvbench по 200 000 запросов, через секунду kill -TERM:

Листинг 4.14 — остановка сервера по SIGTERM
TSan молчит, код возврата 0. kvbench, естественно, сообщает, что все 4 клиента потеряли соединение: сервер остановился посреди их работы.
Bepul matn qismi tugad.